按时间顺序运行的实验在整个实验过程中响应会经历线性漂移,这是相当常见的情况。如果您将运行顺序随机化,那么这种漂移的影响不会倾向于对估计的因子效应造成偏差,但会增加这些效应的方差。
有没有比随机运行顺序更好的选择?
我通常会建议调查人员随机化他们的运行顺序,或者至少在同类运行组(区块)内随机化顺序。但是,如果有理由怀疑响应随时间呈现强烈的线性趋势,而与因子变化无关,那么还有更好的方法。
这个更好的方法是什么?
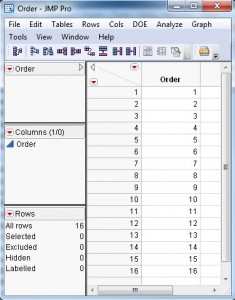
在之前的一篇文章中,我描述了如何将协变量因子添加到实验中。在这种情况下,可以将时间(或运行顺序)视为协变量因子。为了使设计对趋势具有稳健性,首先创建一个只有一列的数据表。您可以将其称为“顺序”。为了使这个例子具体化,我将创建一个 16 次运行的实验。因此,我的协变量因子 Order 数据表有 16 行,按顺序排列数字 1 到 16。我保存了我的表并将其命名为 Order.jmp。
接下来,我打开自定义设计器并添加顺序作为协变量因子。为了举例说明,我还添加了七个连续因子,并将它们命名为 A 到 G。图 1 显示了输入因子后的自定义设计界面。假设模型包含所有因子的主效应。
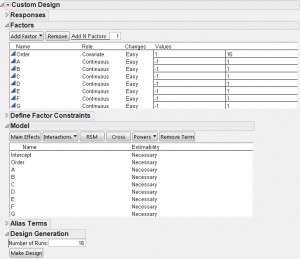
我想要最高效的设计,所以我进入红色三角形菜单并选择“启动次数”项。此选项控制设计师从随机起始设计开始的次数,以尝试找到最佳设计。我选择了 100,000 次随机启动,这在我的笔记本电脑上花了 33 秒。
图 2 显示了我创建的设计的相关性颜色图。因子 A 到 G 彼此正交。顺序与 A、B、E 和 F 正交。它与 C、D 和 G 相关,但相关性仅为 0.0271。这些相关性导致相关主效应的方差膨胀小于 0.1%。
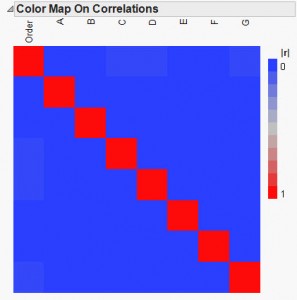
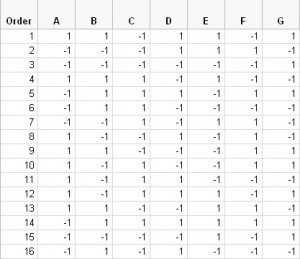
表 2 显示了每次运行的运行顺序和因子设置。
结论
并非总能像本例一样使运行顺序与因子效应如此接近正交。但是,即使运行顺序列与设计中的其他列之间存在更显著的相关性,将运行顺序作为数据分析中的一个因子也会解释任何线性趋势效应,并允许精确估计其他因子效应。