什么是别名矩阵?当我创建设计时,我通常首先要评估设计的地方是相关性色图。希望我看到很多蓝色,这意味着不同项之间的正交性。相关性色图包含模型项和别名项。如果您已经进行过实验设计/线性回归类,您可能熟悉这样的想法,即预测因子之间的相关性会增加估计的标准误差。然而,大多数熟悉的设计诊断都与模型项有关。如果我们的模型中遗漏了某些项怎么办?毫不奇怪,如果我们在模型中缺少项,这些项仍然会影响我们的结果。幸运的是,我们确实有办法评估别名项列表中指定的那些项。
缺失项对模型估计值有何影响?
我们将在下文中深入探讨技术细节,但要点是,模型中不存在的有效项可能会对模型中项的估计产生偏差。如果在别名项列表中指定了缺失项,则别名矩阵为我们提供了一种量化该偏差的方法。别名矩阵的行对应于每个模型效应,而列表示不同的别名项以及它们如何影响每个模型效应的效应估计的预期值。
如果你曾经上过线性回归课程,那么下面的模型可能看起来很熟悉:

其中Y是响应向量,  模型系数向量,以及
 随机误差向量,我们假设它以零为中心。我们将X称为模型矩阵,其中行表示实验的运行,列对应于基于设计中因子设置的模型项设置。在自定义设计中,您可以通过选择红色三角形下的“保存 X 矩阵”将模型矩阵保存到数据表中。要估计模型系数向量,最小二乘估计(拟合模型下的标准最小二乘选项)是

假设模型正确,  是无偏估计
 。 那是,

预期价值 是
 。
但是如果我们的模型缺少一些项怎么办?这些项可能会在分析数据后出现,但理想情况下,我们可以在设计阶段考虑这一点。这就是别名矩阵发挥作用的地方。这些不在我们的模型中但可能影响响应的项集称为别名项。让Z对应于别名项集的模型矩阵,其对应效应向量 也就是说, Z的解释与X相同,但对于我们没有估计的项。现在,假设模型实际上是

但我们仍然使用 X 来拟合模型。经过一些线性代数运算后,我们发现

我们称之为 别名矩阵。如果
 为 0,表示指定的别名项均不会影响响应,那么
 仍然是无偏的。如果元素
 不可忽略,那么我们希望A的条目尽可能小。
A的行对应于模型中的效应,而列对应于别名项。A中的元素告诉您模型效应(行标签)可能在多大程度上受到活动别名项(列标签)的偏差。
你能给个例子吗?
下图是相关性彩色图和别名矩阵,用于四因子、12 次运行设计的模型,用于估计主效应并使用双因子交互作用作为别名项。
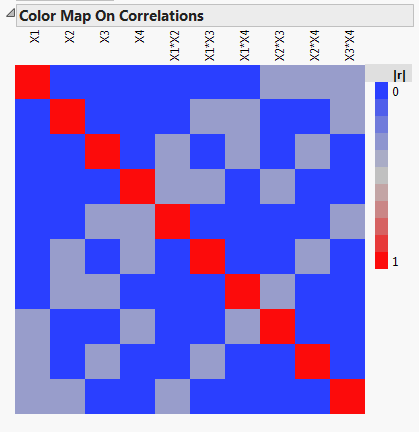
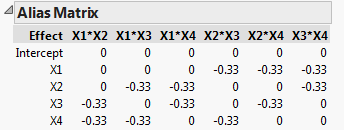
我们看到主效应是正交的,因此设计是 D 最优的,估计主效应的置信区间尽可能小。别名矩阵表明双因子相互作用会使主效应的估计值产生偏差。例如,我们看到 X1 的主效应受到双因子相互作用 X2*X3、X2*X4 和 X3*X4 的偏差,偏差幅度为它们的 -1/3。如果实际上,X1 的主效应 以及 X2*X3 的双因子交互作用,
 ,估计
 给出
 具有预期值:

也就是说,X1 的估计量的期望值现在是一个有偏估计。在这个例子中,X1 的主效应的期望值为 0,这表明 X1 不会影响响应。
偏见也可能朝另一个方向发展。如果 ,那么预期值
 是 2,是其真实值的两倍。因此,根据混叠项的方向,您可能会错过活跃的主效应,或者错误地认为可忽略的主效应是活跃的。
事情真的有那么糟糕吗?
一般而言,主效应比相互作用更可能显著,并且当主效应显著时,其量级往往更大。但是,随着因子数量的增加,可能的相互作用的数量也会迅速增加。如果许多双因子相互作用产生的偏差确实令人担忧,而您又没有足够的资源将这些项添加到模型中,那么您可以选择 Alias Optimal 设计。
我的下一篇博文将讨论别名最优设计并展示其在减少偏差方面优于 D 最优设计。
