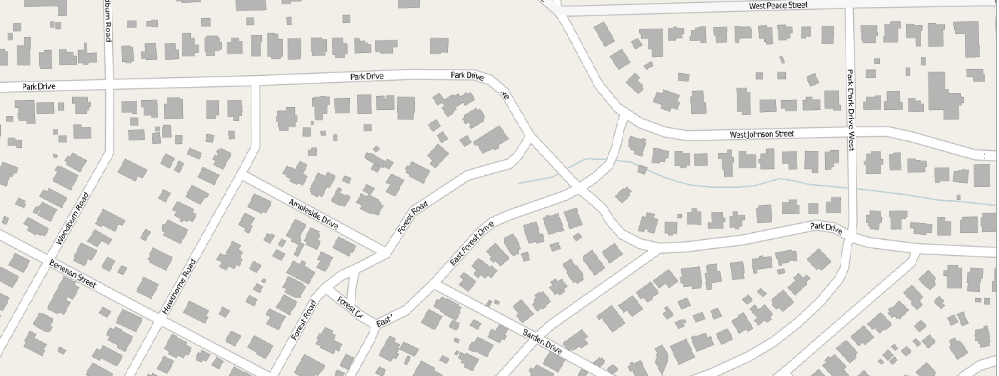
Hier ist eine 2D-Nachbarschaft.(Dank an JMPs OpenStreetMap Verbindung!) Sie können sich eine 1D vorstellen Nachbarschaft zu, aber 1D ist nicht sehr interessant.
Und Sie können sich ein 3D-Viertel in einer Stadt mit Hochhäusern vorstellen; Jeder Ihrer Nachbarn erhält Breiten-, Längen- und Höhenkoordinaten.Eine interessante Frage in jedem nD-Raum (n > 0) ist: "Wer ist mein nächster Nachbar?"Auf einer 2D-Karte können die nächsten Nachbarn problemlos identifiziert werden.Aber was ist, wenn sich alle Breiten-, Längen- und Höhenangaben in einer Datentabelle befinden?Mit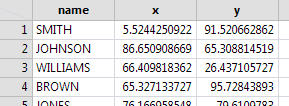 eine Reihe pro Nachbar?Hier ist eine 2D-Tabelle mit 1000 Zeilen.Eine Möglichkeit, SMITHs nächsten Nachbarn zu finden, wäre, seine Entfernung zu jedem anderen Nachbarn zu berechnen, die Entfernungen zu sortieren und die kleinste auszuwählen.Nicht schlecht, wenn man es nur einmal machen muss.Aber bei weitem nicht so befriedigend, als auf die 2D-Karte von SMITHs Haus zu schauen und nur seinen nächsten Nachbarn zu sehen.(Interessante Tatsache: Wenn Fred Joes nächster Nachbar ist, ist Joe möglicherweise nicht Freds nächster Nachbar.Nächste-Nachbar-Ketten bilden das Herzstück der "schnellen Ward-Methode" der Clustering-Plattform.)
Es gibt einen besseren Weg, um die nächsten Nachbarn zu finden, wenn die Frage für viele Personen in der Tabelle beantwortet werden muss.Das 1D-Problem "ist nicht sehr interessant", weil die Häuser bereits in einer Reihe angeordnet sind und durch einmaliges Sortieren der Daten der nächste Nachbar zu jedem in der Reihe gefunden werden kann, indem die Entfernung zu nur zwei anderen Nachbarn betrachtet wird ...die beiden Nachbarn von nebenan.Gibt es eine Möglichkeit, die 2D-Zeilen in der Datentabelle einmal zu sortieren, sodass der Nachbar auf der anderen Straßenseite und der Nachbar hinter der Hintertür genauso einfach gefunden werden können wie die beiden Nachbarn von nebenan?Gleichzeitig nach X und Y sortieren?Ja...
Die KDTable-Funktion von JMP erstellt ein JSL-Objekt aus K-Dimensional-Daten für die effiziente Suche nach nächsten Nachbarn.Es lässt das nD-Problem wie das 1D-Problem aussehen, was ziemlich befriedigend ist.Eine KD-Tabelle wird aus einer Matrix mit K Spalten konstruiert (K ist die Anzahl der Dimensionen ... 2 für die Beispieltabelle der Nachbarn, 3 für Hochhausbewohner.) Jede Zeile in der Matrix ist ein Punkt im K-dimensionalen Raum (1000 Nachbarn im Beispiel.) Um die KDTable aus der Datentabelle zu erstellen, nehmen Sie einfach die x- und y-Spalten als Matrizen und verwenden Sie die || Matrixverkettung, um die beiden 1000x1-Spaltenvektoren in eine 1000x2-Matrix umzuwandeln:
dt = Open( "$desktop/RandomNameLocation.jmp" );
mat = (dt:x << getvalues) || (dt:y << getvalues);
Show( N Rows( mat ), N Cols( mat ) );
kdt = KDTable( mat );
N Zeilen (Matte) = 1000;
N Cols(mat) = 2;
Kdt ist die JSL-Variable, die das KDTable-Objekt enthält.Das Objekt hat mehrere Methoden; << KNearestRows ist am interessantesten:
kdt<<K nearest="" rows=""></K>
{[984 169], [0.684553526256623 2.00033962590788]}
Das erste Argument, 2, fordert die 2 nächsten Zeilen an, und das zweite Argument, 1, ist die Zeile (Zeile von SMITH), mit der sie verglichen werden sollen.Der zurückgegebene Wert ist eine Liste mit zwei Matrizen.Die erste Matrix identifiziert die beiden Reihen (984 ist CARNEY und 169 ist RICE.)Hier sind sie:
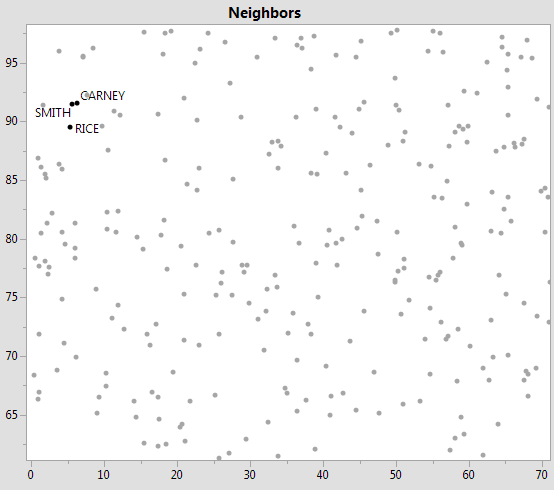
CARNEY ist eindeutig näher dran als RICE.Dies ist die einfachste Art, die Methode K Nearest Rows zu verwenden – mit einer tatsächlichen Zeilennummer in der Tabelle.Es ist auch möglich, eine beliebige K-dimensionale Koordinate als Matrix aus 1 Zeile und K Spalten zu verwenden.Es ist auch möglich, das letzte Argument wegzulassen, in diesem Fall enthält die zurückgegebene Liste Matrizen mit dem nächsten Nachbarn/Abstand für jede Zeile (1000 für das Beispiel).
Die KDTable gibt sehr schnell den nächsten Nachbarn zurück.Es dauert etwas länger, den nächsten Nachbarn zu entdecken, und so weiter.Das Setzen des ersten Arguments auf 999 gibt tatsächlich eine sortierte Liste aller nächsten Nachbarn zurück und läuft schnell genug für insgesamt 1000 Zeilen, aber denken Sie daran - die Tabelle ist hervorragend darin, die nächsten Nachbarn zu finden, nicht weit entfernte Nachbarn.
Da die Verlangsamung mit der Entfernung beginnt, kann das erste Argument (das die zurückgegebene Anzahl der Nachbarn begrenzt) zusätzlich zur Anzahl der Nachbarn mit einer Radiusbegrenzung angegeben werden.Zum Beispiel,
kdt<<K nearest="" rows=""></K>
{[984 169 745 403 506 772 977 864 12 0], [0,684553526256623 2,00033962590788
2,27070259974598 3,94275990709721 4,20575097464916 4,29873200846626 4,6027795012889
4.82632837039104 5.48011662134314 0]}
fragt nach bis zu 20 Zeilen, bis zu einem Radius von 5. Zeile 12 hat einen Radius von 5,4 und stoppt die Suche nach nur 9 Nachbarn
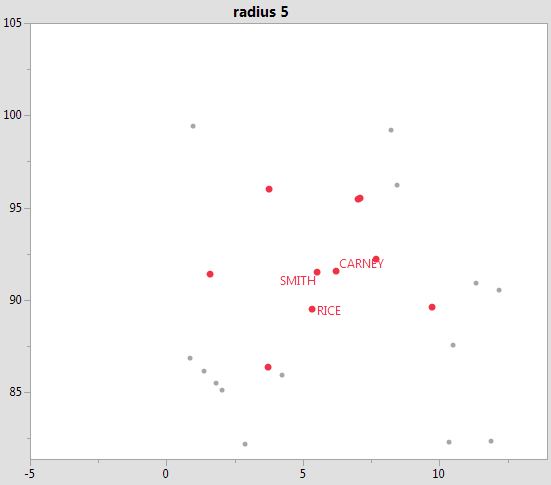 gewesen sein gefunden.Der Nullwächter am Ende ist keine gültige Zeilennummer und bedeutet, dass die Radiusbegrenzung die Suche gestoppt hat.In einer Wolke aus 1.000.000 Punkten mit ungleichmäßiger Verteilung kann die Abfrage der 20 nächsten Nachbarn in dicht besiedelten Gebieten schnell und am Stadtrand langsam sein.Das Festlegen einer angemessenen Radiusbegrenzung kann den Unterschied zwischen einer trägen Reaktion und einer bissigen Reaktion ausmachen.
Das KDTable-Objekt sollte einmal erstellt und dann immer wieder verwendet werden.Die interne Datenstruktur der KDTable wird so schnell wie möglich erstellt, aber es ist viel, viel schneller, ihr nach dem Erstellen Fragen zu Nachbarn zu stellen.
Es gibt zwei Skripte, Wolken Und Spinnen , um die Verwendung der KDTable-Funktion weiter zu erläutern.Beide sind interaktiv (ziehen Sie das kleine weiße Quadrat).Das Punktwolkenbeispiel kann für mehr Punkte in der Wolke bearbeitet werden (zwei Millionen sind nicht zu viele) und das Spinnenbeispiel hat ein Kontrollkästchen, um es gruselig zu machen.Und das Video im Post von letzter Woche verwendet KDTable, viel.
Update 08.10.2018: Formatierung reparieren
