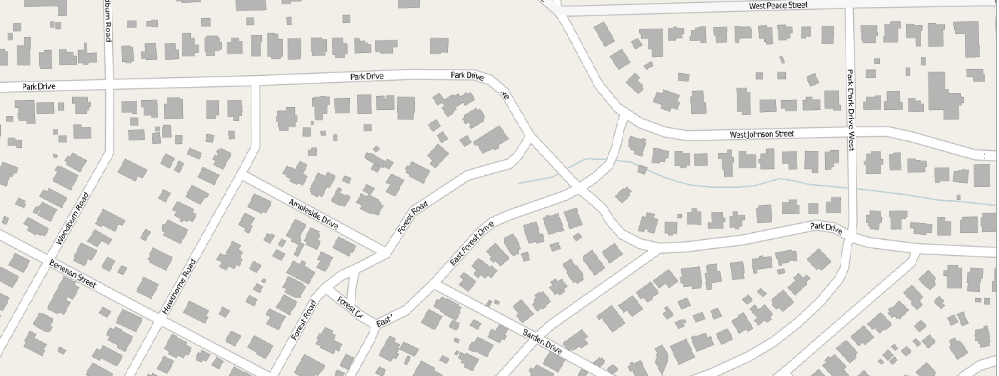
これが 2D 近傍です。(JMPのおかげでOpenStreetMap接続!) 1D を想像できます近所それも、しかし、1D はあまり面白くありません。
また、高層ビルが立ち並ぶ都市の 3D 近隣を想像することもできます。各隣人は、緯度、経度、高度の座標を取得します。任意の nD (n > 0) 空間での興味深い質問は、「私の最も近い隣人は誰ですか?」です。最近傍は 2D マップ上でそれほど問題なく識別できます。しかし、すべての緯度、経度、高度がデータ テーブルにある場合はどうなるでしょうか。と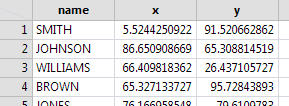 隣人ごとに1行?これは、1000 行の 2D テーブルです。SMITH の最近傍を見つける 1 つの方法は、他のすべての近傍との距離を計算し、距離を並べ替えて、最小のものを選択することです。一度だけ行う必要がある場合は、それほど悪くはありません。しかし、SMITH の家の 2D マップを見て、最も近い隣人を見るのと同じくらい満足できるものではありません。(興味深い事実: Fred が Joe の最も近い隣人である場合、Joe は Fred の最も近い隣人ではない可能性があります。Nearest Neighbor チェーンは、クラスタリング プラットフォームの「fast Ward メソッド」の中心を形成します。)
テーブル内の多くの人に対して質問に答える必要がある場合は、最近傍を見つけるためのより良い方法があります。1D の問題は「あまり興味深いものではありません」。なぜなら、家はすでに一列に並べられており、データを並べ替えるだけで、他の 2 つの隣人までの距離を見るだけで、列内の誰かに最も近い隣人を見つけることができるからです。 ...隣の二人。データ テーブルの 2D 行を 1 回並べ替える方法はありますか?X と Y で同時に並べ替えますか?はい...
JMP の KDTable 関数は、最近傍を効率的に検索するために、K 次元データから JSL オブジェクトを作成します。これにより、nD 問題が 1D 問題のように見えます。これはかなり満足のいくものです。KDTable は、K 列の行列から作成されます (K は次元の数です...隣人のテーブルの例では 2、高層住宅の場合は 3 です)。行列の各行は、K 次元空間内の点です。 (この例では 1000 の隣人。) データ テーブルから KDTable を作成するには、x 列と y 列を行列として取得し、|| を使用します。 2 つの 1000x1 列ベクトルを 1000x2 行列に変換する行列連結:
dt = Open( "$desktop/RandomNameLocation.jmp" );
mat = (dt:x << getvalues) || (dt:y << getvalues);
Show( N Rows( mat ), N Cols( mat ) );
kdt = KDTable( mat );
N 行 (マット) = 1000;
N 列 (マット) = 2;
Kdt KDTable オブジェクトを保持する JSL 変数です。オブジェクトにはいくつかのメソッドがあります。 << KNearestRows最も興味深いのは次のとおりです。
kdt<<K nearest="" rows=""></K>
{[984 169]、[0.684553526256623 2.00033962590788]}
最初の引数 2 は最も近い 2 つの行を要求し、2 番目の引数 1 はそれらを比較する行 (SMITH の行) です。戻り値は、2 つの行列のリストです。最初の行列は 2 つの行を識別します (984 は CARNEY で、169 は RICE です)。どうぞ:
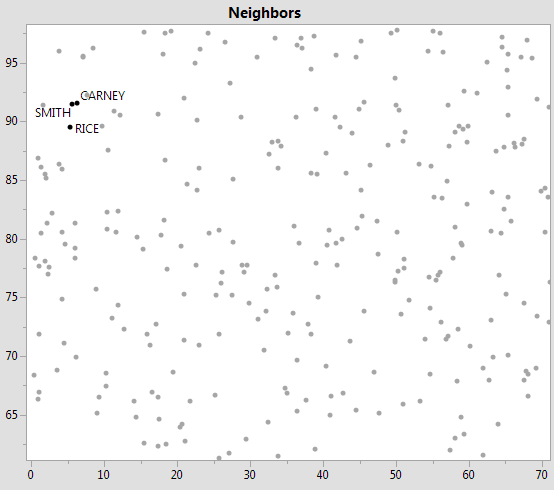
明らかに、CARNEY は RICE よりもはるかに近いです。これは、テーブル内の実際の行番号を使用して K Nearest Rows メソッドを使用する最も簡単な方法です。任意の K 次元座標を 1 行 K 列の行列として使用することもできます。最後の引数を省略することもできます。その場合、返されるリストには、各行の最近傍/距離 (例では 1000) を持つ行列が含まれます。
KDTable は、最近傍を非常に迅速に返します。次の最近傍を発見するのに少し時間がかかります。実際、最初の引数を 999 に設定すると、すべての最近傍のソートされたリストが返され、合計で 1000 行を処理するのに十分な速度で実行されますが、覚えておいてください。
スローダウンは距離から始まるため、最初の引数 (返される近隣の数を制限する) は、近隣の数に加えて半径制限で指定できます。例えば、
kdt<<K nearest="" rows=""></K>
{[984 169 745 403 506 772 977 864 12 0]、[0.684553526256623 2.00033962590788
2.27070259974598 3.94275990709721 4.20575097464916 4.29873200846626 4.6027795012889
4.82632837039104 5.48011662134314 0]}
半径 5 までの最大 20 行を要求します。行 12 は半径 5.4 にあり、近隣が 9 つになった時点で検索を停止します。
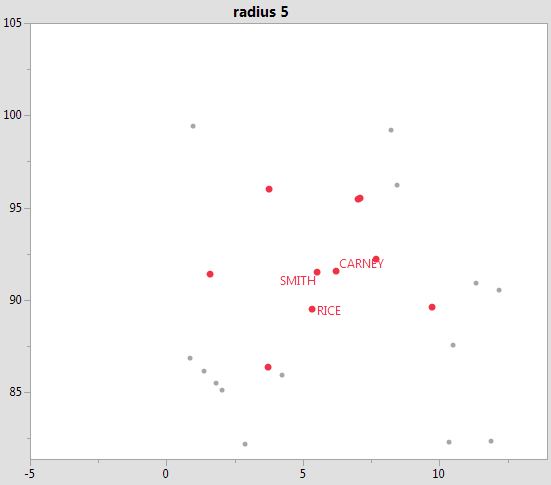 なっている見つかった。末尾のゼロ標識は有効な行番号ではなく、半径制限により検索が停止したことを意味します。一様でない分布を持つ 1,000,000 ポイントのクラウドでは、20 個の最近傍を求めると、人口密度の高い地域では速く、郊外では遅くなる可能性があります。妥当な半径制限を設定することで、反応が遅い場合と反応が速い場合の違いを生むことができます。
KDTable オブジェクトは、一度構築してから繰り返し使用する必要があります。KDTable の内部データ構造は可能な限り高速に構築されますが、構築後にネイバーについて質問する方がはるかに高速です。
2つのスクリプトがあり、雲とクモ、KDTable 関数の使用方法をさらに説明します。どちらもインタラクティブです (小さな白い四角形をドラッグします)。ポイント クラウドの例では、クラウド内のより多くのポイントを編集できます (200 万は多すぎません)。クモの例には、不気味にするためのチェック ボックスがあります。そしてその先週の投稿のビデオKDTable をよく使いました。
2018 年 10 月 8 日更新: フォーマットの修復
<meta http-equiv="Content-Type" content="text/html; charset=UTF-8" />とてもかっこいい! しかし、「評価」用の新しい列を追加して、隣人を評価します。 それから、私が好きな最寄の隣人を見つけることができました!
