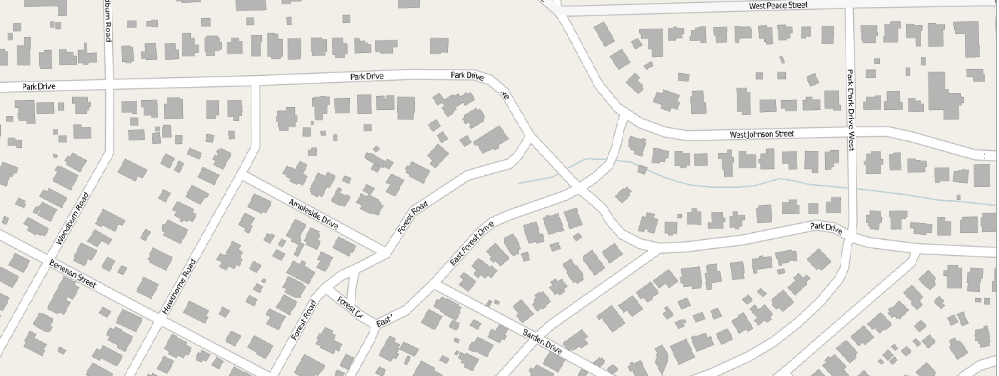
Voici un quartier 2D.(Merci à JMP OpenStreetMap connexion!) Vous pouvez imaginer un 1D quartier aussi, mais 1D n'est pas très intéressant.
Et vous pouvez imaginer un quartier en 3D dans une ville avec des immeubles de grande hauteur ; chacun de vos voisins obtient une latitude, une longitude et une altitude.Une question intéressante dans n'importe quel espace nD (n > 0) est "qui est mon voisin le plus proche ?"Les voisins les plus proches peuvent être identifiés sur une carte 2D sans trop de problèmes.Mais que se passe-t-il si toutes les latitudes, longitudes et altitudes sont dans une table de données ?Avec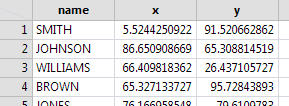 une rangée par voisin ?Voici un tableau 2D avec 1000 lignes.Une façon de trouver le voisin le plus proche de SMITH serait de calculer sa distance par rapport à tous les autres voisins, de trier les distances et de choisir la plus petite.Pas trop mal, si vous n'avez besoin de le faire qu'une seule fois.Mais pas aussi satisfaisant que de regarder la carte 2D de la maison de SMITH et de voir son voisin le plus proche.(Fait intéressant : si Fred est le voisin le plus proche de Joe, Joe n'est peut-être pas le voisin le plus proche de Fred.Les chaînes de voisins les plus proches forment le cœur de la "méthode rapide Ward" de la plate-forme de clustering.)
Il existe un meilleur moyen de trouver les voisins les plus proches, si la question doit être répondue pour beaucoup de personnes dans la table.Le problème 1D "n'est pas très intéressant" car les maisons sont déjà ordonnées en ligne, et en triant les données, une seule fois, le voisin le plus proche de n'importe qui dans la ligne peut être trouvé en regardant la distance à seulement deux autres voisins ...les deux voisins de palier.Existe-t-il un moyen de trier les lignes 2D dans la table de données, une fois, afin que le voisin d'en face et le voisin de derrière puissent être trouvés aussi facilement que les deux voisins d'à côté ?Trier simultanément par X et Y ?Oui...
La fonction KDTable de JMP crée un objet JSL à partir de données K-Dimensional pour rechercher efficacement les voisins les plus proches.Cela fait ressembler le problème nD au problème 1D, ce qui est assez satisfaisant.Une KDTable est construite à partir d'une matrice avec K colonnes (K est le nombre de dimensions... 2 pour l'exemple de table de voisins, 3 pour les habitants de grande hauteur.) Chaque ligne de la matrice est un point dans l'espace à K dimensions (1000 voisins dans l'exemple.) Pour créer le KDTable à partir de la table de données, saisissez simplement les colonnes x et y comme matrices et utilisez le || concaténation matricielle pour transformer les deux vecteurs colonnes 1000x1 en une matrice 1000x2 :
dt = Open( "$desktop/RandomNameLocation.jmp" );
mat = (dt:x << getvalues) || (dt:y << getvalues);
Show( N Rows( mat ), N Cols( mat ) );
kdt = KDTable( mat );
N lignes(tapis) = 1000 ;
N Cols(mat) = 2 ;
Kdt est la variable JSL qui contient l'objet KDTable.L'objet a plusieurs méthodes ; << KNearestRows est le plus intéressant :
kdt<<K nearest="" rows=""></K>
{[984 169], [0,684553526256623 2,00033962590788]}
Le premier argument, 2, demande les 2 lignes les plus proches, et le deuxième argument, 1, est la ligne (la ligne de SMITH) à laquelle les comparer.La valeur renvoyée est une liste de deux matrices.La première matrice identifie les deux lignes (984 est CARNEY et 169 est RICE.)Les voici:
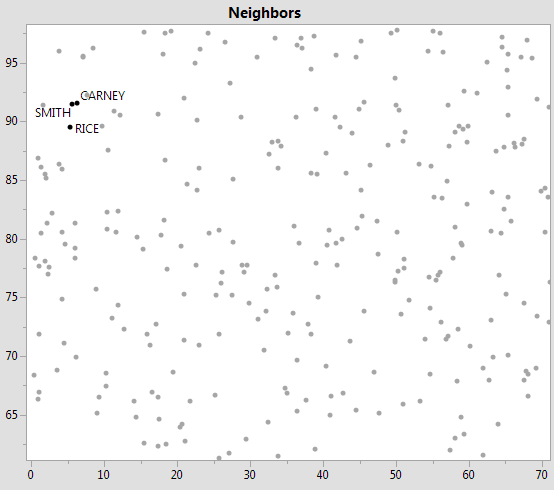
De toute évidence, CARNEY est beaucoup plus proche que RICE.C'est la manière la plus simple d'utiliser la méthode K Nearest Rows - avec un numéro de ligne réel dans la table.Il est également possible d'utiliser une coordonnée K-dimensionnelle arbitraire comme matrice de 1 ligne et K colonnes.Il est également possible d'omettre le dernier argument, auquel cas la liste renvoyée contiendra des matrices avec le plus proche voisin/distance pour chaque ligne (1000 pour l'exemple.)
La KDTable renvoie très rapidement le voisin le plus proche.Le prochain voisin le plus proche prend un peu plus de temps à découvrir, et ainsi de suite.Définir le premier argument sur 999 renverra en fait une liste triée de tous les voisins les plus proches et s'exécutera assez rapidement pour 1000 lignes au total, mais rappelez-vous que la table excelle à trouver les voisins les plus proches, pas les voisins éloignés.
Étant donné que le ralentissement commence par la distance, le premier argument (qui limite le nombre de voisins renvoyé) peut être spécifié avec une limite de rayon en plus du nombre de voisins.Par exemple,
kdt<<K nearest="" rows=""></K>
{[984 169 745 403 506 772 977 864 12 0], [0,684553526256623 2,00033962590788
2.27070259974598 3.94275990709721 4.20575097464916 4.29873200846626 4.6027795012889
4.82632837039104 5.48011662134314 0]}
demande jusqu'à 20 lignes, jusqu'à un rayon de 5. La ligne 12 est à un rayon de 5,4 et arrête la recherche après seulement 9 voisins
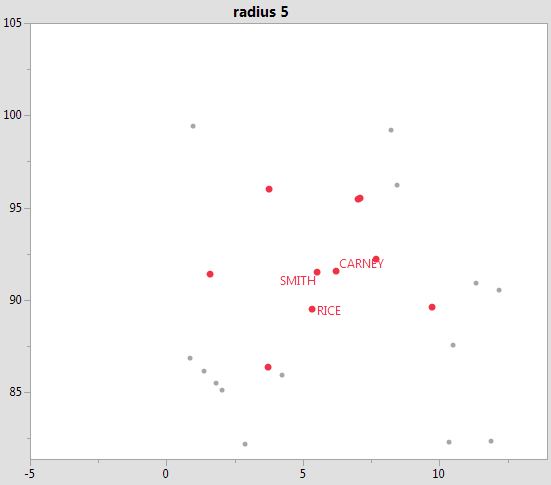 ont été trouvé.La sentinelle zéro à la fin n'est pas un numéro de ligne valide et signifie que la limite de rayon a arrêté la recherche.Dans un nuage de 1 000 000 points avec une distribution non uniforme, demander les 20 voisins les plus proches peut être rapide dans les zones densément peuplées et lent en périphérie.Mettre une limite de rayon raisonnable peut faire la différence entre une réponse lente et une réponse rapide.
L'objet KDTable doit être construit une fois, puis utilisé encore et encore.La structure de données interne de la KDTable se construit aussi vite que possible, mais il est beaucoup, beaucoup plus rapide de lui poser des questions sur les voisins après sa construction.
Il y a deux scripts, des nuages et araignées , pour expliquer plus en détail comment utiliser la fonction KDTable.Les deux sont interactifs (faites glisser le petit carré blanc).L'exemple de nuage de points peut être modifié pour plus de points dans le nuage (deux millions n'est pas trop) et l'exemple d'araignée a une case à cocher pour le rendre effrayant.Et le vidéo dans le post de la semaine dernière beaucoup utilisé KDTable.
Mise à jour du 8 octobre 2018 : réparer le formatage
