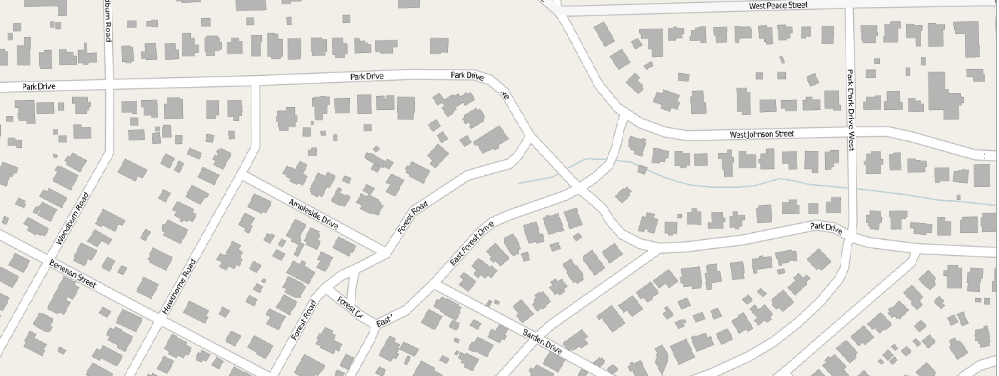
다음은 2D 이웃입니다.(JMP 덕분에 오픈스트리트맵 연결!) 1D를 상상할 수 있습니다. 이웃 도, 하지만 1D는 그다지 흥미롭지 않습니다.
그리고 고층 건물이 있는 도시의 3D 이웃을 상상할 수 있습니다. 각 이웃은 위도, 경도 및 고도 좌표를 얻습니다.모든 nD(n > 0) 공간에서 흥미로운 질문은 "가장 가까운 이웃은 누구입니까?"입니다.가장 가까운 이웃은 큰 문제 없이 2D 지도에서 식별할 수 있습니다.하지만 모든 위도, 경도, 고도가 데이터 테이블에 있으면 어떻게 될까요?와 함께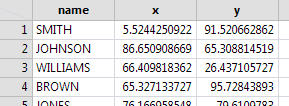 이웃당 한 행?다음은 1000개의 행이 있는 2D 테이블입니다.SMITH의 가장 가까운 이웃을 찾는 한 가지 방법은 다른 모든 이웃까지의 거리를 계산하고 거리를 정렬한 다음 가장 작은 것을 선택하는 것입니다.한 번만 하면 된다면 나쁘지 않습니다.그러나 SMITH의 집에 대한 2D 지도를 보고 그의 가장 가까운 이웃을 보는 것만큼 만족스럽지는 않습니다.(흥미로운 사실: Fred가 Joe의 가장 가까운 이웃이라면 Joe는 Fred의 가장 가까운 이웃이 아닐 수도 있습니다.가장 가까운 이웃 체인은 클러스터링 플랫폼의 "빠른 와드 방법"의 핵심을 형성합니다.)
테이블에 있는 많은 사람들이 질문에 답해야 하는 경우 가장 가까운 이웃을 찾는 더 좋은 방법이 있습니다.1D 문제는 집들이 이미 일렬로 정렬되어 있고 데이터를 한 번만 정렬하면 다른 두 이웃과의 거리를 보고 가장 가까운 이웃을 찾을 수 있기 때문에 "별로 흥미롭지 않습니다". ...옆집 두 이웃.데이터 테이블의 2D 행을 한 번 정렬하여 길 건너 이웃과 뒷문 밖 이웃을 두 옆집 이웃처럼 쉽게 찾을 수 있는 방법이 있습니까?X와 Y로 동시에 정렬하시겠습니까?예...
JMP의 KDTable 함수는 가장 가까운 이웃을 효율적으로 찾기 위해 K차원 데이터에서 JSL 객체를 생성합니다.그것은 nD 문제를 1D 문제처럼 보이게 하는데, 꽤 만족스럽습니다.KDTable은 K개의 열이 있는 행렬로 구성됩니다(K는 차원 수...이웃 테이블의 경우 2, 고층 거주자의 경우 3). 행렬의 각 행은 K차원 공간의 한 점입니다. (이 예에서는 1000개의 이웃) 데이터 테이블에서 KDTable을 만들려면 x 및 y 열을 행렬로 잡고 || 두 개의 1000x1 열 벡터를 1000x2 행렬로 바꾸는 행렬 연결:
dt = Open( "$desktop/RandomNameLocation.jmp" );
mat = (dt:x << getvalues) || (dt:y << getvalues);
Show( N Rows( mat ), N Cols( mat ) );
kdt = KDTable( mat );
N 행(매트) = 1000;
N Cols(매트) = 2;
KDT KDTable 개체를 보유하는 JSL 변수입니다.개체에는 여러 메서드가 있습니다. << KNearest 행 가장 흥미로운:
kdt<<K nearest="" rows=""></K>
{[984169], [0.684553526256623 2.00033962590788]}
첫 번째 인수 2는 가장 가까운 2개의 행을 요청하고 두 번째 인수 1은 비교할 행(SMITH의 행)입니다.반환된 값은 두 행렬의 목록입니다.첫 번째 행렬은 두 행을 식별합니다(984는 CARNEY이고 169는 RICE입니다.).여기 있습니다:
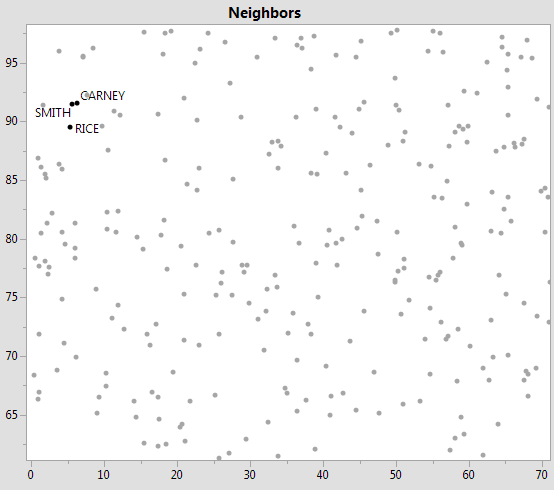
분명히 CARNEY는 RICE보다 훨씬 가깝습니다.이것은 테이블의 실제 행 번호와 함께 K Nearest Rows 방법을 사용하는 가장 간단한 방법입니다.임의의 K차원 좌표를 1행 K열의 행렬로 사용하는 것도 가능하다.마지막 인수를 생략할 수도 있습니다. 이 경우 반환된 목록에는 모든 행에 대해 가장 가까운 이웃/거리가 있는 행렬이 포함됩니다(예: 1000).
KDTable은 가장 가까운 이웃을 매우 빠르게 반환합니다.다음으로 가장 가까운 이웃은 발견하는 데 시간이 조금 더 걸립니다.첫 번째 인수를 999로 설정하면 실제로 모든 가장 가까운 이웃의 정렬된 목록이 반환되고 총 1000개의 행에 대해 충분히 빠르게 실행되지만 기억하세요. 이 테이블은 멀리 떨어진 이웃이 아니라 가장 가까운 이웃을 찾는 데 탁월합니다.
속도 저하가 거리에서 시작되기 때문에 반환되는 이웃 수를 제한하는 첫 번째 인수는 이웃 수 외에 반경 제한으로 지정할 수 있습니다.예를 들어,
kdt<<K nearest="" rows=""></K>
{[984 169 745 403 506 772 977 864 12 0], [0.684553526256623 2.00033962590788
2.27070259974598 3.94275990709721 4.20575097464916 4.29873200846626 4.6027795012889
4.82632837039104 5.48011662134314 0]}
최대 20개 행, 최대 반경 5를 요청합니다. 행 12는 반경 5.4이며 이웃이 9개만 있으면 검색을 중지합니다.
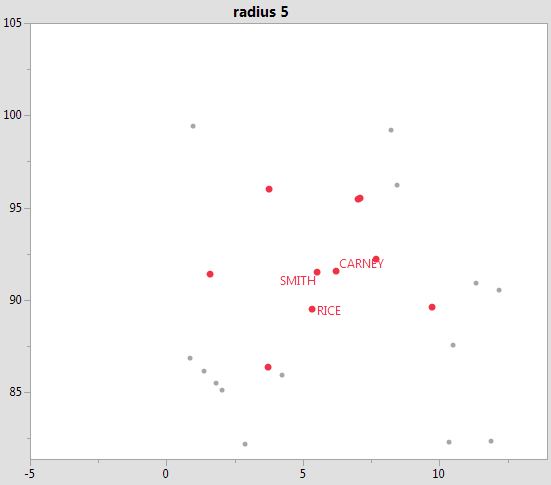 해왔다 설립하다.끝에 있는 0 센티넬은 유효한 행 번호가 아니며 반경 제한이 검색을 중지했음을 의미합니다.분포가 균일하지 않은 1,000,000개의 포인트 클라우드에서 가장 가까운 이웃 20개를 요청하는 것은 인구 밀도가 높은 지역에서는 빠르고 외곽 지역에서는 느릴 수 있습니다.합리적인 반경 제한을 두는 것은 느린 응답과 빠른 응답 사이의 차이를 만들 수 있습니다.
KDTable 개체는 한 번 구성한 다음 계속해서 사용해야 합니다.KDTable의 내부 데이터 구조는 최대한 빨리 구축되지만 구축된 후 이웃에 대해 질문하는 것이 훨씬 더 빠릅니다.
두 개의 스크립트가 있으며, 구름 그리고 거미 , KDTable 기능을 사용하는 방법을 자세히 설명합니다.둘 다 대화식입니다(작은 흰색 사각형 드래그).포인트 클라우드 예제는 클라우드의 더 많은 포인트에 대해 편집할 수 있으며(2백만은 너무 많지 않음) 스파이더 예제에는 오싹하게 만드는 확인란이 있습니다.그리고 지난 주 게시물의 비디오 KDTable을 많이 사용했습니다.
2018년 10월 8일 업데이트: 서식 복구
<meta http-equiv="Content-Type" content="text/html; charset=UTF-8" />아주 멋지다! 그러나 "등급"에 대한 새 열을 추가하고 이웃을 평가합니다. 그러면 내가 좋아하는 가장 가까운 이웃을 찾을 수 있습니다!
