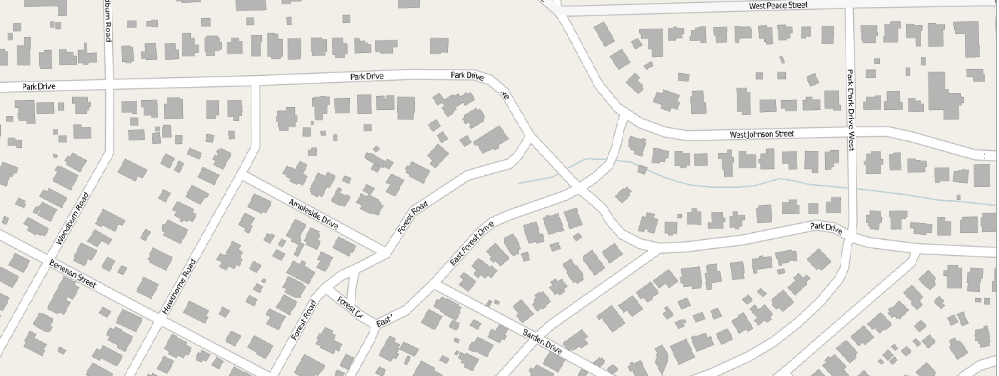
Aquí hay un vecindario 2D.(Gracias a JMP OpenStreetMap conexión!) Puedes imaginar un 1D vecindario también, pero 1D no es muy interesante.
Y puedes imaginar un barrio en 3D en una ciudad con edificios de gran altura; cada uno de sus vecinos obtiene una coordenada de latitud, longitud y altitud.Una pregunta interesante en cualquier espacio nD (n > 0) es "¿quién es mi vecino más cercano?"Los vecinos más cercanos se pueden identificar en un mapa 2D sin demasiados problemas.Pero, ¿y si todas las latitudes, longitudes y altitudes están en una tabla de datos?Con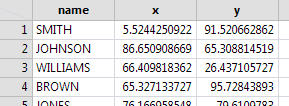 una fila por vecino?Aquí hay una tabla 2D con 1000 filas.Una forma de encontrar al vecino más cercano de SMITH sería calcular su distancia a todos los demás vecinos, clasificar las distancias y elegir la más pequeña.No está mal, si solo necesitas hacerlo una vez.Pero no tan satisfactorio como mirar el mapa 2D de la casa de SMITH y simplemente ver a su vecino más cercano.(Dato interesante: si Fred es el vecino más cercano de Joe, Joe podría no ser el vecino más cercano de Fred.Las cadenas de vecinos más cercanos forman el corazón del "método Fast Ward" de la plataforma de agrupamiento).
Hay una mejor manera de encontrar a los vecinos más cercanos, si la pregunta debe ser respondida por muchas personas en la mesa.El problema 1D "no es muy interesante" porque las casas ya están ordenadas en una línea, y al ordenar los datos, solo una vez, se puede encontrar el vecino más cercano a cualquiera en la línea al mirar la distancia a solo otros dos vecinos. ...los dos vecinos de al lado.¿Hay alguna manera de ordenar las filas 2D en la tabla de datos, una vez, para que el vecino del otro lado de la calle y el vecino de la puerta de atrás se puedan encontrar tan fácilmente como los dos vecinos de al lado?¿Ordenar simultáneamente por X e Y?Sí...
La función KDTable de JMP crea un objeto JSL a partir de datos K-Dimensional para buscar de manera eficiente a los vecinos más cercanos.Hace que el problema nD se parezca al problema 1D, lo cual es bastante satisfactorio.Una KDTable se construye a partir de una matriz con K columnas (K es el número de dimensiones... 2 para la tabla de vecinos de ejemplo, 3 para los habitantes de edificios altos). Cada fila de la matriz es un punto en el espacio de K dimensiones. (1000 vecinos en el ejemplo). Para hacer la KDTable a partir de la tabla de datos, simplemente tome las columnas x e y como matrices y use el || concatenación de matrices para convertir los dos vectores de columna de 1000x1 en una matriz de 1000x2:
dt = Open( "$desktop/RandomNameLocation.jmp" );
mat = (dt:x << getvalues) || (dt:y << getvalues);
Show( N Rows( mat ), N Cols( mat ) );
kdt = KDTable( mat );
N filas (tapete) = 1000;
N Cols(tapete) = 2;
kdt es la variable JSL que contiene el objeto KDTable.El objeto tiene varios métodos; << KFilas más cercanas es lo mas interesante:
kdt<<K nearest="" rows=""></K>
{[984 169], [0.684553526256623 2.00033962590788]}
El primer argumento, 2, solicita las 2 filas más cercanas, y el segundo argumento, 1, es la fila (la fila de SMITH) para compararlas.El valor devuelto es una lista de dos matrices.La primera matriz identifica las dos filas (984 es CARNEY y 169 es ARROZ).Aquí están:
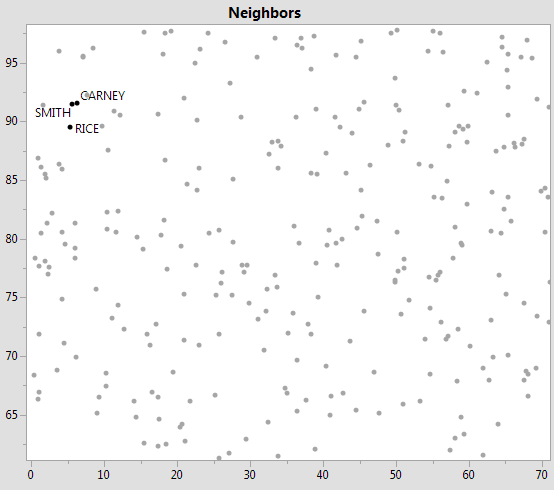
Claramente, CARNEY está mucho más cerca que RICE.Esta es la forma más sencilla de utilizar el método K filas más cercanas, con un número de fila real en la tabla.También es posible utilizar una coordenada K-dimensional arbitraria como matriz de 1 fila y K columnas.También es posible omitir el último argumento, en cuyo caso la lista devuelta contendrá matrices con el vecino/distancia más cercano para cada fila (1000 para el ejemplo).
KDTable devuelve el vecino más cercano muy rápidamente.El siguiente vecino más cercano tarda un poco más en descubrirse, y así sucesivamente.Establecer el primer argumento en 999 devolverá, de hecho, una lista ordenada de todos los vecinos más cercanos y se ejecutará lo suficientemente rápido para 1000 filas en total, pero recuerde: la tabla es excelente para encontrar los vecinos más cercanos, no los vecinos lejanos.
Debido a que la desaceleración comienza con la distancia, el primer argumento (que limita el número de vecinos devuelto) se puede especificar con un límite de radio además del número de vecinos.Por ejemplo,
kdt<<K nearest="" rows=""></K>
{[984 169 745 403 506 772 977 864 12 0], [0,684553526256623 2,00033962590788
2.27070259974598 3.94275990709721 4.20575097464916 4.29873200846626 4.6027795012889
4.82632837039104 5.48011662134314 0]}
pide hasta 20 filas, hasta un radio de 5. La fila 12 está en un radio de 5,4 y detiene la búsqueda después de solo 9 vecinos
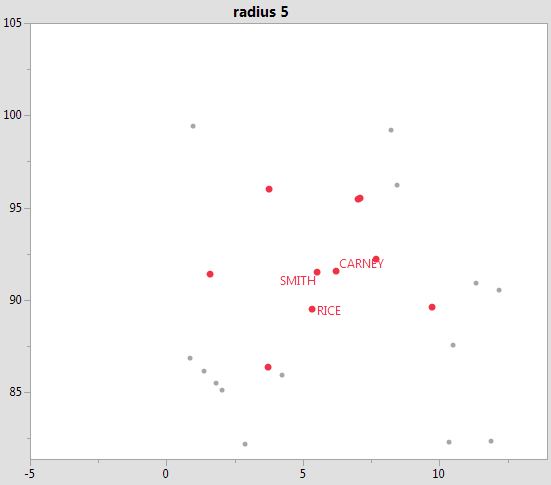 ha sido encontró.El centinela cero al final no es un número de fila válido y significa que el límite de radio detuvo la búsqueda.En una nube de 1.000.000 de puntos con una distribución no uniforme, preguntar por los 20 vecinos más cercanos puede resultar rápido en zonas densamente pobladas y lento en las periferias.Poner un límite de radio razonable puede marcar la diferencia entre una respuesta lenta y una respuesta rápida.
El objeto KDTable debe construirse una vez y luego usarse una y otra vez.La estructura de datos interna de KDTable se construye tan rápido como puede, pero es mucho, mucho más rápido hacerle preguntas sobre los vecinos después de construirla.
Hay dos guiones, nubes y arañas , para explicar con más detalle cómo utilizar la función KDTable.Ambos son interactivos (arrastra el pequeño cuadrado blanco).El ejemplo de la nube de puntos se puede editar para obtener más puntos en la nube (dos millones no son demasiados) y el ejemplo de la araña tiene una casilla de verificación para hacerlo espeluznante.Y el video en el post de la semana pasada Usé KDTable, mucho.
Actualización 8 de octubre de 2018: reparación de formato
