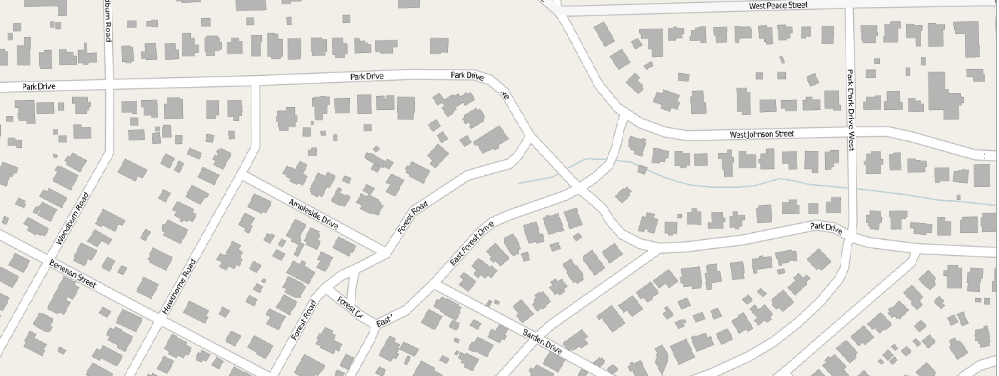
Ecco un quartiere 2D.(Grazie a JMP OpenStreetMap connessione!) Potete immaginare un 1D quartiere pure, ma 1D non è molto interessante.
E puoi immaginare un quartiere 3D in una città con grattacieli; ciascuno dei tuoi vicini ottiene una latitudine, longitudine e coordinate di altitudine.Una domanda interessante in qualsiasi spazio nD (n > 0) è "chi è il mio vicino più prossimo?"I vicini più vicini possono essere identificati su una mappa 2D senza troppi problemi.Ma cosa succede se tutte le Latitudini, Longitudini, Altitudini sono in una tabella di dati?Con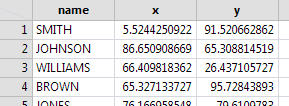 una riga per vicino?Ecco una tabella 2D con 1000 righe.Un modo per trovare il vicino più vicino di SMITH sarebbe calcolare la sua distanza da ogni altro vicino, ordinare le distanze e scegliere il più piccolo.Non male, se devi farlo solo una volta.Ma non così soddisfacente come guardare la mappa 2D della casa di SMITH e vedere solo il suo vicino più prossimo.(Fatto interessante: se Fred è il vicino più prossimo di Joe, Joe potrebbe non essere il vicino più prossimo di Fred.Le catene dei vicini più vicini costituiscono il cuore del "metodo Fast Ward" della piattaforma di clustering.)
C'è un modo migliore per trovare i vicini più vicini, se è necessario rispondere alla domanda per molte persone nel tavolo.Il problema 1D "non è molto interessante" perché le case sono già ordinate in una riga, e ordinando i dati, una sola volta, il vicino più vicino a chiunque nella riga può essere trovato guardando la distanza solo da altri due vicini ...i due vicini di casa.C'è un modo per ordinare le righe 2D nella tabella dei dati, una volta, in modo che il vicino dall'altra parte della strada e il vicino della porta sul retro possano essere trovati con la stessa facilità dei due vicini della porta accanto?Ordina contemporaneamente per X e Y?SÌ...
La funzione KDTable di JMP crea un oggetto JSL dai dati K-Dimensional per cercare in modo efficiente i vicini più vicini.Rende il problema nD simile al problema 1D, il che è abbastanza soddisfacente.Una KDTable è costruita da una matrice con K colonne (K è il numero di dimensioni...2 per la tabella di esempio dei vicini, 3 per gli abitanti dei grattacieli.) Ogni riga nella matrice è un punto nello spazio K-dimensionale (1000 vicini nell'esempio.) Per creare la tabella KDTable dalla tabella dati, basta prendere le colonne x e y come matrici e utilizzare || concatenazione di matrici per trasformare i due vettori colonna 1000x1 in una matrice 1000x2:
dt = Open( "$desktop/RandomNameLocation.jmp" );
mat = (dt:x << getvalues) || (dt:y << getvalues);
Show( N Rows( mat ), N Cols( mat ) );
kdt = KDTable( mat );
N Righe(mat) = 1000;
N Col(mat) = 2;
Kdt è la variabile JSL che contiene l'oggetto KDTable.L'oggetto ha diversi metodi; << KNearestRows è il più interessante:
kdt<<K nearest="" rows=""></K>
{[984 169], [0.684553526256623 2.00033962590788]}
Il primo argomento, 2, richiede le 2 righe più vicine e il secondo argomento, 1, è la riga (la riga di SMITH) con cui confrontarle.Il valore restituito è un elenco di due matrici.La prima matrice identifica le due righe (984 è CARNEY e 169 è RICE).Eccoli:
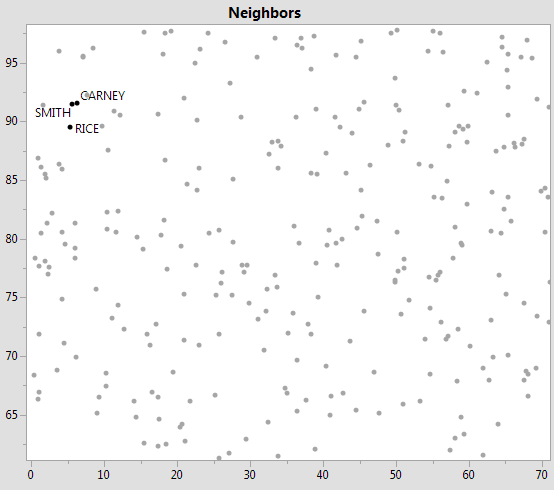
Chiaramente, CARNEY è molto più vicino di RICE.Questo è il modo più semplice per utilizzare il metodo K righe più vicine, con un numero di riga effettivo nella tabella.È anche possibile utilizzare una coordinata K-dimensionale arbitraria come matrice di 1 riga e K colonne.È anche possibile tralasciare l'ultimo argomento, nel qual caso l'elenco restituito conterrà matrici con il vicino/distanza più vicino per ogni riga (1000 per l'esempio).
KDTable restituisce molto rapidamente il vicino più vicino.Ci vuole un po' più di tempo per scoprire il prossimo vicino più prossimo, e così via.L'impostazione del primo argomento su 999 restituirà, infatti, un elenco ordinato di tutti i vicini più vicini e viene eseguito abbastanza velocemente per 1000 righe totali, ma ricorda: la tabella eccelle nel trovare i vicini più vicini, non i vicini lontani.
Poiché il rallentamento inizia con la distanza, il primo argomento (che limita il numero restituito di vicini) può essere specificato con un limite di raggio oltre al numero di vicini.Per esempio,
kdt<<K nearest="" rows=""></K>
{[984 169 745 403 506 772 977 864 12 0], [0,684553526256623 2,00033962590788
2.27070259974598 3.94275990709721 4.20575097464916 4.29873200846626 4.6027795012889
4.82632837039104 5.48011662134314 0]}
richiede fino a 20 righe, fino a un raggio di 5. La riga 12 ha un raggio di 5,4 e interrompe la ricerca dopo solo 9 vicini
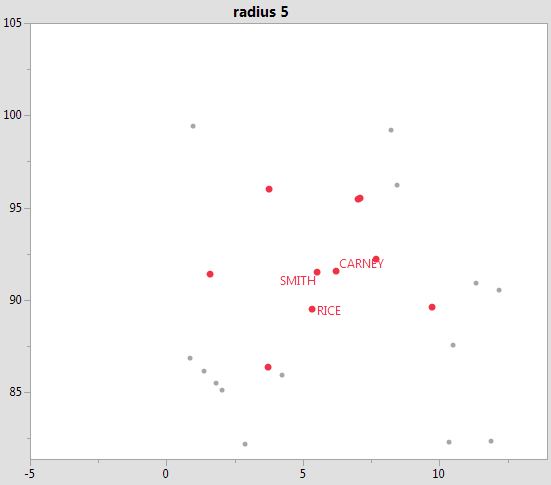 sono stato trovato.La sentinella zero alla fine non è un numero di riga valido e significa che il limite di raggio ha interrotto la ricerca.In una nuvola di 1.000.000 di punti con una distribuzione non uniforme, la richiesta dei 20 vicini più vicini può essere veloce nelle aree densamente popolate e lenta in periferia.Mettere un limite di raggio ragionevole può fare la differenza tra una risposta lenta e una risposta scattante.
L'oggetto KDTable dovrebbe essere costruito una volta, quindi utilizzato più e più volte.La struttura dati interna di KDTable si costruisce il più velocemente possibile, ma è molto, molto più veloce porre domande sui vicini dopo che è stata costruita.
Ci sono due script, nuvole E ragni , per spiegare ulteriormente come utilizzare la funzione KDTable.Entrambi sono interattivi (trascina il quadratino bianco).L'esempio della nuvola di punti può essere modificato per più punti nella nuvola (due milioni non sono troppi) e l'esempio del ragno ha una casella di controllo per renderlo inquietante.E il video nel post della scorsa settimana usato KDTable, molto.
Aggiornamento 8 ottobre 2018: riparazione della formattazione
