La colonne QbD : QbD est-il applicable au développement de méthodes analytiques ?Note de l'éditeur: Ce message est de @ronkenett et @david_s de la Groupe KPA . Il fait partie d'une série d'articles de blog appelés La chronique QbD . Pour plus d'informations sur les auteurs, cliquez sur les noms de communauté des auteurs ci-dessus.
 Ron KenettRon KenettRon KenettRon KenettRon Kenett
 David SteinbergDavid SteinbergDavid SteinbergDavid Steinberg David Steinberg
Le développement de méthodes de mesure ou d’analyse va de pair avec le développement de produits pharmaceutiques. La compréhension des exigences de surveillance et de contrôle des processus détermine les critères de performance des méthodes analytiques, y compris les attributs de qualité critiques du processus (CQA) et les limites de spécification. La découverte des caractéristiques d’une substance médicamenteuse qui nécessitent un contrôle pour garantir sa sécurité ou son efficacité détermine l’identification des CQA. Les exigences typiques des méthodes analytiques comprennent :
- Précision: Cette exigence garantit que la variabilité de la méthode ne représente qu'une petite proportion de la plage des spécifications (limite supérieure de spécification – limite inférieure de spécification). Ceci est également appelé reproductibilité et répétabilité des jauges (GR&R).
- Sélectivité : Celui-ci détermine les impuretés à surveiller à chaque étape de production et spécifie les méthodes de conception qui discriminent de manière adéquate les proportions relatives de chaque impureté.
- Sensibilité: Pour parvenir à un contrôle efficace des processus, cela nécessite des méthodes qui reflètent avec précision les changements dans les CQA qui sont importants par rapport aux limites des spécifications.
Ces critères établissent la fiabilité des méthodes à utiliser dans les opérations de routine. Cela a des implications sur le temps d’analyse, les solvants acceptables et l’équipement disponible. Pour développer une méthode analytique avec les principes QbD, les critères de performance de la méthode doivent être compris, ainsi que l'intention opérationnelle souhaitée de l'utilisateur final éventuel. Une compréhension limitée d'une méthode peut conduire à un transfert de technologie médiocre du laboratoire vers une utilisation dans des installations de fabrication commerciale ou d'une installation existante vers une nouvelle. Les transferts échoués nécessitent souvent des ressources supplémentaires importantes pour remédier aux causes de l’échec, généralement à un moment où il existe une pression considérable pour aller de l’avant avec le lancement d’un nouveau produit. L’application de la Quality by Design (QbD) aux méthodes analytiques vise à prévenir de tels problèmes. La mise en œuvre de QbD dans le développement de méthodes analytiques est généralement un processus en quatre étapes, traitant à la fois de la conception et du contrôle des méthodes. [1] . Les étapes sont :
- Intention de conception de la méthode : Identifier et préciser les performances de la méthode analytique.
- Sélection de la conception de la méthode : Sélectionnez les conditions de travail de la méthode pour atteindre l'intention de conception.
- Définition du contrôle des méthodes : Établir et définir des contrôles appropriés pour les composants contribuant le plus à la variabilité des performances.
- Validation du contrôle des méthodes : Démontrer des performances de méthode acceptables avec des contrôles robustes et efficaces.
Tester la robustesse des méthodes analytiques implique d'évaluer l'influence de petits changements dans les conditions de fonctionnement [2] . Les tests de robustesse identifient le degré de reproductibilité des résultats de test obtenus par l'analyse du même échantillon dans diverses conditions de test normales telles que différents laboratoires, analystes et instruments. Dans l'étude de cas suivante, nous nous concentrons sur l'utilisation d'expériences pour évaluer et améliorer la robustesse.
Une étude de cas sur le développement HPLC
L'étude de cas présentée ici est issue du développement d'une méthode de chromatographie liquide haute performance (HPLC). [3] . Il s’agit d’un exemple typique de test de robustesse des méthodes analytiques. Le système spécifique se compose d'un Agilent 1050, avec un détecteur UV à longueur d'onde variable et un intégrateur modèle 3396-A. L'objectif de l'étude de robustesse est de savoir si les écarts par rapport aux conditions nominales de fonctionnement affectent les résultats. Le tableau 1 répertorie les facteurs et leurs niveaux utilisés dans cette étude de cas. Le tableau expérimental est un 2 7-4 Expérience factorielle fractionnaire avec trois points centraux (voir tableau 2). Les niveaux « -1 » et « 1 » correspondent aux niveaux inférieur et supérieur répertoriés dans le tableau 1, et « 0 » correspond au niveau nominal. Les niveaux inférieur et supérieur sont choisis pour refléter les variations qui pourraient se produire naturellement par rapport au réglage nominal lors d'un fonctionnement normal. Pour des exemples d'applications QbD des expériences factorielles fractionnaires au développement de formulations et de produits pharmaceutiques, voir le deuxième et troisième articles de blog de cette série.
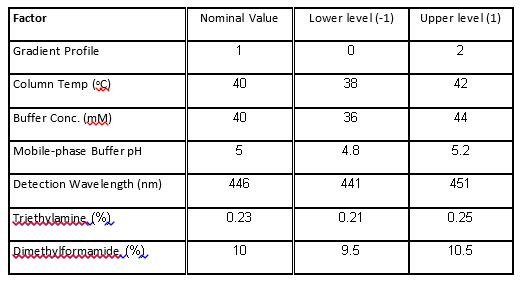
Tableau 1. Facteurs et niveaux dans l'expérience HPLC.
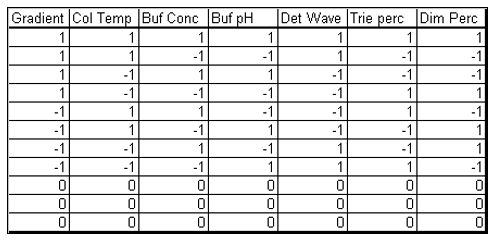
Tableau 2. Tableau expérimental de l'expérience HPLC.
Le réseau expérimental se compose de 11 essais expérimentaux qui combinent les niveaux de facteurs de conception dans un ensemble équilibré de combinaisons et de trois points centraux.
Ce que nous pouvons apprendre des expériences HPLC
En analysant l’expérience HPLC, nous avons les objectifs suivants :
- Recherchez la variance attendue de la prédiction de mesure de la méthode pour les configurations recommandées de la méthode (l'incertitude de mesure).
- Identifiez les meilleurs réglages des facteurs expérimentaux pour obtenir des performances acceptables.
- Déterminez les facteurs qui impactent les performances de la méthode sur une ou plusieurs réponses.
- Évaluer l'impact de la variabilité des facteurs expérimentaux sur les réponses mesurées.
- Renforcez la robustesse du processus HPLC en exploitant la non-linéarité des effets factoriels pour obtenir des performances qui ne sont pas sensibles aux changements de niveaux nominaux.
Si l'on considère uniquement les huit essais expérimentaux des 2 7-4 factorielle fractionnaire, sans les points centraux, nous obtenons une variance de prédiction moyenne de 0,417 et une optimalité de 100 % pour l'ajustement d'un modèle de premier ordre. Cela est dû à la propriété équilibrée de la conception (voir Figure 1 à gauche). La conception du tableau 2, avec trois points centraux, réduit l'incertitude de prévision près du centre de la région et présente une variance de prévision moyenne inférieure de 0,38. Cependant, les points centraux ne contribuent pas à l'estimation des pentes, comme le montre la moindre efficacité d'ajustement du modèle de premier ordre (voir Figure 1 à droite). 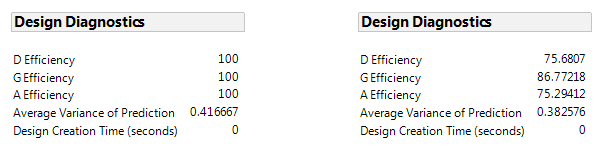
Figure 1. Concevez des diagnostics pour cette factorielle fractionnaire sans (à gauche) et avec (à droite) trois points centraux.
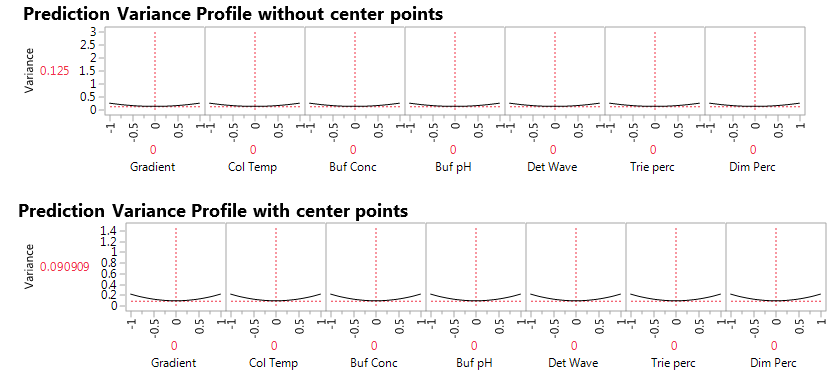
Figure 2. Profil de variance de prédiction sans (en haut) et avec (en bas) points centraux.
Le profil de variance de prédiction JMP de la figure 2 montre le rapport entre la variance de prédiction et la variance d'erreur, également appelé variance relative de prédiction, pour diverses combinaisons de niveaux de facteurs. La variance relative est minimisée au centre du plan. L'ajout de trois points centraux réduit la variance de prédiction de 25 %, de 0,12 à 0,09. Il s’agit d’un avantage obtenu en ajoutant des essais expérimentaux aux points centraux. Un autre avantage que nous verrons plus tard est que les points centraux nous permettent d'évaluer les effets non linéaires, ou le manque d'ajustement du modèle de régression linéaire. Un troisième avantage est que les points centraux nous donnent une estimation sans modèle de l’étendue de la variation naturelle du système. Pour chaque combinaison de niveaux de facteurs, les expériences ont produit cinq réponses : 1) Aire du chromatogramme au pic (peakArea), 2) Hauteur du chromatogramme au pic (peakHeight), 3) Temps de rétention minimum ajusté à la norme (tRmin), 4) Minimum non ajusté temps de rétention (unad tRmin) et 5) résolution du chromatogramme (Res). Notre première préoccupation dans l’analyse des données est d’identifier des modèles appropriés reliant les facteurs et les réponses.
Qu’apprenons-nous en analysant les données de l’expérience factorielle fractionnaire ?
Les modèles de régression linéaire sont les modèles les plus simples à considérer. Ils représentent des changements de réponses entre deux niveaux de facteurs, dans notre cas cela correspond aux niveaux étiquetés « -1 » et « +1 ». Puisque nous avons également trois points centraux, aux niveaux étiquetés « 0 », nous pouvons également évaluer les effets non linéaires. Nous le faisons, comme dans notre deuxième article de blog, en ajoutant une variable indicatrice synthétique conçue pour évaluer le manque d'ajustement (LOF) qui est égale à « 1 » aux points centraux et à « 0 » ailleurs. Le rapport de synthèse des effets JMP, pour les cinq réponses avec des effets linéaires sur les sept facteurs et l'indicateur LOF, est présenté dans la figure 3. 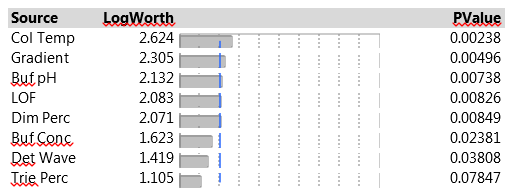
Figure 3. Effet Rapport récapitulatif de sept facteurs et indicateur LOF sur cinq réponses.
Le tableau Récapitulatif des effets répertorie les effets du modèle sur l'ensemble complet des cinq réponses, triés par valeurs p ascendantes. Le LogWorth pour chaque effet est défini comme -log10 (valeur p), qui ajuste les valeurs p pour fournir une échelle appropriée pour les graphiques. Un LogWorth supérieur à 2 est significatif au niveau 0,01 car -log10(0.01)=2. Le rapport comprend un graphique à barres du LogWorth avec des lignes verticales pointillées aux valeurs entières et une ligne de référence bleue à 2. Les valeurs p affichées correspondent au test de signification affiché dans le tableau Tests d'effet du rapport du modèle. Le rapport de la figure 3 montre que, globalement, quatre facteurs et LOF sont significatifs au niveau de 0,01 (Col Temp, Gradient, Buf PH et Dim Perc) et Buf Conc, Det Wave et Trie Perc ne sont pas significatifs. A partir du plan expérimental du tableau 2, on peut estimer les principaux effets des sept facteurs et de l'indicateur LOF sur les cinq réponses avec un modèle linéaire. La figure 4 présente les estimations des paramètres pour PeakHeight avec un R ajusté 2 de 93%, un très bon ajustement. La réponse PeakHeight est la plus sensible aux variations de Col Temp, Det Wave et Gradient.
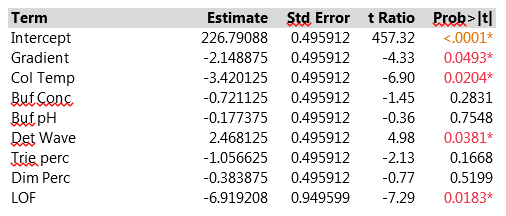
Graphique 4. Estimations des paramètres de la hauteur du pic de sept facteurs et indicateur LOF avec modèle linéaire. Pour une meilleure lisibilité, les hauteurs de pointe ont été divisées par 1 000.
Nous observons une différence statistiquement significative entre la valeur prédite au point central du plan expérimental et les trois mesures réellement effectuées à cet endroit (via la variable LOF). La figure 5 présente un graphique du profileur montrant les effets linéaires de chaque facteur sur les cinq réponses.Le graphique est très utile pour mettre en évidence les conditions susceptibles d’affecter la méthode HPLC. Nous voyons que Col Temp et Gradient, les deux facteurs les plus importants, affectent plusieurs réponses différentes.Buf pH, Buf Conc et Dim Perc ont des effets particulièrement forts sur les réponses de rétention, mais ont de faibles effets sur les autres CQA.Les facteurs donnent de bons ajustements aux réponses de rétention et à PeakHeight, mais pas à PeakArea ou Res, ce qui se reflète dans les larges bandes de confiance pour ces CQA et dans les valeurs p élevées pour les tests F du modèle global dans la ligne d'analyse de variance. de la sortie du modèle.
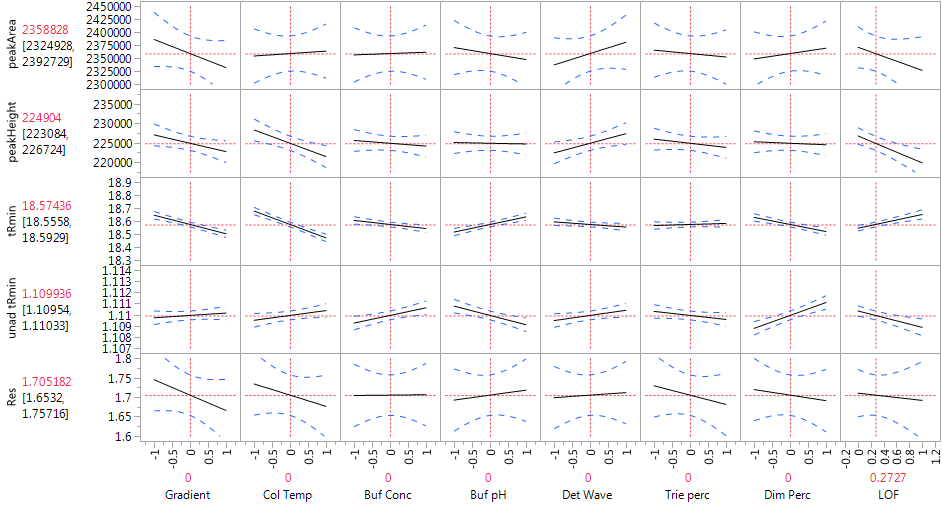
Graphique 5. Profileur d'expériences HPLC avec modèle linéaire.
Que devons-nous faire face à la non-linéarité ? Notre analyse a révélé un effet significatif de l'indicateur LOF, ce qui indique un effet non linéaire qui n'est pas pris en compte dans le profileur de la figure 5. Les points centraux que nous avons ajoutés au plan factoriel fractionnaire à deux niveaux nous permettent de détecter la non-linéarité, mais ils ne fournissent pas suffisamment d'informations pour en déterminer la cause – l'un des sept facteurs (et éventuellement plusieurs d'entre eux) pourrait en être responsable. l'effet non linéaire sur la hauteur du pic.Dans notre prochain blog, nous discuterons de certaines options de conception pour résoudre le problème. Pour l’instant, nous montrons ce que nous avons réalisé avec l’expérience actuelle. Après de nombreuses réflexions, l'équipe HPLC a décidé qu'il était très probable que le gradient soit le facteur à l'origine de la non-linéarité. Cette hypothèse importante, basée uniquement sur la connaissance des processus, est cruciale pour toutes nos conclusions ultérieures.Nous avons procédé à l'ajustement d'un modèle aux données expérimentales originales qui inclut un effet quadratique pour le gradient. L'équipe a également décidé de retenir uniquement les facteurs ayant les effets principaux les plus forts pour chaque réponse ; pour PeakHeight, les facteurs étaient le gradient, la température de la colonne et la longueur d'onde de détection. Dans la figure 6, nous montrons les estimations des paramètres obtenues en ajustant ce modèle réduit aux réponses PeakHeight. Avec ce modèle, tous les termes sont significatifs avec un R ajusté 2 de 89%.L'erreur quadratique moyenne, qui estime la variation d'une séquence à l'autre avec les mêmes paramètres de facteurs, est de 1,754, soit un peu moins de 1 % de l'ampleur de PeakHeight elle-même (après avoir divisé PeakHeight par 1 000).
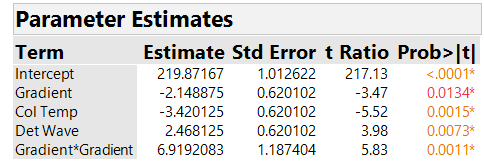
Graphique 6. Estimations des paramètres de PeakHeight avec un modèle quadratique. Pour une meilleure lisibilité, les hauteurs de pointe ont été divisées par 1 000.
Nous montrons un profileur pour le modèle quadratique réduit dans la figure 7. 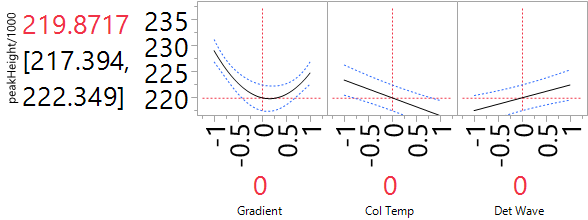
Graphique 7. Profileur d'expérience HPLC avec modèle quadratique réduit pour PeakHeight. Pour une meilleure lisibilité, les hauteurs de pointe ont été divisées par 1 000.
Trouver une solution robuste
L’un des principaux objectifs de l’expérience était d’évaluer la robustesse du système face aux variations des facteurs d’entrée. Nous explorons cette question en introduisant du bruit normal aux quatre facteurs du modèle quadratique réduit. Pour chacun des trois facteurs, nous avons supposé un écart type de 0,4 (dans les unités codées), qui est l'option par défaut dans JMP. Cela reflète l'opinion selon laquelle les paramètres expérimentaux sont d'environ 2,5 écarts-types par rapport au niveau nominal, reflétant donc des écarts plutôt extrêmes qui pourraient être rencontrés dans la pratique. La figure 8 présente l'effet du bruit sur PeakHeight pour une configuration au point central qui a été initialement identifiée comme réglage nominal.Nous pouvons calculer l'écart-type des résultats simulés en les enregistrant dans un tableau et en utilisant l'onglet « distribution » dans JMP. L'écart-type s'avère être de 2,397 et est légèrement supérieur à l'écart-type d'une séquence à l'autre que nous avons calculé précédemment, soit 1,754. Le SD global associé au système analytique implique ces deux composants. Pour les combiner, nous devons d'abord les mettre au carré, puis les additionner (car les variances sont additives, pas SD), puis prendre une racine carrée pour revenir à l'échelle de mesure d'origine. L'écart-type combiné résultant est de 2,970, de sorte que la variation anticipée des paramètres de facteur conduit à un écart-type environ 70 % plus grand que celui de la seule variation d'une analyse à l'autre.L'écart type global est inférieur à 1,5 % des valeurs typiques de PeakHeight et cela a été considéré comme acceptable pour ce processus.
Notre solution nominale est-elle bonne en termes de robustesse ?
La figure 8 est très utile pour répondre à cette question. Le facteur important ici est le gradient, grâce à sa relation non linéaire avec PeakHeight. La « vallée » de cette relation est proche du choix nominal de 0. Notre simulation de variation de facteur génère des valeurs de gradient qui couvrent la plage de -1 à 1. Lorsque ces valeurs sont dans la vallée, elles transmettent très peu de variation à PeakHeight. En revanche, lorsqu’ils se situent près des extrêmes, il existe une variation substantielle de la hauteur du pic. Ainsi, le fait que le fond de la vallée soit proche du réglage nominal nous assure que la variation transmise sera à peu près la plus faible possible. Nous pouvons tester cette fonctionnalité en décalant la valeur nominale de Gradient. Lorsque la valeur nominale est de -0,5, le simulateur montre que l'écart-type dû à la variation du facteur augmente jusqu'à 4,282, soit près de 80 % de plus que pour le réglage nominal à 0. La dépendance de PeakHeight sur Col Temp et sur Det Wave est linéaire. Ainsi, quelle que soit la manière dont nous choisissons les paramètres nominaux de ces facteurs, ils transmettront le même degré de variation à la sortie PeakHeight. L'expérience nous permet d'évaluer comment ils affectent la robustesse, mais ne donne aucune opportunité d'exploiter les résultats pour améliorer la robustesse.
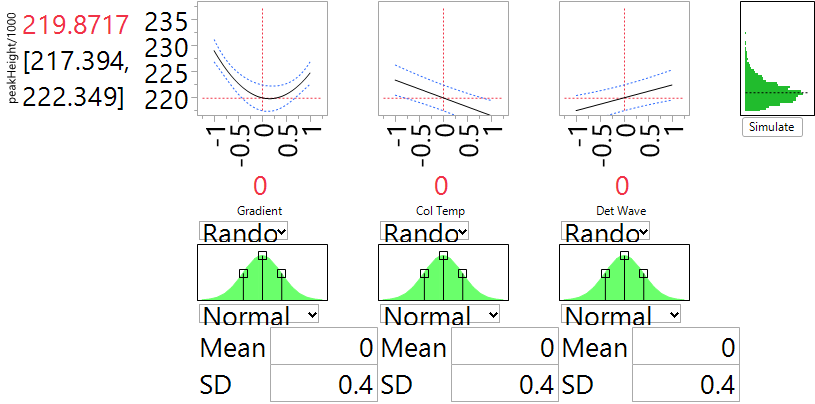
Figure 8. Profileur de prédiction de PeakHeight lorsque les facteurs sont à leurs paramètres nominaux et que l'écart-type naturel est de 0,4. Pour une meilleure lisibilité, les hauteurs de pointe ont été divisées par 1 000.
Revenir aux questions initiales
En examinant les questions posées initialement, nous pouvons désormais apporter les réponses suivantes :
1. Quelle est la variance attendue de la prédiction de mesure de la méthode pour les configurations recommandées de la méthode (l'incertitude de mesure).
Répondre: Nous avons examiné cette question de plus près pour PeakHeight, où nous avons constaté que l'écart-type est de 2 970, avec des contributions à peu près égales de la variation d'une séquence à l'autre et de la variation des facteurs du processus de mesure.
2. Quelle configuration des facteurs expérimentaux permettra d’obtenir des performances acceptables ?
Répondre: Avec tous les facteurs à leurs réglages nominaux (valeur codée à 0), l'écart-type de 2970 est inférieur à 1,5 % de la taille des valeurs mesurées, ce qui constitue un niveau de variation acceptable dans cette application.
3. Quels sont les facteurs qui influencent la performance de la méthode dans une ou plusieurs réponses ?
Répondre: Les trois facteurs ayant le plus grand impact sur les performances de la méthode sont le profil du gradient, la température de la colonne et l'onde de détection.
4. Pouvons-nous rendre la configuration des facteurs expérimentaux robuste afin d'obtenir des performances qui ne sont pas sensibles aux changements des niveaux de facteurs ?
Répondre: Nous avons vu que nous pouvons améliorer la robustesse de PeakHeight en réglant le gradient à son niveau codé de 0 (le niveau nominal dans l'expérience). Ce paramètre nous aide à tirer parti de l'effet non linéaire du gradient et à réduire la variation transmise.
5. Peut-on évaluer l'impact de la variabilité des facteurs expérimentaux sur la méthode analytique ?
Répondre: Comme nous l'avons noté précédemment, la variabilité naturelle des facteurs d'entrée est responsable d'un peu plus de la moitié de la variation de PeakHeight.
Conclure
En examinant les questions posées initialement, nous avons d’abord ajusté un modèle de régression linéaire. Après avoir réalisé qu'il existait un effet non linéaire non pris en compte, nous avons utilisé un modèle quadratique réduit et avons constaté qu'il correspondait bien aux données. En induisant une variabilité dans les facteurs du quadratique réduit (profil de gradient, température de la colonne et onde de détection), nous avons pu estimer la variabilité due à la méthode et évaluer la robustesse de la configuration recommandée. L'hypothèse de l'équipe selon laquelle le gradient est responsable de la non-linéarité est ici clairement importante. Si d’autres facteurs ont également des effets non linéaires, cela pourrait avoir des conséquences sur la meilleure façon d’améliorer la robustesse de la méthode. Nous explorerons cette question plus en détail dans notre prochain article de blog.
Remarques
[1] Borman, P., Nethercote, P., Chatfield, M., Thompson, D., Truman, K. (2007), Technologie pharmaceutique. http://pharmtech.findpharma.com/pharmtech/Peer-Reviewed+Research/The-Application-of-Quality-by-Design-to-Analytical/ArticleStandard/Article/detail/463580
[2] Kenett, RS et Kenett, DA (2008), Applications de qualité dès la conception dans les produits technologiques biosimilaires , Accréditation et assurance qualité, Springer Verlag, Vol. 13, n° 12, p. 681-690.
[3] Romero R., Gasquez, D., Sanshez, M., Rodriguez, L. et Bagur, M. (2002), Une approche géométrique des tests de robustesse en HPLC analytique, LCGC Amérique du Nord, 20 , p. 72-80, www.chromatographieenligne.com .
Le développement de méthodes de mesure ou d’analyse va de pair avec le développement de produits pharmaceutiques.
KPA Group a écrit : Merci pour votre commentaire, Phil !Groupe KPA a écrit:
Merci pour ton commentaire, Phil!
Phil Borman a écrit : En plus des 5 pages chromatographiques...Phil Borman a écrit:
En plus des 5 réponses pics chromatographiques étudiées, il aurait été intéressant d'étudier également la quantité de chaque impureté quantifiée par la méthode analytique. Cela vous donnerait une véritable indication de la robustesse, car cela évaluerait directement l'impact sur le résultat à déclarer. Les variations de la surface et de la hauteur du pic peuvent ne pas être pertinentes si, par exemple, les impuretés sont quantifiées via une normalisation par rapport au pic principal (la substance médicamenteuse dans laquelle elles sont présentes).
