Die QbD-Kolumne: Ist QbD für die Entwicklung analytischer Methoden geeignet?Anmerkung der Redaktion: Dieser Beitrag ist von @ronkenett und @david_s des KPA-Gruppe . Es ist Teil einer Reihe von Blog-Beiträgen namens Die QbD-Säule . Um weitere Informationen zu den Autoren zu erhalten, klicken Sie oben auf die Community-Namen der Autoren.
 Ron KenettRon Kent
 David Steinberg David Steinberg
Die Entwicklung von Mess- oder Analysemethoden verläuft parallel zur Entwicklung von Arzneimitteln. Das Verständnis der Prozessüberwachungs- und -steuerungsanforderungen bestimmt die Leistungskriterien für Analysemethoden, einschließlich der prozesskritischen Qualitätsattribute (CQAs) und Spezifikationsgrenzen. Das Aufdecken der Eigenschaften eines Arzneimittels, die einer Kontrolle bedürfen, um Sicherheit oder Wirksamkeit zu gewährleisten, bestimmt die Identifizierung von CQAs. Zu den typischen Anforderungen an analytische Methoden gehören:
- Präzision: Diese Anforderung stellt sicher, dass die Methodenvariabilität nur einen kleinen Teil des Spezifikationsbereichs (obere Spezifikationsgrenze – untere Spezifikationsgrenze) ausmacht. Dies wird auch Gage Reproducibility and Repeatability (GR&R) genannt.
- Selektivität: Dadurch wird festgelegt, welche Verunreinigungen in jedem Produktionsschritt überwacht werden müssen, und es werden Konstruktionsmethoden festgelegt, die die relativen Anteile jeder Verunreinigung angemessen unterscheiden.
- Empfindlichkeit: Um eine effektive Prozesssteuerung zu erreichen, erfordert dies Methoden, die Änderungen in CQAs, die relativ zu den Spezifikationsgrenzen wichtig sind, genau widerspiegeln.
Diese Kriterien belegen die Zuverlässigkeit von Methoden für den Einsatz im Routinebetrieb. Dies hat Auswirkungen auf die Analysezeit, akzeptable Lösungsmittel und verfügbare Ausrüstung. Um eine Analysemethode mit QbD-Prinzipien zu entwickeln, müssen die Leistungskriterien der Methode sowie die gewünschte operative Absicht des Endbenutzers verstanden werden. Ein begrenztes Verständnis einer Methode kann zu einem schlechten Technologietransfer vom Labor zur Verwendung in kommerziellen Produktionsanlagen oder von einer bestehenden Anlage zu einer neuen führen. Fehlgeschlagene Übertragungen erfordern oft erhebliche zusätzliche Ressourcen, um die Ursachen des Scheiterns zu beheben, normalerweise zu einem Zeitpunkt, an dem ein erheblicher Druck besteht, die Einführung eines neuen Produkts voranzutreiben. Die Anwendung von Quality by Design (QbD) auf analytische Methoden zielt darauf ab, solche Probleme zu vermeiden. Die QbD-Implementierung bei der Entwicklung analytischer Methoden ist typischerweise ein vierstufiger Prozess, der sich sowohl mit dem Design als auch der Kontrolle der Methoden befasst [1] . Die Stufen sind:
- Absicht des Methodendesigns : Identifizieren und spezifizieren Sie die Leistung der analytischen Methode.
- Auswahl des Methodendesigns : Wählen Sie die Arbeitsbedingungen der Methode aus, um die Designabsicht zu erreichen.
- Methodensteuerungsdefinition : Richten Sie geeignete Kontrollen für die Komponenten mit den größten Beiträgen zur Leistungsvariabilität ein und definieren Sie sie.
- Validierung der Methodenkontrolle : Demonstrieren Sie eine akzeptable Methodenleistung mit robusten und effektiven Kontrollen.
Das Testen der Robustheit analytischer Methoden beinhaltet die Bewertung des Einflusses kleiner Änderungen der Betriebsbedingungen [2] . Robustheitstests identifizieren den Grad der Reproduzierbarkeit von Testergebnissen, die durch die Analyse derselben Probe unter verschiedenen normalen Testbedingungen wie verschiedenen Labors, Analytikern und Instrumenten erhalten wurden. In der folgenden Fallstudie konzentrieren wir uns auf die Verwendung von Experimenten zur Bewertung und Verbesserung der Robustheit.
Eine Fallstudie zur HPLC-Entwicklung
Die hier vorgestellte Fallstudie stammt aus der Entwicklung einer Methode der Hochleistungsflüssigkeitschromatographie (HPLC). [3] . Es ist ein typisches Beispiel für die Prüfung der Robustheit analytischer Methoden. Das spezielle System besteht aus einem Agilent 1050 mit einem UV-Detektor mit variabler Wellenlänge und einem Integrator Modell 3396-A. Ziel der Robustheitsstudie ist es herauszufinden, ob sich Abweichungen von den nominellen Betriebsbedingungen auf die Ergebnisse auswirken. Tabelle 1 listet die Faktoren und ihre Ebenen auf, die in dieser Fallstudie verwendet wurden. Die Versuchsanordnung ist eine 2 7-4 Fractional Factorial Experiment mit drei Mittelpunkten (siehe Tabelle 2). Die Pegel "-1" und "1" entsprechen den in Tabelle 1 aufgelisteten unteren und oberen Pegeln, und "0" entspricht dem nominalen Pegel. Die unteren und oberen Pegel werden so gewählt, dass sie Schwankungen widerspiegeln, die während des regulären Betriebs natürlich um die Nenneinstellung herum auftreten können. Beispiele für QbD-Anwendungen von Fractional Factorial-Experimenten zur Formulierungs- und Arzneimittelproduktentwicklung finden Sie unter zweite und dritte Blogbeiträge in dieser Reihe.
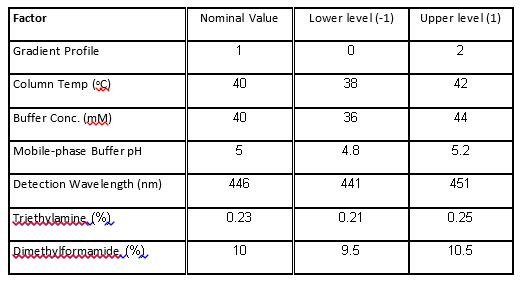
Tabelle 1. Faktoren und Niveaus im HPLC-Experiment.
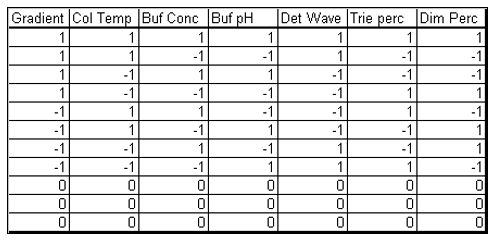
Tabelle 2. Versuchsanordnung des HPLC-Experiments.
Die Versuchsanordnung besteht aus 11 Versuchsläufen, die die Designfaktorebenen in einem ausgewogenen Satz von Kombinationen und drei Mittelpunkten kombinieren.
Was wir aus den HPLC-Experimenten lernen können
Bei der Analyse des HPLC-Experiments haben wir folgende Ziele:
- Ermitteln Sie die erwartete Vorhersagevarianz der Methodenmessung für empfohlene Setups der Methode (die Messunsicherheit).
- Identifizieren Sie die besten Einstellungen der experimentellen Faktoren, um eine akzeptable Leistung zu erzielen.
- Bestimmen Sie die Faktoren, die die Leistung der Methode bei einer oder mehreren Antworten beeinflussen.
- Bewerten Sie die Auswirkungen der Variabilität in den experimentellen Faktoren auf die gemessenen Antworten.
- Machen Sie den HPLC-Prozess robust, indem Sie die Nichtlinearität in den Faktoreffekten ausnutzen, um eine Leistung zu erzielen, die nicht empfindlich auf Änderungen um nominale Niveaus reagiert.
Betrachtet man nur die acht Versuchsläufe des 2 7-4 Bruchfaktoriell, ohne die Mittelpunkte, erhalten wir eine durchschnittliche Vorhersagevarianz von 0,417 und 100 % Optimalität für die Anpassung an ein Modell erster Ordnung. Dies liegt an der ausgewogenen Eigenschaft des Designs (siehe Abbildung 1 links). Das Design in Tabelle 2 mit drei Mittelpunkten reduziert die Vorhersageunsicherheit in der Nähe des Zentrums der Region und hat eine niedrigere durchschnittliche Vorhersagevarianz von 0,38. Die Mittelpunkte tragen jedoch nicht zur Schätzung von Steigungen bei, wie in der geringeren Effizienz für die Anpassung des Modells erster Ordnung zu sehen ist (siehe Abbildung 1 rechts). 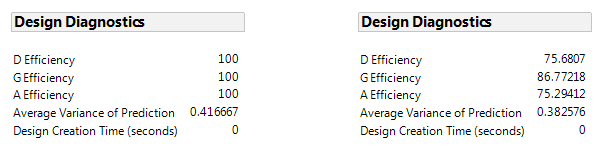
Abbildung 1. Design-Diagnose für diese Bruchfakultät ohne (links) und mit (rechts) drei Mittelpunkten.
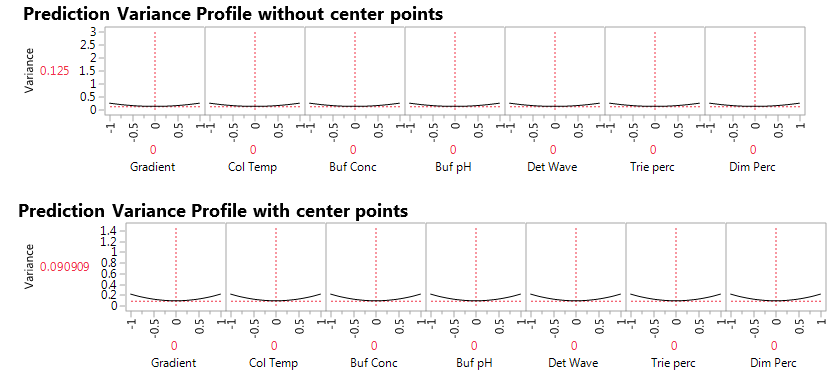
Figur 2. Prognoseabweichungsprofil ohne (oben) und mit (unten) Mittelpunkten.
Das JMP-Prognosevarianzprofil in Abbildung 2 zeigt das Verhältnis der Vorhersagevarianz zur Fehlervarianz, auch als relative Varianz der Vorhersage bezeichnet, bei verschiedenen Faktorstufenkombinationen. Die relative Varianz wird in der Mitte des Designs minimiert. Das Hinzufügen von drei Mittelpunkten reduziert die Vorhersagevarianz um 25 % von 0,12 auf 0,09. Dies ist ein Vorteil, der durch Hinzufügen von Versuchsläufen an den Mittelpunkten erzielt wird. Ein weiterer Vorteil, den wir später sehen werden, besteht darin, dass die Mittelpunkte es uns ermöglichen, nichtlineare Effekte oder mangelnde Anpassung an das lineare Regressionsmodell zu bewerten. Ein dritter Vorteil besteht darin, dass uns die Mittelpunkte eine modellfreie Schätzung des Ausmaßes der natürlichen Variation im System liefern. Bei jeder Faktorstufenkombination ergaben die Experimente fünf Antworten: 1) Fläche des Chromatogramms am Peak (peakArea), 2) Höhe des Chromatogramms am Peak (peakHeight), 3) An den Standard angepasste minimale Retentionszeit (tRmin), 4) Nicht angepasstes Minimum Retentionszeit (unad tRmin) und 5) Chromatogrammauflösung (Res). Unser erstes Anliegen bei der Analyse der Daten ist die Identifizierung geeigneter Modelle zur Verknüpfung von Faktoren und Reaktionen.
Was lernen wir aus der Analyse der Daten aus dem Bruchfaktorexperiment?
Lineare Regressionsmodelle sind die einfachsten zu berücksichtigenden Modelle. Sie stellen Änderungen in den Antworten zwischen zwei Ebenen von Faktoren dar, in unserem Fall entspricht dies den Ebenen, die mit „-1“ und „+1“ gekennzeichnet sind. Da wir auch drei Mittelpunkte haben, können wir auf den mit „0“ bezeichneten Ebenen auch nichtlineare Effekte bewerten. Wir tun dies, wie in unserem zweiten Blog-Beitrag, indem wir eine synthetische Indikatorvariable hinzufügen, die entwickelt wurde, um die fehlende Anpassung (LOF) zu bewerten, die an den zentralen Punkten gleich „1“ und an anderen Stellen „0“ ist. Der JMP-Effektzusammenfassungsbericht für alle fünf Antworten mit linearen Effekten auf alle sieben Faktoren und den LOF-Indikator ist in Abbildung 3 dargestellt. 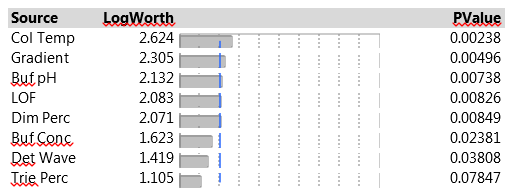
Figur 3. Effekt Zusammenfassender Bericht von sieben Faktoren und LOF-Indikator für fünf Antworten.
Die Tabelle Effektzusammenfassung listet die Modelleffekte über den gesamten Satz von fünf Antworten auf, sortiert nach aufsteigenden p-Werten. Der LogWorth für jeden Effekt ist als -log10(p-Wert) definiert, wodurch p-Werte angepasst werden, um eine geeignete Skalierung für Grafiken bereitzustellen. Ein LogWorth, der 2 überschreitet, ist auf der Ebene 0,01 signifikant, weil -log10(0,01)=2. Der Bericht enthält ein Balkendiagramm des LogWorth mit gestrichelten vertikalen Linien bei ganzzahligen Werten und einer blauen Referenzlinie bei 2. Die angezeigten p-Werte entsprechen dem Signifikanztest, der in der Effekttesttabelle des Modellberichts angezeigt wird. Der Bericht in Abbildung 3 zeigt, dass insgesamt vier Faktoren und LOF auf dem Niveau von 0,01 signifikant sind (Col Temp, Gradient, Buf PH und Dim Perc) und Buf Conc, Det Wave und Trie Perc nicht signifikant sind. Aus dem Versuchsplan in Tabelle 2 kann man die Haupteffekte der sieben Faktoren und des LOF-Indikators auf die fünf Antworten mit einem linearen Modell abschätzen. Abbildung 4 zeigt Parameterschätzungen für peakHeight mit einem angepassten R 2 von 93 % eine sehr gute Passform. Die PeakHeight-Reaktion reagiert am empfindlichsten auf Schwankungen in Col Temp, Det Wave und Gradient.
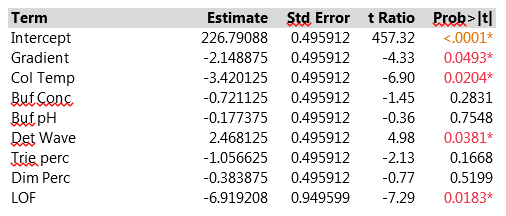
Figur 4. Parameterschätzungen von PeakHeight aus sieben Faktoren und LOF-Indikator mit linearem Modell. Zur besseren Lesbarkeit wurden peakHeights durch 1000 geteilt.
Wir beobachten einen statistisch signifikanten Unterschied zwischen dem vorhergesagten Wert am Mittelpunkt des experimentellen Designs und den drei dort tatsächlich durchgeführten Messungen (über die LOF-Variable). Abbildung 5 zeigt ein Profiler-Diagramm, das die linearen Auswirkungen jedes Faktors auf alle fünf Antworten zeigt.Das Diagramm ist sehr hilfreich, um hervorzuheben, welche Bedingungen die HPLC-Methode beeinflussen könnten. Wir sehen, dass Col Temp und Gradient, die beiden wichtigsten Faktoren, mehrere unterschiedliche Reaktionen beeinflussen.Buf pH, Buf Conc und Dim Perc haben besonders starke Wirkungen auf die Retentionsreaktionen, haben aber schwache Wirkungen auf die anderen CQAs.Die Faktoren passen gut zu den Retentionsantworten und zu peakHeight, aber nicht zu peakArea oder Res, was sich in den breiten Konfidenzbändern für diese CQAs und in hohen p-Werten für die F-Tests des Gesamtmodells in der Varianzanalyselinie widerspiegelt der Modellausgabe.
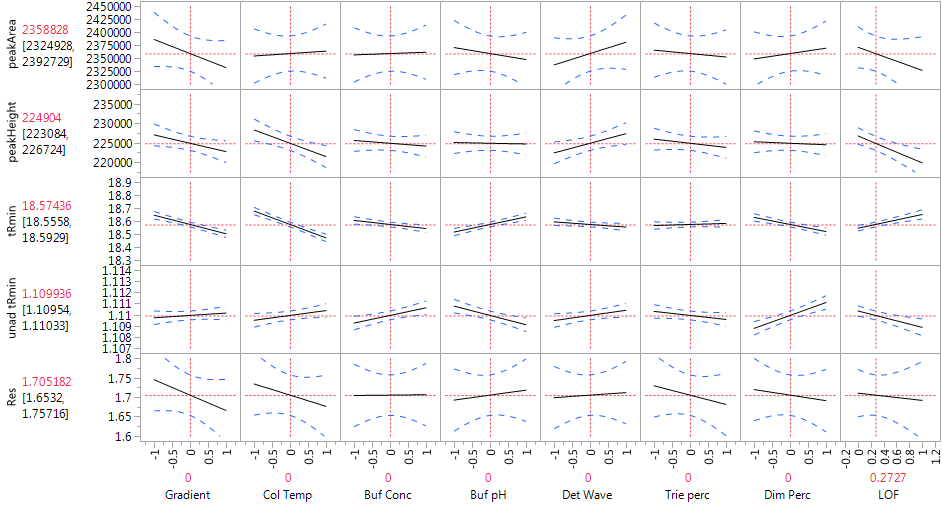
Abbildung 5. Profiler von HPLC-Experimenten mit linearem Modell.
Was sollen wir gegen die Nichtlinearität tun? Unsere Analyse ergab einen signifikanten Effekt des LOF-Indikators, der auf einen nichtlinearen Effekt hinweist, der im Profiler von Abbildung 5 nicht berücksichtigt wird. Die Mittelpunkte, die wir dem zweistufigen faktoriellen Versuchsplan hinzugefügt haben, lassen uns die Nichtlinearität erkennen, aber sie liefern nicht genügend Informationen, um zu bestimmen, was sie verursacht – jeder der sieben Faktoren (und möglicherweise mehrere von ihnen) könnte dafür verantwortlich sein der nichtlineare Effekt auf die Peakhöhe.In unserem nächsten Blog werden wir einige Designoptionen diskutieren, um das Problem anzugehen. Für den Moment zeigen wir, was wir mit dem aktuellen Experiment erreicht haben. Nach langem Brainstorming entschied das HPLC-Team, dass es sehr wahrscheinlich ist, dass der Gradient der Faktor war, der die Nichtlinearität verursachte. Diese wichtige Annahme, die nur auf Prozesswissen basiert, ist entscheidend für alle unsere nachfolgenden Schlussfolgerungen.Wir fuhren fort, ein Modell an die ursprünglichen experimentellen Daten anzupassen, das einen quadratischen Effekt für Gradient beinhaltet. Das Team beschloss außerdem, nur die Faktoren mit den stärksten Haupteffekten für jede Antwort zu behalten; für PeakHeight waren die Faktoren Gradient, Säulentemperatur und Detektionswellenlänge. In Abbildung 6 zeigen wir Parameterschätzungen aus der Anpassung dieses reduzierten Modells an die PeakHeight-Antworten. Bei diesem Modell sind alle Terme mit einem angepassten R signifikant 2 von 89 %.Der quadratische Mittelwertfehler, der die Variation von Lauf zu Lauf bei denselben Einstellungen der Faktoren schätzt, beträgt 1,754, etwas weniger als 1 % der Größe von peakHeight selbst (nach Division von peakHeight durch 1000).
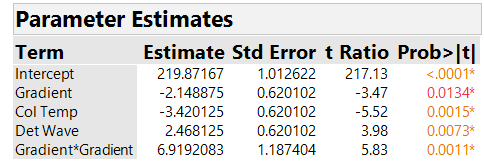
Abbildung 6. Parameterschätzungen von peakHeight mit quadratischem Modell. Zur besseren Lesbarkeit wurden peakHeights durch 1000 geteilt.
Wir zeigen einen Profiler für das reduzierte quadratische Modell in Abbildung 7. 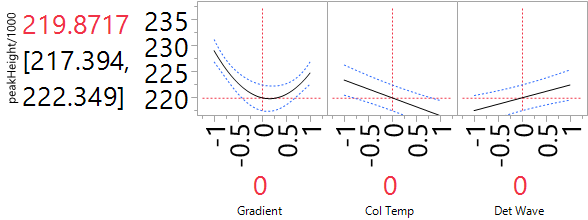
Abbildung 7. Profiler des HPLC-Experiments mit reduziertem quadratischem Modell für PeakHeight. Zur besseren Lesbarkeit wurden peakHeights durch 1000 geteilt.
Eine robuste Lösung finden
Eines der Hauptziele des Experiments war die Bewertung der Robustheit des Systems gegenüber Schwankungen der Eingabefaktoren. Wir untersuchen diese Frage, indem wir normales Rauschen in die vier Faktoren des reduzierten quadratischen Modells einführen. Für jeden der drei Faktoren haben wir eine Standardabweichung von 0,4 (in den codierten Einheiten) angenommen, was die Standardoption in JMP ist. Dies spiegelt die Ansicht wider, dass die experimentellen Einstellungen etwa 2,5 SD vom Nennpegel entfernt sind, also eher extreme Abweichungen widerspiegeln, die in der Praxis auftreten können. Abbildung 8 zeigt die Wirkung des Rauschens auf die Spitzenhöhe für einen Aufbau am Mittelpunkt, der ursprünglich als nominale Einstellung identifiziert wurde.Wir können die SD der simulierten Ergebnisse berechnen, indem wir sie in einer Tabelle speichern und die Registerkarte „Verteilung“ in JMP verwenden. Die SD stellt sich als 2,397 heraus und ist etwas größer als die Run-to-Run-SD, die wir zuvor von 1,754 berechnet haben. Die mit dem analytischen System verbundene Gesamt-SD umfasst beide Komponenten. Um sie zu kombinieren, müssen wir sie zuerst quadrieren, dann addieren (weil Varianzen additiv sind, nicht SD) und dann eine Quadratwurzel ziehen, um zur ursprünglichen Messskala zurückzukehren. Die resultierende kombinierte SD beträgt 2,970, sodass die erwartete Variation der Faktoreinstellungen zu einer SD führt, die etwa 70 % größer ist als die von Run-to-Run-Variation allein.Die Gesamt-SD beträgt weniger als 1,5 % der typischen Werte von PeakHeight, was für diesen Prozess als akzeptabel angesehen wurde.
Ist unsere nominale Lösung gut für die Robustheit?
Abbildung 8 ist sehr hilfreich bei der Beantwortung dieser Frage. Der wichtige Faktor hier ist Gradient durch seine nichtlineare Beziehung zu peakHeight. Das „Tal“ dieser Beziehung liegt nahe der nominellen Wahl von 0. Unsere Simulation der Faktorvariation generiert Gradientenwerte, die den Bereich von -1 bis 1 abdecken. Wenn sich diese Werte im Tal befinden, übertragen sie sehr wenig Variation an peakHeight. Wenn sie sich dagegen in der Nähe der Extreme befinden, gibt es eine beträchtliche Variation in peakHeight. Die Tatsache, dass der Boden des Tals nahe der Nenneinstellung liegt, versichert uns also, dass die übertragene Variation so gering wie möglich sein wird. Wir können diese Funktion testen, indem wir den Nennwert von Gradient verschieben. Wenn der Nennwert -0,5 beträgt, zeigt der Simulator, dass die SD von der Faktorvariation auf 4,282 ansteigt, fast 80 % mehr als bei der Nenneinstellung von 0. Die Abhängigkeit von peakHeight von Col Temp und von Det Wave ist linear. Unabhängig davon, wie wir die nominalen Einstellungen dieser Faktoren wählen, übertragen sie den gleichen Grad an Variation an den PeakHeight-Ausgang. Das Experiment lässt uns beurteilen, wie sie sich auf die Robustheit auswirken, bietet jedoch keine Möglichkeit, die Ergebnisse zur Verbesserung der Robustheit zu nutzen.
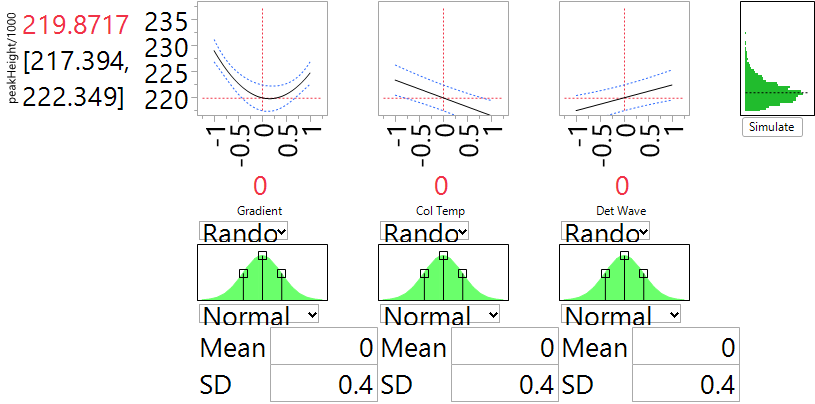
Abbildung 8. Prediction Profiler von peakHeight, wenn die Faktoren auf ihren nominalen Einstellungen liegen und die natürliche SD 0,4 beträgt. Zur besseren Lesbarkeit wurden peakHeights durch 1000 geteilt.
Zurück zu den ursprünglichen Fragen
Nach Überprüfung der ursprünglich gestellten Fragen können wir nun folgende Antworten geben:
1. Wie hoch ist die erwartete Vorhersagevarianz der Methodenmessung für empfohlene Methodenkonfigurationen (die Messunsicherheit).
Antworten: Wir haben uns diese Frage am genauesten für peakHeight angesehen, wo wir herausgefunden haben, dass die SD 2970 beträgt, mit ungefähr gleichen Beiträgen von der Variation von Lauf zu Lauf und von der Variation in den Messprozessfaktoren.
2. Welcher Aufbau der experimentellen Faktoren wird eine akzeptable Leistung erzielen?
Antworten: Mit allen Faktoren auf ihren Nennwerten (codierter Wert auf 0) beträgt die SD von 2970 weniger als 1,5 % der Größe der gemessenen Werte, was in dieser Anwendung ein akzeptables Maß an Schwankung darstellt.
3. Welche Faktoren beeinflussen die Leistung der Methode bei einer oder mehreren Antworten?
Antworten: Die drei Faktoren mit dem größten Einfluss auf die Leistung der Methode sind Gradientenprofil, Säulentemperatur und Detektionswelle.
4. Können wir den Aufbau der experimentellen Faktoren robust gestalten, um eine Leistung zu erreichen, die nicht empfindlich auf Änderungen der Faktorniveaus reagiert?
Antworten: Wir haben gesehen, dass wir die Robustheit für peakHeight verbessern können, indem wir den Gradienten auf seinen codierten Pegel von 0 setzen (den nominellen Pegel im Experiment). Diese Einstellung hilft uns, den nichtlinearen Effekt des Gradienten auszunutzen und die übertragene Variation zu reduzieren.
5. Können wir den Einfluss der Variabilität der experimentellen Faktoren auf die Analysemethode beurteilen?
Antworten: Wie bereits erwähnt, ist die natürliche Variabilität der Eingabefaktoren für etwas mehr als die Hälfte der Variation in peakHeight verantwortlich.
Einpacken
Bei der Überprüfung der ursprünglich gestellten Fragen passen wir zunächst ein lineares Regressionsmodell an. Nachdem wir erkannt hatten, dass es einen nicht erklärten nichtlinearen Effekt gibt, haben wir ein reduziertes quadratisches Modell verwendet und festgestellt, dass es gut zu den Daten passt. Indem wir eine Variabilität in den Faktoren des reduzierten Quadrats (Gradientenprofil, Säulentemperatur und Detektionswelle) hervorriefen, konnten wir die Variabilität aufgrund der Methode abschätzen und die Robustheit des empfohlenen Aufbaus bewerten. Die Annahme des Teams, dass der Gradient für die Nichtlinearität verantwortlich ist, ist hier eindeutig wichtig. Wenn andere Faktoren ebenfalls nichtlineare Effekte haben, könnte dies Konsequenzen dafür haben, wie die Robustheit der Methode am besten verbessert werden kann. Wir werden dieses Problem in unserem nächsten Blogbeitrag weiter untersuchen.
Anmerkungen
[1] Bormann, P., Nethercote, P., Chatfield, M., Thompson, D., Truman, K. (2007), Pharmazeutische Technologie. http://pharmtech.findpharma.com/pharmtech/Peer-Reviewed+Research/The-Application-of-Quality-by-Design-to-Analytical/ArticleStandard/Article/detail/463580
[2] Kenett, RS, und Kenett, DA (2008), Quality by Design Applications in Biosimilar Technological Products , Akkreditierung und Qualitätssicherung, Springer Verlag, Bd. 13, Nr. 12, S. 681-690.
[3] Romero R., Gasquez, D., Sanschez, M., Rodriguez, L. und Bagur, M. (2002), Ein geometrischer Ansatz für Robustheitstests in der analytischen HPLC, LCGC Nordamerika, 20 , S. 72-80, www.chromatographyonline.com .
Die Entwicklung von Mess- oder Analysemethoden verläuft parallel zur Entwicklung von Arzneimitteln.
KPA Group hat geschrieben: Danke für deinen Kommentar, Phil!KPA-Gruppe schrieb:
Danke für deinen Kommentar, Philipp!
Phil Borman schrieb: Zusätzlich zu den 5 chromatographischen p...Phil Bormann schrieb:
Zusätzlich zu den 5 untersuchten chromatographischen Peak-Antworten wäre es interessant gewesen, auch die Menge jeder Verunreinigung zu untersuchen, die durch das Analyseverfahren quantifiziert wurde. Dies würde Ihnen einen echten Hinweis auf die Robustheit geben, da die Auswirkungen auf das berichtspflichtige Ergebnis direkt bewertet werden. Schwankungen in Peakfläche und Peakhöhe können irrelevant sein, wenn beispielsweise Verunreinigungen durch Normalisierung gegen den Hauptpeak (die Arzneisubstanz, in der sie vorhanden sind) quantifiziert werden.
