La colonna QbD: QbD è applicabile per lo sviluppo di metodi analitici?Nota dell'editore: Questo post è di @ronkenett e @david_s del Gruppo KPA . Fa parte di una serie di post sul blog chiamati La colonna QbD . Per ulteriori informazioni sugli autori, fare clic sui nomi della comunità degli autori sopra.
 Ron KenettRon Kenett
 David Steinberg David Steinberg
Lo sviluppo di metodi di misurazione o di analisi è parallelo allo sviluppo di prodotti farmaceutici. La comprensione dei requisiti di monitoraggio e controllo del processo guida i criteri di prestazione per i metodi analitici, inclusi gli attributi di qualità critica del processo (CQA) e i limiti delle specifiche. Scoprire le caratteristiche di una sostanza farmacologica che richiedono un controllo per garantire la sicurezza o l'efficacia determina l'identificazione dei CQA. I requisiti tipici dei metodi analitici includono:
- Precisione: Questo requisito assicura che la variabilità del metodo sia solo una piccola parte dell'intervallo delle specifiche (limite di specifica superiore – limite di specifica inferiore). Questo è anche chiamato Gage Reproducibility and Repeatability (GR&R).
- Selettività: Questo determina quali impurità monitorare in ogni fase di produzione e specifica metodi di progettazione che discriminano adeguatamente le proporzioni relative di ciascuna impurità.
- Sensibilità: Per ottenere un controllo di processo efficace, ciò richiede metodi che riflettano accuratamente i cambiamenti nei CQA che sono importanti rispetto ai limiti delle specifiche.
Questi criteri stabiliscono l'affidabilità dei metodi da utilizzare nelle operazioni di routine. Ciò ha implicazioni per i tempi di analisi, i solventi accettabili e le apparecchiature disponibili. Per sviluppare un metodo analitico con i principi della QbD, è necessario comprendere i criteri di prestazione del metodo, nonché l'intento operativo desiderato dell'eventuale utente finale. La comprensione limitata di un metodo può portare a uno scarso trasferimento di tecnologia dal laboratorio all'uso in strutture di produzione commerciali o da una struttura esistente a una nuova. I trasferimenti non riusciti spesso richiedono risorse aggiuntive significative per rimediare alle cause del fallimento, di solito in un momento in cui c'è una forte pressione per andare avanti con il lancio di un nuovo prodotto. L'applicazione della Quality by Design (QbD) ai metodi analitici mira a prevenire tali problemi. L'implementazione della QbD nello sviluppo di metodi analitici è tipicamente un processo in quattro fasi, che riguarda sia la progettazione che il controllo dei metodi [1] . Le fasi sono:
- Intento di progettazione del metodo : identificare e specificare le prestazioni del metodo analitico.
- Selezione del metodo di progettazione : Seleziona le condizioni di lavoro del metodo per raggiungere l'intento progettuale.
- Definizione del controllo del metodo : Stabilire e definire controlli appropriati per i componenti con i maggiori contributi alla variabilità delle prestazioni.
- Convalida del controllo del metodo : dimostrare prestazioni accettabili del metodo con controlli solidi ed efficaci.
Testare la robustezza dei metodi analitici implica valutare l'influenza di piccoli cambiamenti nelle condizioni operative [2] . Il test di robustezza identifica il grado di riproducibilità dei risultati dei test ottenuti dall'analisi dello stesso campione in varie condizioni di test normali come laboratori, analisti e strumenti diversi. Nel seguente caso di studio, ci concentriamo sull'uso di esperimenti per valutare e migliorare la robustezza.
Un caso di studio nello sviluppo di HPLC
Il caso di studio qui presentato deriva dallo sviluppo di un metodo di cromatografia liquida ad alte prestazioni (HPLC). [3] . È un tipico esempio di verifica della robustezza dei metodi analitici. Il sistema specifico è costituito da un Agilent 1050, con un rivelatore UV a lunghezza d'onda variabile e un integratore modello 3396-A. L'obiettivo dello studio di robustezza è scoprire se le deviazioni dalle condizioni operative nominali influiscono sui risultati. La tabella 1 elenca i fattori e i loro livelli utilizzati in questo caso di studio. L'array sperimentale è un 2 7-4 Esperimento fattoriale frazionario con tre punti centrali (vedi Tabella 2). I livelli "-1" e "1" corrispondono ai livelli inferiore e superiore elencati nella tabella 1 e "0" corrisponde al livello nominale. I livelli inferiore e superiore sono scelti per riflettere le variazioni che potrebbero verificarsi naturalmente sull'impostazione nominale durante il normale funzionamento. Per esempi di applicazioni QbD degli esperimenti fattoriali frazionari alla formulazione e allo sviluppo di prodotti farmaceutici, vedere il secondo e Terzo post del blog in questa serie.
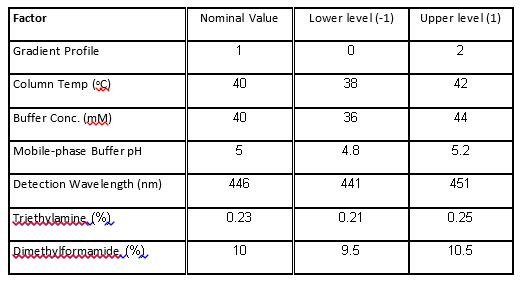
Tabella 1. Fattori e livelli nell'esperimento HPLC.
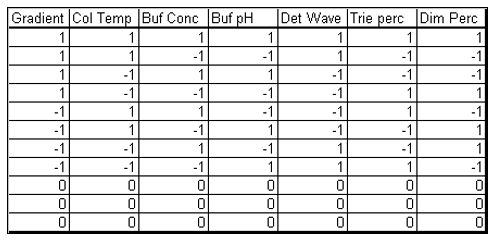
Tavolo 2. Array sperimentale dell'esperimento HPLC.
L'array sperimentale è costituito da 11 piste sperimentali che combinano i livelli dei fattori di progettazione in un insieme equilibrato di combinazioni e tre punti centrali.
Cosa possiamo imparare dagli esperimenti HPLC
Analizzando l'esperimento HPLC, abbiamo i seguenti obiettivi:
- Trova la varianza di previsione della misurazione del metodo prevista per le impostazioni consigliate del metodo (l'incertezza di misurazione).
- Identificare le migliori impostazioni dei fattori sperimentali per ottenere prestazioni accettabili.
- Determinare i fattori che influiscono sulle prestazioni del metodo su una o più risposte.
- Valutare l'impatto della variabilità nei fattori sperimentali sulle risposte misurate.
- Rendi robusto il processo HPLC sfruttando la non linearità negli effetti del fattore per ottenere prestazioni non sensibili alle variazioni dei livelli nominali.
Se consideriamo solo le otto prove sperimentali del 2 7-4 fattoriale frazionario, senza i punti centrali, otteniamo una varianza di previsione media di 0,417 e un'ottimalità del 100% per l'adattamento di un modello del primo ordine. Ciò è dovuto alla proprietà equilibrata del progetto (vedi Figura 1 a sinistra). Il disegno in Tabella 2, con tre punti centrali, riduce l'incertezza di previsione vicino al centro della regione e ha una varianza di previsione media inferiore di 0,38. Tuttavia, i punti centrali non contribuiscono alla stima delle pendenze, come si vede nella minore efficienza per l'adattamento del modello del primo ordine (vedi Figura 1 a destra). 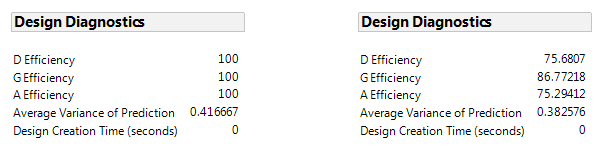
Figura 1. Progetta la diagnostica per questo fattoriale frazionario senza (a sinistra) e con (a destra) tre punti centrali.
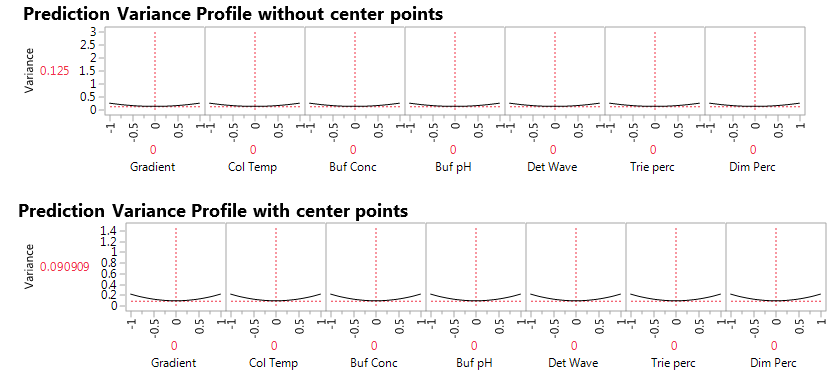
Figura 2. Profilo di varianza di previsione senza (in alto) e con (in basso) punti centrali.
Il JMP Prediction Variance Profile nella Figura 2 mostra il rapporto tra la varianza della previsione e la varianza dell'errore, chiamata anche varianza relativa della previsione, a varie combinazioni a livello di fattore. La varianza relativa è ridotta al minimo al centro del design. L'aggiunta di tre punti centrali riduce la varianza di previsione del 25%, da 0,12 a 0,09. Questo è un vantaggio derivato dall'aggiunta di piste sperimentali nei punti centrali. Un altro vantaggio che vedremo più avanti è che i punti centrali ci consentono di valutare gli effetti non lineari o la mancanza di adattamento per il modello di regressione lineare. Un terzo vantaggio è che i punti centrali ci forniscono una stima senza modello dell'entità della variazione naturale nel sistema. Ad ogni combinazione di livello di fattore, gli esperimenti hanno prodotto cinque risposte: 1) Area del cromatogramma al picco (peakArea), 2) Altezza del cromatogramma al picco (peakHeight), 3) Tempo di ritenzione minimo regolato su standard (tRmin), 4) Minimo non regolato tempo di ritenzione (unad tRmin) e 5) Risoluzione del cromatogramma (Res). La nostra prima preoccupazione nell'analisi dei dati è identificare modelli adeguati che colleghino fattori e risposte.
Cosa impariamo dall'analisi dei dati dell'esperimento fattoriale frazionario?
I modelli di regressione lineare sono i modelli più semplici da considerare. Rappresentano cambiamenti nelle risposte tra due livelli di fattori, nel nostro caso questo corrisponde a livelli etichettati “-1” e “+1”. Poiché abbiamo anche tre punti centrali, a livelli etichettati "0", possiamo anche valutare gli effetti non lineari. Lo facciamo, come nel nostro secondo post sul blog, aggiungendo una variabile indicatore sintetica progettata per valutare la mancanza di adattamento (LOF) che è uguale a "1" nei punti centrali e "0" altrove. Il rapporto di riepilogo degli effetti JMP, per tutte e cinque le risposte con effetti lineari su tutti e sette i fattori, e l'indicatore LOF, sono presentati nella Figura 3. 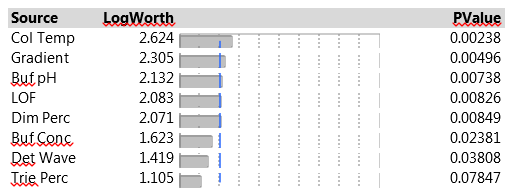
Figura 3. Effetto Rapporto riepilogativo di sette fattori e indicatore LOF su cinque risposte.
La tabella Riepilogo effetti elenca gli effetti del modello nell'intero set di cinque risposte, ordinati per valori p crescenti. LogWorth per ciascun effetto è definito come -log10(p-value), che regola i valori p per fornire una scala appropriata per la grafica. Un LogWorth che supera 2 è significativo al livello 0,01 perché -log10(0,01)=2. Il report include un grafico a barre di LogWorth con linee verticali tratteggiate a valori interi e una linea di riferimento blu a 2. I valori p visualizzati corrispondono al test di significatività visualizzato nella tabella dei test di effetto del report del modello. Il rapporto nella Figura 3 mostra che, nel complesso, quattro fattori e LOF sono significativi al livello 0,01 (Col Temp, Gradient, Buf PH e Dim Perc) e Buf Conc, Det Wave e Trie Perc non sono significativi. Dal piano sperimentale in Tabella 2, si possono stimare i principali effetti dei sette fattori e dell'indicatore LOF sulle cinque risposte con un modello lineare. La figura 4 presenta le stime dei parametri per peakHeight con un R aggiustato 2 del 93%, un'ottima vestibilità. La risposta peakHeight è più sensibile alle variazioni di Col Temp, Det Wave e Gradient.
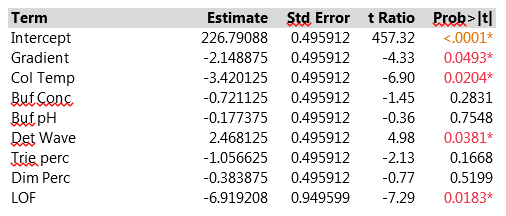
Figura 4. Stime dei parametri di peakHeight di sette fattori e indicatore LOF con modello lineare. Per una migliore leggibilità, peakHeights è stato diviso per 1000.
Osserviamo una differenza statisticamente significativa tra il valore previsto al centro del disegno sperimentale e le tre misurazioni effettivamente eseguite lì (tramite la variabile LOF). La Figura 5 mostra un grafico del profiler che mostra gli effetti lineari di ciascun fattore su tutte e cinque le risposte.La trama è molto utile per evidenziare quali condizioni potrebbero influenzare il metodo HPLC. Vediamo che Col Temp e Gradient, i due fattori più importanti, influenzano diverse risposte diverse.Buf pH, Buf Conc e Dim Perc hanno effetti particolarmente forti sulle risposte di ritenzione, ma hanno effetti deboli sugli altri CQA.I fattori si adattano bene alle risposte di ritenzione e a peakHeight, ma non a peakArea o Res, che si riflette nelle ampie bande di confidenza per quei CQA e in valori p elevati per i test F del modello complessivo nella riga dell'analisi della varianza dell'output del modello.
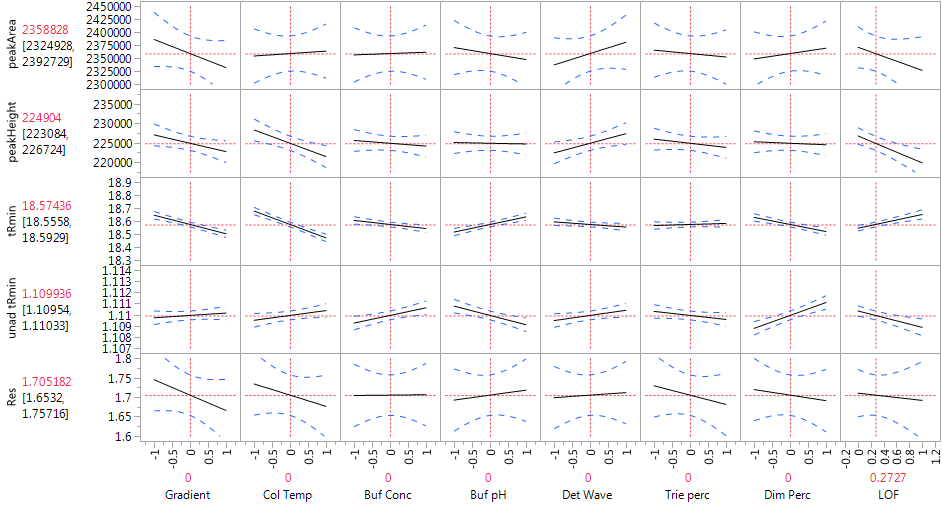
Figura 5. Profiler di esperimenti HPLC con modello lineare.
Cosa dobbiamo fare per la non linearità? La nostra analisi ha rilevato un effetto significativo dell'indicatore LOF, che indica un effetto non lineare che non viene considerato nel profiler della Figura 5. I punti centrali che abbiamo aggiunto al disegno fattoriale frazionario a due livelli ci consentono di rilevare la non linearità, ma non forniscono informazioni sufficienti per determinarne la causa: uno qualsiasi dei sette fattori (e forse molti di essi) potrebbe essere responsabile di l'effetto non lineare sull'altezza del picco.Nel nostro prossimo blog discuteremo alcune opzioni di progettazione per affrontare il problema. Per ora, mostriamo cosa abbiamo ottenuto con l'esperimento in corso. Dopo molto brainstorming, il team HPLC ha deciso che era molto probabile che il gradiente fosse il fattore che causava la non linearità. Questo importante presupposto, basato solo sulla conoscenza del processo, è cruciale per tutte le nostre successive conclusioni.Abbiamo provveduto ad adattare un modello ai dati sperimentali originali che include un effetto quadratico per Gradient. Il team ha anche deciso di mantenere solo i fattori con gli effetti principali più forti per ciascuna risposta; per peakHeight, i fattori erano gradiente, temperatura della colonna e lunghezza d'onda di rilevamento. Nella Figura 6, mostriamo le stime dei parametri dall'adattamento di questo modello ridotto alle risposte peakHeight. Con questo modello, tutti i termini sono significativi con una R rettificata 2 dell'89%.L'errore quadratico medio della radice, che stima la variazione da corsa a corsa con le stesse impostazioni dei fattori, è 1,754, leggermente inferiore all'1% della grandezza di peakHeight stesso (dopo aver diviso peakHeight per 1000).
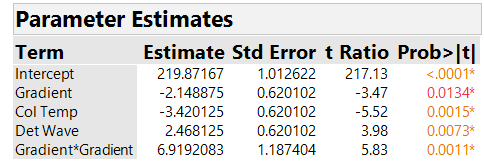
Figura 6. Stime dei parametri di peakHeight con modello quadratico. Per una migliore leggibilità, peakHeights è stato diviso per 1000.
Mostriamo un Profiler per il modello quadratico ridotto nella Figura 7. 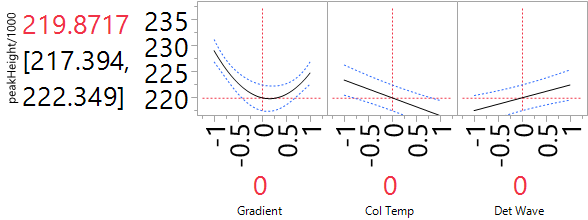
Figura 7. Profiler dell'esperimento HPLC con modello quadratico ridotto per peakHeight. Per una migliore leggibilità, peakHeights è stato diviso per 1000.
Trovare una soluzione solida
Uno degli obiettivi principali dell'esperimento era valutare la robustezza del sistema alla variazione dei fattori di input. Esploriamo questa domanda introducendo il rumore normale ai quattro fattori nel modello quadratico ridotto. Per ciascuno dei tre fattori, abbiamo assunto una deviazione standard di 0,4 (nelle unità codificate), che è l'opzione predefinita in JMP. Ciò riflette una visione secondo cui le impostazioni sperimentali sono circa 2,5 SD dal livello nominale, quindi riflettono deviazioni piuttosto estreme che potrebbero essere incontrate nella pratica. La Figura 8 presenta l'effetto del rumore su peakHeight per un'impostazione nel punto centrale che era stata inizialmente identificata come l'impostazione nominale.Possiamo calcolare la SD dei risultati simulati salvandoli in una tabella e utilizzando la scheda "distribuzione" in JMP. La SD risulta essere 2.397 ed è leggermente più grande della SD run-to-run calcolata in precedenza di 1.754. La SD complessiva associata al sistema analitico coinvolge entrambe queste componenti. Per combinarli, dobbiamo prima quadrarli, quindi aggiungerli (perché le varianze sono additivi, non SD) e quindi prendere una radice quadrata per tornare alla scala di misurazione originale. La DS combinata risultante è 2,970, quindi la variazione anticipata nelle impostazioni dei fattori porta a una DS maggiore di circa il 70% rispetto a quella della sola variazione da corsa a corsa.La SD complessiva è inferiore all'1,5% dei valori tipici di peakHeight ed è stata considerata accettabile per questo processo.
La nostra soluzione nominale è buona per la robustezza?
La figura 8 è molto utile per rispondere a questa domanda. Il fattore importante qui è Gradient, attraverso la sua relazione non lineare con peakHeight. La "valle" di quella relazione è vicina alla scelta nominale di 0. La nostra simulazione della variazione del fattore genera valori di Gradient che coprono l'intervallo da -1 a 1. Quando questi valori sono nella valle, trasmettono pochissime variazioni a peakHeight. Al contrario, quando sono vicini agli estremi, c'è una variazione sostanziale in peakHeight. Quindi il fatto che il fondovalle sia vicino all'impostazione nominale ci assicura che la variazione trasmessa sarà la più piccola possibile. Possiamo testare questa caratteristica spostando il valore nominale di Gradient. Quando il valore nominale è -0,5, il simulatore mostra che la SD dalla variazione del fattore aumenta a 4,282, quasi l'80% in più rispetto all'impostazione nominale a 0. La dipendenza di peakHeight da Col Temp e da Det Wave è lineare. Quindi, indipendentemente da come scegliamo le impostazioni nominali di questi fattori, trasmetteranno lo stesso grado di variazione all'uscita peakHeight. L'esperimento ci consente di valutare in che modo influiscono sulla robustezza, ma non offre alcuna opportunità di sfruttare i risultati per migliorare la robustezza.
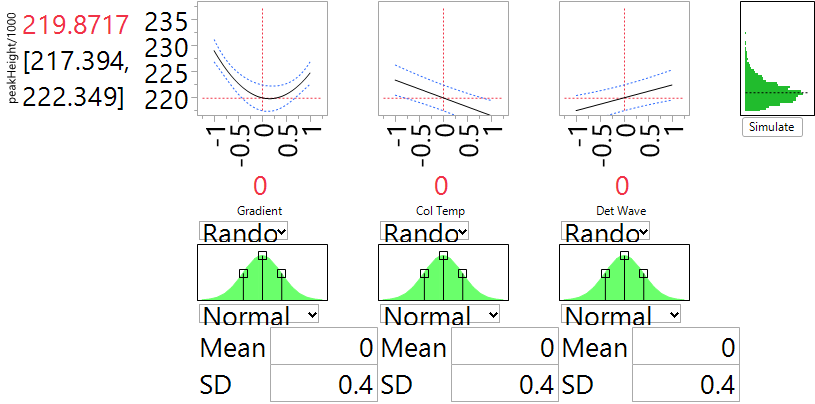
Figura 8. Prediction Profiler di peakHeight quando i fattori sono alle impostazioni nominali e la SD naturale è 0,4. Per una migliore leggibilità, peakHeights è stato diviso per 1000.
Tornando alle domande originarie
Passando in rassegna le domande originariamente poste, possiamo ora fornire le seguenti risposte:
1. Qual è la varianza di previsione della misurazione del metodo prevista per le impostazioni consigliate del metodo (l'incertezza di misurazione).
Risposta: Abbiamo esaminato questa domanda più da vicino per peakHeight, dove abbiamo scoperto che la SD è 2970, con contributi più o meno uguali dalla variazione da corsa a corsa e dalla variazione dei fattori del processo di misurazione.
2. Quale configurazione dei fattori sperimentali consentirà di ottenere prestazioni accettabili?
Risposta: Con tutti i fattori alle loro impostazioni nominali (valore codificato a 0), la SD di 2970 è inferiore all'1,5% della dimensione dei valori misurati, che è un livello di variazione accettabile in questa applicazione.
3. Quali sono i fattori che influiscono sulle prestazioni del metodo in una o più risposte?
Risposta: I tre fattori con il maggiore impatto sulle prestazioni del metodo sono il profilo del gradiente, la temperatura della colonna e l'onda di rilevamento.
4. Possiamo rendere robusta l'impostazione dei fattori sperimentali al fine di ottenere prestazioni che non siano sensibili alle variazioni dei livelli dei fattori?
Risposta: Abbiamo visto che possiamo migliorare la robustezza per peakHeight impostando il gradiente sul livello codificato di 0 (il livello nominale nell'esperimento). Tale impostazione ci aiuta a sfruttare l'effetto non lineare del gradiente e ridurre la variazione trasmessa.
5. Possiamo valutare l'impatto della variabilità dei fattori sperimentali sul metodo analitico?
Risposta: Come abbiamo notato in precedenza, la variabilità naturale dei fattori di input è responsabile di poco più della metà della variazione di peakHeight.
Incartare
Nell'esaminare le domande originariamente poste, abbiamo prima adattato un modello di regressione lineare. Dopo aver realizzato che esiste un effetto non lineare non contabilizzato, abbiamo utilizzato un modello quadratico ridotto e abbiamo scoperto che si adatta bene ai dati. Inducendo la variabilità nei fattori della quadratica ridotta (profilo del gradiente, temperatura della colonna e onda di rilevamento), potremmo stimare la variabilità dovuta al metodo e valutare la robustezza dell'impostazione consigliata. L'assunto del team che il gradiente sia responsabile della non linearità è chiaramente importante qui. Se anche altri fattori hanno effetti non lineari, potrebbero esserci conseguenze su come migliorare al meglio la robustezza del metodo. Esploreremo ulteriormente questo problema nel nostro prossimo post sul blog.
Appunti
[1] Borman, P., Nethercote, P., Chatfield, M., Thompson, D., Truman, K. (2007), Tecnologia farmaceutica. http://pharmtech.findpharma.com/pharmtech/Peer-Reviewed+Research/The-Application-of-Quality-by-Design-to-Analytical/ArticleStandard/Article/detail/463580
[2] Kenett, RS e Kenett, DA (2008), Quality by Design Applications in prodotti tecnologici biosimilari , Accreditamento e garanzia della qualità, Springer Verlag, vol. 13, n. 12, pp. 681-690.
[3] Romero R., Gasquez, D., Sanshez, M., Rodriguez, L. e Bagur, M. (2002), Un approccio geometrico al test di robustezza nell'HPLC analitico, LCGC North America, 20 , pp. 72-80, www.cromatografiaonline.com .
Lo sviluppo di metodi di misurazione o di analisi è parallelo allo sviluppo di prodotti farmaceutici.
KPA Group ha scritto: Grazie per il tuo commento, Phil!Gruppo KPA ha scritto:
Grazie per il tuo commento, Fil!
Phil Borman ha scritto: Oltre alle 5 foto cromatografiche...Phil Borman ha scritto:
Oltre alle 5 risposte di picco cromatografiche studiate sarebbe stato interessante studiare anche la quantità di ciascuna impurezza quantificata con il metodo analitico. Questo ti darebbe una vera indicazione della robustezza in quanto valuterà direttamente l'impatto sul risultato segnalabile. Le variazioni nell'area del picco e nell'altezza del picco possono essere irrilevanti se, ad esempio, le impurità vengono quantificate tramite la normalizzazione rispetto al picco principale (la sostanza farmaceutica in cui sono presenti).
