JMP 的腳本語言 JSL 是由函數調用構建的。 您可以在 JSL 中編寫的幾乎所有內容都是函數調用。 有些事情看起來不像函數調用:
A = A + 3;
很明顯,賦值語句的右側是一個表達式。 賦值語句本身是一個表達式不太明顯。
E = expr ( A = A + 3 );
expr 是一個包裝器,您可以在表達式周圍使用它來防止表達式求值。 E 設置為表達式,而不是表達式的評估結果。 要查看 E,請使用 head 函數。 Head 將返回表達式根處的函數名稱:
show( head(E) );
頭(E)=分配();
現在您看到有一個用於分配的功能:
Assign( testing, 3+4 );
7
show(testing)
測試 = 7;
JSL 中的表達式實際上是樹。 這是 a=a+3 樹的圖片,根在頂部,葉子在底部:
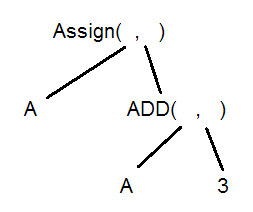
與 Head 函數類似,我們可以使用 Arg 函數來訪問 Assign 函數的子函數:
show( arg(E,1) );
Arg(E, 1) = A;左側
show( arg(E,2) );
Arg(E, 2) = A + 3;右手邊
並深入挖掘,
show(head(arg(E,2)))
頭(Arg(E,2))=添加();右手邊的頭
show(arg(arg(E,2),1))
Arg(Arg(E, 2), 1) = A;加號的左邊
show(arg(arg(E,2),2))
Arg(Arg(E, 2), 2) = 3;加號的右側
注意括號嵌套是如何描述樹的。 這棵樹只有二叉樹。 有一個功能,納爾格,返回孩子的數量。 它為葉節點返回 0。
narg(E)
2分配函數有兩個參數,左側和右側
JMP的為了statement 是一個函數調用,帶有四個參數。 注意逗號分隔參數,就像任何其他函數一樣。
halfCats = 1;
for( iCat = 1, iCat <= 10, iCat++,
   halfCats = halfCats / 2;
   write( iCat, " ", halfCats , "\!n" )
);
1 0.5
2 0.25
3 0.125
4 0.0625
5 0.03125
6 0.015625
7 0.0078125
8 0.00390625
9 0.001953125
10 0.0009765625
需要三個逗號來分隔四個參數。 在這個為了語句,第四個參數是兩個語句,用分號隔開。 查看第四個參數,看看它是否實際上也是一個函數:
Head(
    Arg(
        Expr(
            For( iCat = 1, iCat <= 10, iCat++,
               halfCats = halfCats / 2;
               Write( iCat, " ", halfCats, "\!n" );
            )
        ),
        4 /* the fourth arg */
    )
);
膠水()
膠水是將一系列語句組合在一起的函數的名稱。膠水的第一個參數是第一個語句,等等。
Arg(
Arg(
Expr(
For( iCat = 1, iCat <= 10, iCat++,
halfCats = halfCats / 2;
Write( iCat, " ", halfCats, "\!n" );
)
),
4 /* the fourth arg is two statements, glued together */
),
1 /* the first arg is the first of the two glued statements */
);
halfCats = halfCats / 2
JSL 列表是同一種表達式:
list={33,44,55};
show(head(list));
show(narg(list));
show(arg(list,3));
頭(列表)= {};列表顯示頭部的大括號,而不是像這樣的名稱分配
N Arg(列表) = 3;
參數(列表,3)= 55;
如果你只想要列表的內容,你應該使用普通的下標:
show(list[3]);
列表[3] = 55;
但有時你想做一些事情,比如將列表轉換為函數的參數。
在裡面大象發布後,您會找到一個將列表轉換為模式的示例(第 5 行)。 我很難想出另一個和那個一樣酷的例子,但假設你想檢查列表是否按字母順序排列。 JMP 的 < 運算符可以在單個函數調用中執行此操作:
LT = expr("a"<"b"<"c"<"d");
show(head(LT));
show(narg(LT));
頭(LT)=少();小於運算符顯示函數名稱,較少的
N Arg(LT) = 4;
Less 函數可以接受很多參數,但您不必鍵入它們。 以下,名稱Expr正在檢索存儲在單詞中的表達式,之後代入修改了 {列表} 成為較少的()。 然後,JMP 使用 < 顯示 Less 函數以使其更具可讀性。
words =
{"Alpha", "Bravo", "Charlie", "Delta", "Echo", "Foxtrot", "Golf", "Hotel", "India",
"Juliet", "Kilo", "Lima", "Mike", "November", "Oscar", "Papa", "Quebec", "Romeo",
"Sierra", "Tango", "Uniform", "Victor", "Whiskey", "Xray", "Yankee", "Zulu"};
Substitute Into( words, Expr( {} ), Expr( Less() ) );
nameExpr(words);
“阿爾法”<“布拉沃”<“查理”<“德爾塔”<“迴聲”<“狐步舞”<“高爾夫”<“酒店”<
《印度》<《朱麗葉》<《基洛》<《利馬》<《邁克》<《十一月》<《奧斯卡》<《爸爸》<
“魁北克”<“羅密歐”<“塞拉”<“探戈”<“制服”<“維克多”<“威士忌”<“X射線” <“洋基”<“祖魯”
eval(words)
1評估(words) 返回 1,表示 Less 的結果為真。
另一個例子。
2017 年 2 月 28 日更新 - 修復新社區的格式
Craig,這篇文章對我繼續探索如何處理表達式很有幫助。
實際上,我為您的最後一個技巧提供了一個很好的應用程序,您將列表中的項目轉換為 Less() 函數的參數。 我想根據來自對話框窗口的用戶輸入生成一個包含 Col Mean() 函數的列公式。 Col Means() 函數接受一個或多個參數,而我從來沒有一種巧妙的方法可以將不同數量的參數(通常是變量名)替換為函數。 以下是我腳本中的關鍵行:
arglist = {“身高”、“年齡”、“性別”}; // 對話窗口的結果
statformula = Substitute (arglist, Expr( {} ), Expr( Col Mean() ) ); // arglist 中的項目成為 Col Means() 函數中的參數
newcol << 公式(名稱表達式(統計公式));
實際的腳本更複雜,因為它需要處理需要 Name(" ") 的雜亂列名,但你明白了。 感謝您向我展示了這個巧妙的技巧。
霍華德·勞赫
