正確和不當使用最終篩選設計 (DSD)2011 年,我和我的同事 Chris Nachtsheim 教授介紹了最終篩選設計(DSDs)與一篇論文在質量技術雜誌. 一年後,我寫了一篇JMP 博客文章使用相關單元圖描述這些設計。 自推出以來,DSD 已在油漆製造、生物技術、綠色能源和激光蝕刻等多種領域得到應用。
當一種新的、令人興奮的方法出現時,前沿研究人員自然傾向於嘗試它。 當這些研究人員報告積極的結果時,它鼓勵其他人也嘗試新方法。
當然,我是 DSD 的忠實粉絲,但作為共同發明者,我覺得對 DSD 的從業者社區負有責任實驗設計(DOE)明確它們的預期用途和可能的誤用。
那麼什麼時候應該使用DSD呢?
顧名思義,DSD 是篩選設計。 它們最合適的用途是在實驗的最初階段,此時有大量可能影響感興趣響應的潛在重要因素,並且目標是確定通常數量少得多的高影響因素時。
因為他們是篩選實驗,所以只有當我有四個或更多因素時,我才會使用 DSD。 此外,如果我只有四個因子並且想使用 DSD,我將為六個因子創建一個 DSD,並刪除最後兩列。 由此產生的設計可以在四個因子中的任何三個中擬合完整的二次模型。
當大多數因素是連續的時,DSD 效果最好。 這是因為每個連續因素都有三個水平,允許調查人員為每個連續因素擬合曲線而不是直線。
什麼時候使用 DSD 不合適?
下面,最優裂區設計顯著優於通過對難以改變的因子 wp 進行排序而創建的確定性篩選設計。 見下文第 4) 點。
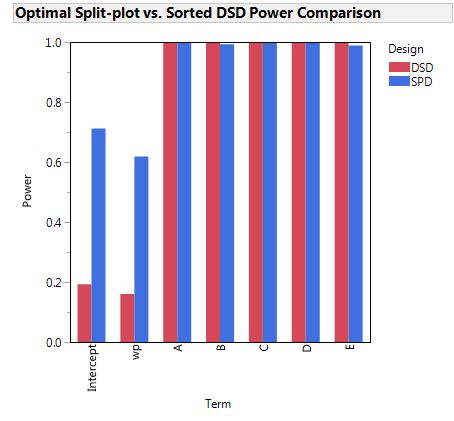
1) 當設計區域有限制時
使用 DSD 背後的一個隱含假設是,可以獨立於任何其他因素的水平設置任何因素的水平。 如果對設計區域的約束使某些因素組合不可行,則違反此假設。 例如,如果我正在烹飪爆米花,我不想在長時間烹飪時將功率設置為最高。 我知道如果我這樣做,我最終會變成一團燒焦的爛攤子。
向內繪製因子的範圍以避免此類問題可能很誘人,但這種做法會降低 DSD 檢測主動效應的能力。 最好使用整個可行區域,即使該區域的形狀不是立方體或球形。
2)當某些因素是混合物中的成分時
同樣,如果兩個或多個因子是混合物中的成分,則使用 DSD 是不合適的。 如果我提高一種成分的百分比,我必須降低另一種成分的百分比,所以這些因素不能根據它們的性質獨立變化。
3)當有兩個以上水平的分類因素時
DSD 可以在兩個級別上處理一些分類因素,但如果大多數因素都是分類因素,則使用 DSD 是低效的。 此外,如果分類因素有兩個以上的水平,DSD 通常是不受歡迎的選擇。 最近在實驗設計 (DOE) LinkedIn 組中的討論涉及嘗試修改 DSD 以適應三級分類因素。 雖然這是可能的,但它需要使用定制設計工具JMP將 DSD 的因素視為協變量因素,並添加三水平分類因素作為其水平由定制設計算法選擇的唯一因素。
4) 當 DSD 作為裂區設計運行時
通過對一個因子的設置進行排序以使結果設計為裂區設計來更改 DSD 也是不合適的。 對於六因子 DSD,排序因子將只有三個設置。 在低設置下運行五次,在中間設置下運行三次,在高設置下運行。 使用這樣的設計意味著對排序因子的影響的推斷在統計上是無效的。
5)當感興趣的先驗模型具有高階效應時
對於 DSD,三次項與主效應混淆,因此不可能確定三次效應。
常規的兩水平部分因子設計和 Plackett-Burman 設計也不適用於上述大多數情況。 因此,它們不是可行的替代方案。
在上述情況下使用 DSD 的替代方法是什麼?
對於用戶JMP ,答案很簡單:使用定制設計工具。
JMP 中的定制設計工具可以生成設計,以適應上述場景的任意組合。 定制設計工具背後的指導原則是
“設計應該適應問題,而不是改變問題以適應設計。”
最後的想法
DSD 在創建它們的場景中是非常有用的設計。 作為篩選設計,它們具有許多理想的特性:
1) 主效應是正交的。
2) 主效應與雙因素交互作用 (2FI) 和二次效應正交。
3)所有連續因子的二次效應都是可估計的。
4) 沒有 2FI 與任何其他 2FI 或二次效應混淆,儘管它們可能相關。
5) 對於具有 13 次或更多運行的 DSD,可以將完整的二次模型擬合到任何三因子子集中。
6)DSD可以容納一些具有兩個級別的分類因素。
7) 阻止 DSD 非常靈活。 如果有米因素,您可以有 2 到 2 之間的任意數量的塊米.
8) DSD 的現場成本很低,只需要至少 2 個米+1 運行。
9) 您可以通過創建一個具有比必要因素更多的 DSD 並刪除額外因素來將運行添加到 DSD。 由此產生的設計具有上述所有前七個屬性,並且具有更大的功能以及識別更多二階效應的能力。
在我看來,上述特性使 DSD 成為大多數因素是連續的任何篩選實驗的最佳選擇。
但是,我想明確指出,使用渠務署不是靈丹妙藥. 換句話說,DSD 並不是所有實驗設計問題的解決方案。
 我是 DSD 的忠實粉絲,但作為共同發明者,我感到有責任明確它們的預期用途和可能的誤用。
回复:正確和不當使用最終篩選設計 (DSD)回复 Varun_Bhatt:
如果一個模型項與另一個模型項(比如兩個 2FI)相關 +1 或 -1,那麼我們說這些項是混淆的。 在這種情況下,沒有純粹的數據驅動方式來區分它們對感興趣響應的影響。
但是,如果相關性小於 1,則模型項對響應的單獨影響現在是可估計的。 但是,這些影響的估計值的方差將大於這兩個項不相關的情況。 我們稱這種現象為方差膨脹。 幅度相關性越大,方差膨脹越大。
如果與效應的大小相比誤差方差較小,則方差膨脹不是主要問題。 這就是為什麼關於何時擔心方差膨脹的傳統經驗法則是錯誤的。
回复:正確和不當使用最終篩選設計 (DSD)請您詳細說明這部分,“沒有 2FI 與任何其他 2FI 或二次效應混淆,儘管它們可能相關。”
想知道混雜因素和相關因素之間的區別。 它們有何不同? 它們對模型的影響有何不同?
謝謝
回复:正確和不當使用最終篩選設計 (DSD)布拉德,
感謝您提供有關正確使用 DSD 的進一步意見。
大約一年前,我使用 DSD 進行計算機模擬,其中包含大約 100 個連續因子,也需要所有二階效應,總運行次數約為 200。 結果不如定制設計的結果令人滿意。 從那時起,我就避免使用 DSD 進行有很多因素的建模和仿真,儘管我發現 DSD 對較少的因素非常有用,比如少於 12 個。 我是否應該在 M&S 運行中僅使用主效應,然後運行另一個因子數量少得多的 DSD 來確認二階效應?
曼尼
回复:正確和不當使用最終篩選設計 (DSD)瓊斯博士,
我使用 DSD 已經有一段時間了,並且取得了一些成功。 但是,我現在正在研究將 DSD 用於二進制響應(增長/無增長)。 這可以用 DSD 完成嗎?您將如何分析響應,因為我猜它不是內置在 DSD 分析算法中的? 或者你會使用其他類型的設計嗎?
最好的,
埃伍德·舒林
回复:正確和不當使用最終篩選設計 (DSD)瓊斯博士,
感謝您的周到和周到的答复。 感謝您的時間和考慮。 我將直接與您繼續討論。
乾杯,
賬單
回复:正確和不當使用最終篩選設計 (DSD)羅斯博士 - 你 16,000 次 DOE 的經歷給我留下了深刻的印象。 感謝您長期使用 JMP。 您成為 JMPer 的時間比我長!
下面我將解決您的五組問題和疑慮。
1)你指出新手實驗者傾向於將連續因子的水平設置得太接近。 我也看到了這種行為。 我相信工程師認為世界是非線性的。 他們還從微積分中知道,如果變化也很小,那麼與線性的偏差也很小。 問題是當一個因子的變化很小時,響應中的噪聲會傳播到估計的線斜率中的大噪聲,從而難以識別活動因子。 因此,在教學 DOE 時,我們鼓勵學生大膽地改變連續因素。 我相信,正如 DSD 所提供的那樣,為每個因子設置低、中、高值可以使工程師更有信心分散因子的水平。 這是因為如果存在強曲率,DSD 可以檢測到強曲率,從而消除了對非線性的擔憂。
2. 我在上面的博客中提到,當大多數因素是連續的時,DSD 是合適的篩選設計。 當有三個以上的兩級分類因素時,我不願意使用 DSD。 當大多數或所有因素在兩個級別上都是分類的時,我會推薦高效折疊設計。 這是有關這些設計的文章的參考。Anna Errore、Bradley Jones、William Li 和 Christopher J. Nachtsheim (2017) 高效兩層折疊設計的優勢和快速構建,技術計量學, 59:1, 48-57, DOI: 10.1080/00401706.2015.1124052
我還認為,調查人員可以更加努力地提出定量指標來描述分類因子的兩個水平之間的差異,從而成功地將分類因子轉變為更有意義的連續因子。
3. 你認為中心點可以檢測曲率。 這是真的,但他們無法識別導致曲率的因素。 這種模糊性迫使後續實驗,如果使用 DSD,這是不必要的。 我看過一個案例研究,其中強二次效應在實驗區域內具有最小值。最小響應是可取的,並且使用兩級設計將無法檢測到此處的最佳位置。 另一個案例研究發現了一個強烈的二次效應,其中最大響應位於實驗區域內。這裡, 一個最大的響應是可取的,而且使用兩級設計也無法檢測到最佳位置。 在 DSD 中包含估計所有二次效應的能力的成本是主效應的置信區間長度增加 10%(或更少)。 對於二階效應的信息增益,這似乎是一個很小的代價。
4. 您正確地指出,有時識別噪聲源可能比估計固定效應更重要。 在這種情況下,複製設計點很有用,這樣可以識別影響響應方差的因素,同時評估這些因素對平均響應的影響。 複製整個 DSD 的成本大約是因子數的四倍。 您在這一點上提到了阻塞。 阻塞可以識別和量化變異性的一種來源,並從逐次變異中消除其影響。 當改變環境條件在響應中引入噪音時,阻塞是一種有用的補救措施。 與兩水平部分因子或全因子設計相比,DSD 可以更靈活地阻止。 以下是對描述如何阻止 DSD 的論文的參考。
Bradley Jones 和 Christopher J. Nachtsheim (2015):確定性篩選設計的阻止方案,技術計量學, DOI: 10.1080/00401706.2015.1013777
5. 你最後關心的是教授 DSD 和對迭代實驗方法的關心。 我不會將 DSD 宣傳為“一次性”實驗。 確實,傳統部分因子設計的混疊結構很簡單,也很容易解釋。 然而,在我看來,它們對潛在重要影響的完全混疊是不可取的。 看
Bradley Jones (2016) 21 世紀篩選實驗:內容、原因和方式,質量工程, 28:1, 98-106, DOI: 10.1080/08982112.2015.1100462
上述文章是由三位討論者組成的討論文件。 我的反駁處理了許多問題,包括在最初的 DSD 研究之後的順序設計 - 參考如下。
布拉德利·瓊斯 (Bradley Jones) (2016) 反駁,質量工程, 28:1, 122-126, DOI: 10.1080/08982112.2015.1100468
下面的參考文獻處理了使用初始 DSD 的相對好處,即使預測的最佳響應在實驗區域之外。 它還提供了一種強大的後續設計方法,可以勝過最陡峭的上升。
Christopher J. Nachtsheim & Bradley Jones (2018) 響應優化和模型估計的設計增強,質量工程, 30:1, 38-51, DOI: 10.1080/08982112.2017.1382298
我認為沒有必要教從業者如何創建 DSD。 許多軟件包可以做到這一點。 我認為讓調查人員熟悉相關單元圖很有用。 JMP 提供了許多用於評估和比較設計的診斷工具。 這些非常有用,在短期課程和大學課程中教授它們的使用將使能源部從業者社區受益。 對於從業者來說,了解如何利用 DSD 的特殊幾何形狀來擬合合適的模型是很有用的。 這在下面的參考文獻中得到解決。
Bradley Jones 和 Christopher J. Nachtsheim (2016):有效的基於設計的模型選擇,用於確定性篩選設計,技術計量學, DOI: 10.1080/00401706.2016.1234979
我很樂意繼續這個對話並向您發送參考資料的 pdf。 您可以通過 bradley.jones@jmp.com 與我聯繫
回复:正確和不當使用最終篩選設計 (DSD)Jones 博士,我是 JMP 的長期用戶(從第一個版本開始),感謝您對行業的貢獻。 我參與了跨多個行業的 16,000 多個實驗的設計和分析。 也許這是錯誤的論壇,但我有一些問題/意見(我希望不要冒犯),並會重視您的意見。
1. 在篩選設計方面,最常見的失敗模式之一(尤其是對於新手實驗者)是關卡設置得不夠大(足夠大膽)。 因此,它們的影響並未實現,這些因素甚至可能從進一步的研究中剔除(我的假設是工程師不願意創造太多的變化,他們仍在尋找解決方案而不是了解因果關係)。 在我看來,將級別數增加到三個會使這種故障模式進一步複雜化?
2. 在設計初期,很多因素都是定性的。 似乎限制在設計中添加太多定性因素是一種負擔。 也許這種策略更適用於順序研究中的後期迭代?
3. 篩選設計通常是為了獲得方向並過濾掉無關緊要的因素,或者更有可能確定重要因素以供進一步研究。 二次方程真的需要完成這個嗎? 好的,我想可能存在水平設置太粗的情況,因此錯過了顯著的效果,但可以通過中心點很容易地糾正這種情況。 如果二次方本質上是與線性的背離,那麼如果您的設計空間遠離最優,您會不會首先對線性效應更感興趣? 山腳下的二次方程可能無法讓你到達山頂。
4. 此外,也許最重要的是,處理噪聲的策略可能比設計因素的分辨率更重要(正如您所知,在設計因素分辨率和噪聲效應解決之間為有效利用資源而不斷鬥爭) . 如果使用隨機完整區組設計 (RCBD),我們真的需要一些更高階的逐個效應交互嗎? 如果使用平衡不完整塊設計,那麼理解混疊有多容易?
5. 最後,也許對從業者來說最不重要的是,DSD 是如何教授的? 使用具有可識別混疊的傳統部分因子設計和折疊到去混疊等想法是直截了當的。 灌輸迭代的思維方式和實踐至關重要。 DSD 如何適應迭代的、科學的實驗方法?
我提前感謝您的想法。
如果您更願意將此討論脫線,那對我來說很好。 您可以直接在 comcast dot net 的 statman 給我發電子郵件
乾杯,
比爾·羅斯
回复:正確和不當使用最終篩選設計 (DSD)謝謝布拉德,內容豐富的帖子和良好的反應,幫助我了解了更多關於 DSD 的信息。
回复:正確和不當使用最終篩選設計 (DSD)謝謝 Jones 博士 - ASQ Technometrics 網站上尚未提供此問題。我會期待它盡快出版。
理查德
回复:正確和不當使用最終篩選設計 (DSD)http://dx.doi.org/10.1080/00401706.2016.1234979
以上是 Chris Nachtsheim 和我在期刊 Technometrics 上發表的一篇論文的 URL,標題為 Effective Design-Based Model Selection for Definitive Screening Designs。
本文為添加我們所謂的“假因素”(即用於創建設計但在運行實驗時未使用的因素)提供了強大的動力。 在 JMP 13 中,DSD 設計工具將此稱為“Extra Runs”,默認值為 4。 但是,您可以將此字段更改回 0 以獲得最小運行 DSD。 添加這些額外的運行允許強大的替代分析方法。
回复:正確和不當使用最終篩選設計 (DSD)是否發布瞭如下所述刪除列的示例?
相反,如果您使用 8 因子 DSD 並忽略最後 3 列,您將有 17 次試驗設計,您應該能夠識別四個或五個二階效應。
回复:正確和不當使用最終篩選設計 (DSD)當因素和相互作用太多時,DSD肯定會遇到麻煩! 我在經過幾代優化的催化劑系統中嘗試了一種,它具有許多功能性催化劑組分和相互作用。 我最終不得不添加相當多的運行。
回复:正確和不當使用最終篩選設計 (DSD)很棒的帖子。 然而,我有一個問題讓我感到困惑。 您提到您可以通過採用更高的 m 設計並刪除額外的列來輕鬆添加額外的運行。 我想知道是否有任何簡單的方法可以將運行“附加”到設計中。 例如,我已經完成了 am=5 DSD 運行,然後我決定我需要更多的功率,並且想在之後添加一些額外的運行。 我怎麼做? (例如,如果我取 m=7 並刪除最後兩列並將其與 m=5 進行比較,那麼我將不再獲得相同的行)。 謝謝!
Bradley Jones 寫道: 為驗證做計劃總是好的...布拉德利瓊斯寫道:
計劃驗證運行總是好的。 這些是您在運行實驗並分析數據後執行的運行。 分析的結果是一個模型,您可以使用該模型在實驗中未運行的因子設置下進行響應預測。 考慮到您的響應目標,您可以選擇在模型預測最大改進的一個(或多個)因子設置下運行驗證運行。
這與設計增強不同,後者擴展了因子的範圍,為模型添加了項,或者添加了更多的遊程以減少當前模型中估計的不確定性。
Bradley Jones 寫道: 我相信日常使用...布拉德利瓊斯寫道:
對於工業設計實驗中的大多數問題,我相信定制設計器的常規使用。 當幾乎所有因素都是連續的並且可以在整個範圍內獨立變化時,確定性篩選設計是一個不錯的選擇。
當我進行蒙特卡洛計算機模擬研究時,我有時會使用全因子設計,其中唯一的費用是計算機時間。 我同意現在有比常規的兩水平部分因子設計更好的選擇。
Steven Moore 寫道: 所以....我一直在使用 Definitive Sc...史蒂文·摩爾寫道:
所以....我使用確定性篩選設計和定制設計已經有一段時間了。 在我看來,沒有理由再使用傳統的因子設計了。我是正確的,還是我錯過了什麼?
Jo Chotix 寫道: 看起來我們將能夠改變每個...喬喬蒂克斯寫道:
看起來我們將能夠獨立地改變每個組件。 我應該計劃進行一些驗證運行嗎? 如何為這些/因素計劃設計(運行次數,驗證的設計點等)? 這與增強設計有何不同? 謝謝!
Bradley Jones 寫道: 使用 DSD 可能是合適的......布拉德利瓊斯寫道:
使用 DSD 可能是合適的,但我擔心改變治療濃度的 4 個因素可能被視為混合物中的成分。 如果是這樣,那將使得使用 DSD 不合適,但有一個例外。 如果混合物中的主要成分是無活性的填充劑,那麼其他成分可以獨立變化。 在這種情況下,可以使用 DSD。
Jo chotix 寫道: 我正在考慮使用 DSD 來設計...喬喬蒂克斯寫道:
我正在考慮使用 DSD 為體內小鼠研究設計治療計劃。 我有 4 個因素會改變治療的濃度(例如濃縮藥物、賦形劑混合物等),還有一個因素關注於小鼠的年齡。 我想知道這是否是您推薦 DSD 的原因?
Bradley Jones 寫道: 您可以將 3 個分類因素添加到...布拉德利瓊斯寫道:
您可以向 DSD 添加 3 個分類因素,而不會使設計效率低下。 以下是我和 Chris Nachtsheim 就該主題發表的一篇論文的參考。
瓊斯,布拉德利和 Nachtsheim,CJ (2013) â 確定性篩選設計與添加的兩級分類因素â,質量技術雜誌,45:2,120-129。
Ewoud Schuring 寫道: 你好布拉德利,有趣的博客,...埃伍德·舒林寫道:
你好布拉德利,
有趣的博客,其實整個 DSD 對我來說都很有趣。 但是我確實有一個問題。
DSD中分類因素的數量限制是多少? 目前我正在嘗試創建一個具有 3 個連續和 3 個分類因素的 DSD。 這是一個好主意嗎? 有哪些風險? 還是連續與分類的 1/1 比率導致設計效率低下?
Bradley Jones 寫道: 保羅,帶有一些 r 的定制設計...布拉德利瓊斯寫道:
保羅,
具有少量複製的定制設計是一種非常安全的響應面設計。 我的經驗是,通常很少有大的二階效應。 因此,構建一個可以估計每一個二階效應的設計可能最終會過度殺傷力。 6 因子 DSD 只需要 13 次運行,就可以可靠地識別兩個或三個二階效應。 這將為您節省近 50% 的成本。
相反,如果您使用 8 因子 DSD 並忽略最後 3 列,您將有 17 次試驗設計,您應該能夠識別四個或五個二階效應。
Paul Prew 寫道: 你好布拉德利,這篇文章讓我...保羅·普魯寫道:
你好布拉德利,這篇文章讓我想到了 4-6 個因素的適當設計。 具體來說,上週,我有一位化學家想研究 5 個連續因子。 初步的一次一個因素的測試告訴她,它們很重要。 她對 DOE 一無所知,但她的主管告訴她這是一條更有效的途徑——去與統計學家交談。
我們處於一個灰色地帶,純粹的篩選設計看起來像是倒退了一步,效率低下。 因此,我們選擇設計二次模型,從而實現了 25 次運行的定制設計,並進行了幾次復制。
謝謝,保羅
5 因子 DSD 的運行次數會少得多,即使設計為 6 或 7 個因子並刪除額外的列。 如何使用 JMP 將 DSD 評估為適合二階模型的良好設計? 您會推薦哪些特定的設計評估工具來比較 DSD 和定制設計?
Ron Andrews 寫道: 我發現了一個 DSD 的應用程序...羅恩·安德魯斯寫道:
我找到了一個適用於 DSD 的應用程序,其中混合了有效的混合物。 我需要確認用於製造隱形眼鏡的單體混合物的重量規格。 這是一種真正的混合,而不是解決方案,因此在大多數情況下,DSD 不是一個好的選擇。 使它起作用的是名義上的微小變化。 名義公式被用作中心點。 每個組件的變化幅度為標稱值的 +/- 1%。 為了分析實驗,我計算了每種混合物的實際濃度。 混合物中最大的兩個成分之間存在顯著相關性,但設計允許對這兩個因素進行單獨估計。
我已經提交了一份發現峰會演示文稿的摘要,其中將其作為混合設計替代方案的示例之一。 不管它是否被接受,我可以提供更多細節。
