正确和不当使用最终筛选设计 (DSD)2011 年,我和我的同事 Chris Nachtsheim 教授介绍了最终筛选设计(DSDs)与一篇论文在质量技术杂志. 一年后,我写了一篇JMP 博客文章使用相关单元图描述这些设计。 自推出以来,DSD 已在油漆制造、生物技术、绿色能源和激光蚀刻等多种领域得到应用。
当一种新的、令人兴奋的方法出现时,前沿研究人员自然倾向于尝试它。 当这些研究人员报告积极的结果时,它鼓励其他人也尝试新方法。
当然,我是 DSD 的忠实粉丝,但作为共同发明者,我觉得对 DSD 的从业者社区负有责任实验设计(DOE)明确它们的预期用途和可能的误用。
那么什么时候应该使用DSD呢?
顾名思义,DSD 是筛选设计。 它们最合适的用途是在实验的最初阶段,此时有大量可能影响感兴趣响应的潜在重要因素,并且目标是确定通常数量少得多的高影响因素时。
因为他们是筛选实验,所以只有当我有四个或更多因素时,我才会使用 DSD。 此外,如果我只有四个因子并且想使用 DSD,我将为六个因子创建一个 DSD,并删除最后两列。 由此产生的设计可以在四个因子中的任何三个中拟合完整的二次模型。
当大多数因素是连续的时,DSD 效果最好。 这是因为每个连续因素都有三个水平,允许调查人员为每个连续因素拟合曲线而不是直线。
什么时候使用 DSD 不合适?
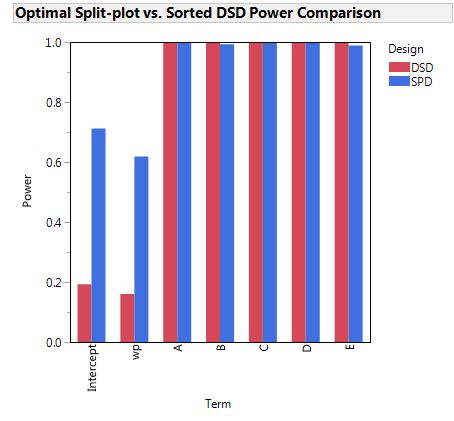
下面,最佳裂区设计显着优于通过对难以改变的因子 wp 进行排序而创建的确定筛选设计。 见下文第 4) 点。
1) 当设计区域有限制时
使用 DSD 背后的一个隐含假设是,可以独立于任何其他因素的水平设置任何因素的水平。 如果对设计区域的约束使某些因素组合不可行,则违反此假设。 例如,如果我正在烹饪爆米花,我不想在长时间烹饪时将功率设置为最高。 我知道如果我这样做,我最终会变成一团烧焦的烂摊子。
可能很想将因子的范围向内绘制以避免此类问题,但这种做法会降低 DSD 检测主动效应的能力。 最好使用整个可行区域,即使该区域的形状不是立方体或球形。
2)当某些因素是混合物中的成分时
同样,如果两个或多个因素是混合物中的成分,则使用 DSD 是不合适的。 如果我提高一种成分的百分比,我必须降低另一种成分的百分比,所以这些因素不能根据它们的性质独立变化。
3)当有两个以上水平的分类因素时
DSD 可以在两个级别上处理一些分类因素,但如果大多数因素都是分类因素,则使用 DSD 是低效的。 此外,如果分类因素有两个以上的水平,DSD 通常是不受欢迎的选择。 最近在实验设计 (DOE) LinkedIn 组中的讨论涉及尝试修改 DSD 以适应三级分类因素。 虽然这是可能的,但它需要使用定制设计工具JMP将 DSD 的因素视为协变量因素,并添加三水平分类因素作为其水平由定制设计算法选择的唯一因素。
4) 当 DSD 作为裂区设计运行时
通过对一个因子的设置进行排序以使结果设计为裂区设计来更改 DSD 也是不合适的。 对于六因子 DSD,排序因子将只有三个设置。 在低设置下运行五次,在中间设置下运行三次,在高设置下运行。 使用这样的设计意味着对排序因子的影响的推断在统计上是无效的。
5)当感兴趣的先验模型具有高阶效应时
对于 DSD,三次项与主效应混淆,因此不可能确定三次效应。
常规的两水平部分因子设计和 Plackett-Burman 设计也不适用于上述大多数情况。 因此,它们不是可行的替代方案。
在上述情况下使用 DSD 的替代方法是什么?
对于用户JMP ,答案很简单:使用定制设计工具。
JMP 中的定制设计工具可以生成设计,以适应上述场景的任意组合。 定制设计工具背后的指导原则是
“设计应该适应问题,而不是改变问题以适应设计。”
最后的想法
DSD 在创建它们的场景中是非常有用的设计。 作为筛选设计,它们具有许多理想的特性:
1) 主效应是正交的。
2) 主效应与双因素交互作用 (2FI) 和二次效应正交。
3)所有连续因子的二次效应都是可估计的。
4) 没有 2FI 与任何其他 2FI 或二次效应混淆,尽管它们可能相关。
5) 对于具有 13 次或更多运行的 DSD,可以将完整的二次模型拟合到任何三因子子集中。
6)DSD可以容纳一些具有两个级别的分类因素。
7) 阻止 DSD 非常灵活。 如果有米因素,您可以有 2 到 2 之间的任意数量的块米.
8) DSD 的现场成本很低,只需要至少 2 个米+1 运行。
9) 您可以通过创建一个具有比必要因素更多的 DSD 并删除额外因素来将运行添加到 DSD。 由此产生的设计具有上述所有前七个属性,并且具有更大的功能以及识别更多二阶效应的能力。
在我看来,上述特性使 DSD 成为大多数因素是连续的任何筛选实验的最佳选择。
但是,我想明确指出,使用渠务署不是灵丹妙药. 换句话说,DSD 并不是所有实验设计问题的解决方案。
 我是 DSD 的忠实粉丝,但作为共同发明者,我感到有责任明确它们的预期用途和可能的误用。
回复:正确和不当使用最终筛选设计 (DSD)回复 Varun_Bhatt:
如果一个模型项与另一个模型项(比如两个 2FI)相关 +1 或 -1,那么我们说这些项是混淆的。 在这种情况下,没有纯粹的数据驱动方式来区分它们对感兴趣响应的影响。
但是,如果相关性小于 1,则模型项对响应的单独影响现在是可估计的。 但是,这些影响的估计值的方差将大于这两个项不相关的情况。 我们称这种现象为方差膨胀。 幅度相关性越大,方差膨胀越大。
如果与效应的大小相比误差方差较小,则方差膨胀不是主要问题。 这就是为什么关于何时担心方差膨胀的传统经验法则是错误的。
回复:正确和不当使用最终筛选设计 (DSD)请您详细说明这部分,“没有 2FI 与任何其他 2FI 或二次效应混淆,尽管它们可能相关。”
想知道混杂因素和相关因素之间的区别。 它们有何不同? 它们对模型的影响有何不同?
谢谢
回复:正确和不当使用最终筛选设计 (DSD)布拉德,
感谢您提供有关正确使用 DSD 的进一步意见。
大约一年前,我使用 DSD 进行计算机模拟,其中包含大约 100 个连续因子,也需要所有二阶效应,总运行次数约为 200。 结果不如定制设计的结果令人满意。 从那时起,我就避免使用 DSD 进行有很多因素的建模和仿真,尽管我发现 DSD 对较少的因素非常有用,比如少于 12 个。 我是否应该在 M&S 运行中仅使用主效应,然后运行另一个因子数量少得多的 DSD 来确认二阶效应?
曼尼
回复:正确和不当使用最终筛选设计 (DSD)琼斯博士,
我使用 DSD 已经有一段时间了,并且取得了一些成功。 但是,我现在正在研究将 DSD 用于二进制响应(增长/不增长)。 这可以用 DSD 完成吗?您将如何分析响应,因为我猜它不是内置在 DSD 分析算法中的? 或者你会使用其他类型的设计吗?
最好的,
埃伍德·舒林
回复:正确和不当使用最终筛选设计 (DSD)琼斯博士,
感谢您的周到和周到的答复。 感谢您的时间和考虑。 我将直接与您继续讨论。
干杯,
账单
回复:正确和不当使用最终筛选设计 (DSD)罗斯博士 - 你 16,000 次 DOE 的经历给我留下了深刻的印象。 感谢您长期使用 JMP。 您成为 JMPer 的时间比我长!
下面我将解决您的五组问题和疑虑。
1)你指出新手实验者倾向于将连续因子的水平设置得太接近。 我也看到了这种行为。 我相信工程师认为世界是非线性的。 他们还从微积分中知道,如果变化也很小,那么与线性的偏差也很小。 问题是当一个因子的变化很小时,响应中的噪声会传播到估计的线斜率中的大噪声,从而难以识别活动因子。 因此,在教学 DOE 时,我们鼓励学生大胆地改变连续因素。 我相信,正如 DSD 所提供的那样,为每个因子设置低、中、高值可以使工程师更有信心分散因子的水平。 这是因为如果存在强曲率,DSD 可以检测到强曲率,从而消除了对非线性的担忧。
2. 我在上面的博客中提到,当大多数因素是连续的时,DSD 是合适的筛选设计。 当有三个以上的两级分类因素时,我不愿意使用 DSD。 当大多数或所有因素在两个级别上都是分类时,我会推荐高效折叠设计。 这是有关这些设计的文章的参考。Anna Errore、Bradley Jones、William Li 和 Christopher J. Nachtsheim (2017) 高效两层折叠设计的优势和快速构建,技术计量学, 59:1, 48-57, DOI: 10.1080/00401706.2015.1124052
我还认为,调查人员可以更加努力地提出定量指标来描述分类因子的两个水平之间的差异,从而成功地将分类因子转变为更有意义的连续因子。
3. 你认为中心点可以检测曲率。 这是真的,但他们无法识别导致曲率的因素。 这种模糊性迫使后续实验,如果使用 DSD,这是不必要的。 我看过一个案例研究,其中强二次效应在实验区域内具有最小值。最小响应是可取的,并且使用两级设计将无法检测到此处的最佳位置。 另一个案例研究发现了一个强烈的二次效应,其中最大响应位于实验区域内。这里, 一个最大的响应是可取的,而且使用两级设计也无法检测到最佳位置。 在 DSD 中包含估计所有二次效应的能力的成本是主效应的置信区间长度增加 10%(或更少)。 对于二阶效应的信息增益,这似乎是一个很小的代价。
4. 您正确地指出,有时识别噪声源可能比估计固定效应更重要。 在这种情况下,复制设计点很有用,这样可以识别影响响应方差的因素,同时评估这些因素对平均响应的影响。 复制整个 DSD 的成本大约是因子数的四倍。 您在这一点上提到了阻塞。 阻塞可以识别和量化变异性的一种来源,并从逐次变异中消除其影响。 当改变环境条件在响应中引入噪音时,阻塞是一种有用的补救措施。 与两水平部分因子或全因子设计相比,DSD 可以更灵活地阻止。 以下是对描述如何阻止 DSD 的论文的参考。
Bradley Jones 和 Christopher J. Nachtsheim (2015):确定性筛选设计的阻止方案,技术计量学, DOI: 10.1080/00401706.2015.1013777
5. 你最后关心的是教授 DSD 和对迭代实验方法的关心。 我不会将 DSD 宣传为“一次性”实验。 确实,传统部分因子设计的混叠结构很简单,也很容易解释。 然而,在我看来,它们对潜在重要影响的完全混叠是不可取的。 看
Bradley Jones (2016) 21 世纪筛选实验:内容、原因和方式,质量工程, 28:1, 98-106, DOI: 10.1080/08982112.2015.1100462
上述文章是由三位讨论者组成的讨论文件。 我的反驳处理了许多问题,包括在最初的 DSD 研究之后的顺序设计 - 参考如下。
布拉德利·琼斯 (Bradley Jones) (2016) 反驳,质量工程, 28:1, 122-126, DOI: 10.1080/08982112.2015.1100468
下面的参考文献处理了使用初始 DSD 的相对好处,即使预测的最佳响应在实验区域之外。 它还提供了一种强大的后续设计方法,可以胜过最陡峭的上升。
Christopher J. Nachtsheim & Bradley Jones (2018) 响应优化和模型估计的设计增强,质量工程, 30:1, 38-51, DOI: 10.1080/08982112.2017.1382298
我认为没有必要教从业者如何创建 DSD。 许多软件包可以做到这一点。 我认为让调查人员熟悉相关单元图很有用。 JMP 提供了许多用于评估和比较设计的诊断工具。 这些非常有用,在短期课程和大学课程中教授它们的使用将使能源部从业者社区受益。 对于从业者来说,了解如何利用 DSD 的特殊几何形状来拟合合适的模型是很有用的。 这在下面的参考文献中得到解决。
Bradley Jones 和 Christopher J. Nachtsheim (2016):有效的基于设计的模型选择,用于确定性筛选设计,技术计量学, DOI: 10.1080/00401706.2016.1234979
我很乐意继续这个对话并向您发送参考资料的 pdf。 您可以通过 bradley.jones@jmp.com 与我联系
回复:正确和不当使用最终筛选设计 (DSD)Jones 博士,我是 JMP 的长期用户(从第一个版本开始),感谢您对行业的贡献。 我参与了跨多个行业的 16,000 多个实验的设计和分析。 也许这是错误的论坛,但我有一些问题/意见(我希望不要冒犯),并会重视您的意见。
1. 在筛选设计方面,最常见的失败模式之一(尤其是对于新手实验者)是关卡设置得不够大(足够大胆)。 因此,它们的影响并未实现,这些因素甚至可能从进一步的研究中剔除(我的假设是工程师不愿意创造太多的变化,他们仍在寻找解决方案而不是了解因果关系)。 在我看来,将级别数增加到三个会使这种故障模式进一步复杂化?
2. 在设计初期,很多因素都是定性的。 似乎限制在设计中添加太多定性因素是一种负担。 也许这种策略更适用于顺序研究中的后期迭代?
3. 筛选设计通常是为了获得方向并过滤掉无关紧要的或更有可能确定重要因素以供进一步研究。 二次方程真的需要完成这个吗? 好的,我想可能存在水平设置太粗的情况,因此错过了显着的效果,但可以通过中心点很容易地纠正这种情况。 如果二次方本质上是与线性的背离,那么如果您的设计空间远离最优,您会不会首先对线性效应更感兴趣? 山脚下的二次方程可能无法让你到达山顶。
4. 此外,也许最重要的是,处理噪声的策略可能比设计因素的分辨率更重要(正如您所知,在设计因素分辨率和噪声效应解决之间为有效利用资源而不断斗争) . 如果使用随机完整区组设计 (RCBD),我们真的需要一些更高阶的逐个效应交互吗? 如果使用平衡不完整块设计,那么理解混叠有多容易?
5. 最后,也许对从业者来说最不重要的是,DSD 是如何教授的? 使用具有可识别混叠的传统部分因子设计和折叠到去混叠等想法是直截了当的。 灌输迭代的思维方式和实践至关重要。 DSD 如何适应迭代的、科学的实验方法?
我提前感谢您的想法。
如果您更愿意将此讨论脱线,那对我来说很好。 您可以直接在 comcast dot net 的 statman 给我发电子邮件
干杯,
比尔·罗斯
回复:正确和不当使用最终筛选设计 (DSD)谢谢布拉德,内容丰富的帖子和良好的反应,帮助我了解了更多关于 DSD 的信息。
回复:正确和不当使用最终筛选设计 (DSD)谢谢 Jones 博士 - ASQ Technometrics 网站上尚未提供此问题。我会期待它尽快出版。
理查德
回复:正确和不当使用最终筛选设计 (DSD)http://dx.doi.org/10.1080/00401706.2016.1234979
以上是 Chris Nachtsheim 和我在期刊 Technometrics 上发表的一篇论文的 URL,标题为 Effective Design-Based Model Selection for Definitive Screening Designs。
本文为添加我们所谓的“假因素”(即用于创建设计但在运行实验时未使用的因素)提供了强大的动力。 在 JMP 13 中,DSD 设计工具将此称为“Extra Runs”,默认值为 4。 但是,您可以将此字段更改回 0 以获得最小运行 DSD。 添加这些额外的运行允许强大的替代分析方法。
回复:正确和不当使用最终筛选设计 (DSD)是否发布了如下所述删除列的示例?
相反,如果您使用 8 因子 DSD 并忽略最后 3 列,您将拥有 17 次试验设计,并且您应该能够识别四个或五个二阶效应。
回复:正确和不当使用最终筛选设计 (DSD)当因素和相互作用太多时,DSD肯定会遇到麻烦! 我在经过几代优化并具有许多功能性催化剂组分和相互作用的催化剂系统中尝试了一种。 我最终不得不添加相当多的运行。
回复:正确和不当使用最终筛选设计 (DSD)很棒的帖子。 然而,我有一个问题让我感到困惑。 您提到您可以通过采用更高的 m 设计并删除额外的列来轻松添加额外的运行。 我想知道是否有任何简单的方法可以将运行“附加”到设计中。 例如,我已经完成了 am=5 DSD 运行,然后我决定我需要更多的功率,并且想在之后添加一些额外的运行。 我怎么做? (例如,如果我取 m=7 并删除最后两列并将其与 m=5 进行比较,那么我将不再获得相同的行)。 谢谢!
Bradley Jones 写道: 为验证做计划总是好的...布拉德利琼斯写道:
计划验证运行总是好的。 这些是您在运行实验并分析数据后执行的运行。 分析的结果是一个模型,您可以使用该模型在实验中未运行的因子设置下进行响应预测。 考虑到您的响应目标,您可以选择在模型预测最大改进的一个(或多个)因子设置下运行验证运行。
这与设计增强不同,后者扩展了因子的范围,为模型添加了项,或者添加了更多的游程以减少当前模型中估计的不确定性。
Bradley Jones 写道: 我相信日常使用...布拉德利琼斯写道:
对于工业设计实验中的大多数问题,我相信定制设计器的常规使用。 当几乎所有因素都是连续的并且可以在整个范围内独立变化时,确定性筛选设计是一个不错的选择。
当我进行蒙特卡洛计算机模拟研究时,我有时会使用全因子设计,其中唯一的费用是计算机时间。 我同意现在有比常规的两水平部分因子设计更好的选择。
Steven Moore 写道: 所以....我一直在使用 Definitive Sc...史蒂文·摩尔写道:
所以....我使用确定性筛选设计和定制设计已经有一段时间了。 在我看来,没有理由再使用传统的因子设计了。我是正确的,还是我错过了什么?
Jo Chotix 写道: 看起来我们将能够改变每个...乔乔蒂克斯写道:
看起来我们将能够独立地改变每个组件。 我应该计划进行一些验证运行吗? 如何为这些/因素计划设计(运行次数,验证的设计点等)? 这与增强设计有何不同? 谢谢!
Bradley Jones 写道: 使用 DSD 可能是合适的...布拉德利琼斯写道:
使用 DSD 可能是合适的,但我担心改变治疗浓度的 4 个因素可能被视为混合物中的成分。 如果是这样,那将使得使用 DSD 不合适,但有一个例外。 如果混合物中的主要成分是无活性的填充剂,那么其他成分可以独立变化。 在这种情况下,可以使用 DSD。
Jo chotix 写道: 我正在考虑使用 DSD 来设计...乔乔蒂克斯写道:
我正在考虑使用 DSD 为体内小鼠研究设计治疗计划。 我有 4 个因素会改变治疗的浓度(例如浓缩药物、赋形剂混合物等),还有一个因素关注于小鼠的年龄。 我想知道这是否是您推荐 DSD 的原因?
Bradley Jones 写道: 您可以将 3 个分类因素添加到...布拉德利琼斯写道:
您可以向 DSD 添加 3 个分类因素,而不会使设计效率低下。 以下是我和 Chris Nachtsheim 就该主题发表的一篇论文的参考。
琼斯,布拉德利和 Nachtsheim,CJ (2013) â 确定性筛选设计与添加的两级分类因素â,质量技术杂志,45:2,120-129。
Ewoud Schuring 写道: 你好布拉德利,有趣的博客,...埃伍德·舒林写道:
你好布拉德利,
有趣的博客,其实整个 DSD 对我来说都很有趣。 但是我确实有一个问题。
DSD中分类因素的数量限制是多少? 目前我正在尝试创建一个具有 3 个连续和 3 个分类因素的 DSD。 这是一个好主意吗? 有哪些风险? 还是连续与分类的 1/1 比率导致设计效率低下?
Bradley Jones 写道: 保罗,带有一些 r 的定制设计...布拉德利琼斯写道:
保罗,
具有少量复制的定制设计是一种非常安全的响应面设计。 我的经验是,通常很少有大的二阶效应。 因此,构建一个可以估计每一个二阶效应的设计可能最终会被过度使用。 6 因子 DSD 只需要 13 次运行,就可以可靠地识别两个或三个二阶效应。 这将为您节省近 50% 的成本。
相反,如果您使用 8 因子 DSD 并忽略最后 3 列,您将有 17 次试验设计,您应该能够识别四个或五个二阶效应。
Paul Prew 写道: 你好布拉德利,这篇文章让我...保罗·普鲁写道:
你好布拉德利,这篇文章让我想到了 4-6 个因素的适当设计。 具体来说,上周,我有一位化学家想研究 5 个连续因子。 初步的一次一个因素的测试告诉她,它们很重要。 她对 DOE 一无所知,但她的主管告诉她这是一条更有效的途径——去与统计学家交谈。
我们处于一个灰色地带,纯粹的筛选设计看起来像是倒退了一步,效率低下。 因此,我们选择设计二次模型,从而实现了 25 次运行的定制设计,并进行了几次复制。
谢谢,保罗
5 因子 DSD 的运行次数会少得多,即使设计为 6 或 7 个因子并删除额外的列。 如何使用 JMP 将 DSD 评估为适合二阶模型的良好设计? 您会推荐哪些特定的设计评估工具来比较 DSD 和定制设计?
Ron Andrews 写道: 我发现了一个 DSD 的应用程序...罗恩·安德鲁斯写道:
我找到了一个适用于 DSD 的应用程序,其中混合了有效的混合物。 我需要确认用于制造隐形眼镜的单体混合物的重量规格。 这是一种真正的混合,而不是解决方案,因此在大多数情况下,DSD 不是一个好的选择。 使它起作用的是名义上的微小变化。 名义公式被用作中心点。 每个组件的变化幅度为标称值的 +/- 1%。 为了分析实验,我计算了每种混合物的实际浓度。 混合物中最大的两个成分之间存在显着相关性,但设计允许对这两个因素进行单独估计。
我已经提交了一份发现峰会演示文稿的摘要,其中将其作为混合设计替代方案的示例之一。 不管它是否被接受,我可以提供更多细节。
