Datenfilter, die eine Gruppierung ermöglichen – entscheidend für die Verbraucherforschung<meta http-equiv="Content-Type" content="text/html; charset=UTF-8" />Filter, die eine Gruppierung (Klammern) zwischen AND OR ermöglichen.Die Boolesche Algebra wird vom Computer durchgeführt.
Hier ist, was wir heute mit der Gruppierung machen: A und (B1 oder B2 oder … oder B10) und (C1 und C2 und … und C10).In JMP sind dafür 126 statt 21 Terme erforderlich.
- Alice und ich hatten versucht, die gleichen komplexen Filterergebnisse in JMP zu erzielen, wie sie in unseren P&G DR-Benutzerdateien zu sehen sind. Wir können einiges mit Teilmengen, Filtern, Umkodieren, Formeln und Tricks machen.Wir sind hier auf eine Mauer gestoßen.Es geht: A und (B1 oder B2 oder … oder B10) und (C1 und C2 und … und C10).Die B-Gruppe ist invers.Dieser Filter findet nur leere Nester in einer Studie.Alice versuchte es lange.Ich habe es 3 Stunden lang in JMP ohne Glück versucht.
- Wenn Sie die Boolesche Algebra machen wollen, dann ersetzen Sie und durch * und oder durch + also A * (B1 + B2 + … + B10) * (C1 *C2 * … * C10).Machen Sie jetzt Ihre Algebra.
- Der JMP-Filter ist also: A und B1 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B2 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B3 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B4 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B5 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B6 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B7 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B8 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B9 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10 oder A und B10 und C1 und C2 und C3 und C4 und C5 und C6 und C7 und C8 und C9 und C10
- Ich habe nicht versucht, das Obige in JMP einzugeben. Jeder Buchstabe ist eine Spalte mit bestimmten ausgewählten Ebenen.
Betreff: Datenfilter, die eine Gruppierung ermöglichen – entscheidend für die VerbraucherforschungHallo Jeff,
Ich versuche, eine ähnliche Filterformel wie oben zu erstellen, verwende jedoch eine Mehrfachantwortspalte. Beginnend mit der EmptyNesterfromJMP-Datei, die die Spalte JMP Filter Formula enthält, habe ich zuerst eine neue Dateikopie, EmptyNesterfromJMP Multi, erstellt und eine Mehrfachantwortspalte hinzugefügt. Schreibmaschine , in die Datentabelle und kopierte die Spalte Filterformel, um die Formel zu ändern.Ich habe alle „!Contains relp" Verweise. und fügte einen Verweis auf Enthält hinzu Schreibmaschine die die Wertcodes 2 und 3 aus der Liste der 9 Wertcodes bezeichnet. Wenn ich diese Formel anwende, sind die Ergebnisse alle Nullen.

Um sicherzugehen, dass Zeilen vorhanden sind, die den ausgewählten Kriterien entsprechen, habe ich eine zweite Kopie des Datenfilters in der Tabelle mit only erstellt Alteradlt und nagep Säulen. Ich habe den Filter ausgeführt, der dazu führte, dass 672 Zeilen ausgewählt wurden, und dann eine Teilmengentabelle der ausgewählten Zeilen (alle Spalten) erstellt. Ich habe eine Kategorie von erstellt Alterl vs Schreibmaschine um herauszufinden, wie viele Antworten es für die Wertcodes 2 und 3 gab.Ich habe den lokalen Filter zum Filtern verwendet Schreibmaschine Verwenden der Werte 2 und 3, was zu 160 übereinstimmenden Zeilen führt. Mit Show Subset konnte ich eine Tabelle mit allen relevanten Informationen erstellen. Reihen.Die Daten, die ich als Filter verwenden möchte, sind also vorhanden, aber ich konnte nicht über den Formeleditor darauf zugreifen.

Ich kehrte zur Hauptdatei EmptyNesterfromJMP Multi zurück, wobei die Datenfilterauswahl von 672 Zeilen noch vorhanden war, und machte dieselbe kategoriale Datei mit denselben Filterkriterien.Diesmal stimmen die Berichtsdaten mit der ersten Kategorie überein, aber der lokale Filter zeigt jetzt 850 übereinstimmende Zeilen an.

Darüber hinaus wird bei Auswahl von Teilmenge anzeigen im lokalen Filter eine Tabelle generiert, die nur die Spalte JMP-Filterformel anzeigt.

Jedes Feedback zum richtigen Weg zum Einrichten einer Filterformel mit einer Mehrfachantwortspalte wie dieser wäre sehr willkommen.
Mir ist nicht klar, wie ich die Dateien anhängen soll, die ich in diesem Nachrichtenfenster verwende, daher werde ich Ihnen diese separat per E-Mail zusenden.
Vielen Dank,
Alice Ward
Betreff: Datenfilter, die eine Gruppierung ermöglichen – entscheidend für die VerbraucherforschungÜbrigens, obwohl sich die Funktion Contains() in der Gruppe der Zeichenfunktionen befindet, funktioniert sie auch mit Listen.
So verwende ich es oben. Das erste Argument sind alle möglichen Werte, die mich interessieren, in diesem Fall {3, 7} für die Werte "Ihr Kind..." und "Pflegekind". Das zweite Argument ist die Spalte, gegen die ich teste. Auf Englisch beantwortet die Contains-Funktion also die Frage: "Enthält die Liste {3, 7} den Wert in der Spalte rel#p?"
-Jeff
Betreff: Datenfilter, die eine Gruppierung ermöglichen – entscheidend für die VerbraucherforschungHallo Mike,
Es war schön mit dir zu reden und farris.dd beim .
Vielen Dank für die Zusendung der Datentabelle, in der der Filter für leere Nester erklärt wird.
Wie wir besprochen haben, verwenden Sie die Formel-Editor können Sie beliebig komplexe Filter in Form einer neuen Spalte erstellen, die im Datenfilter verwendet werden kann.
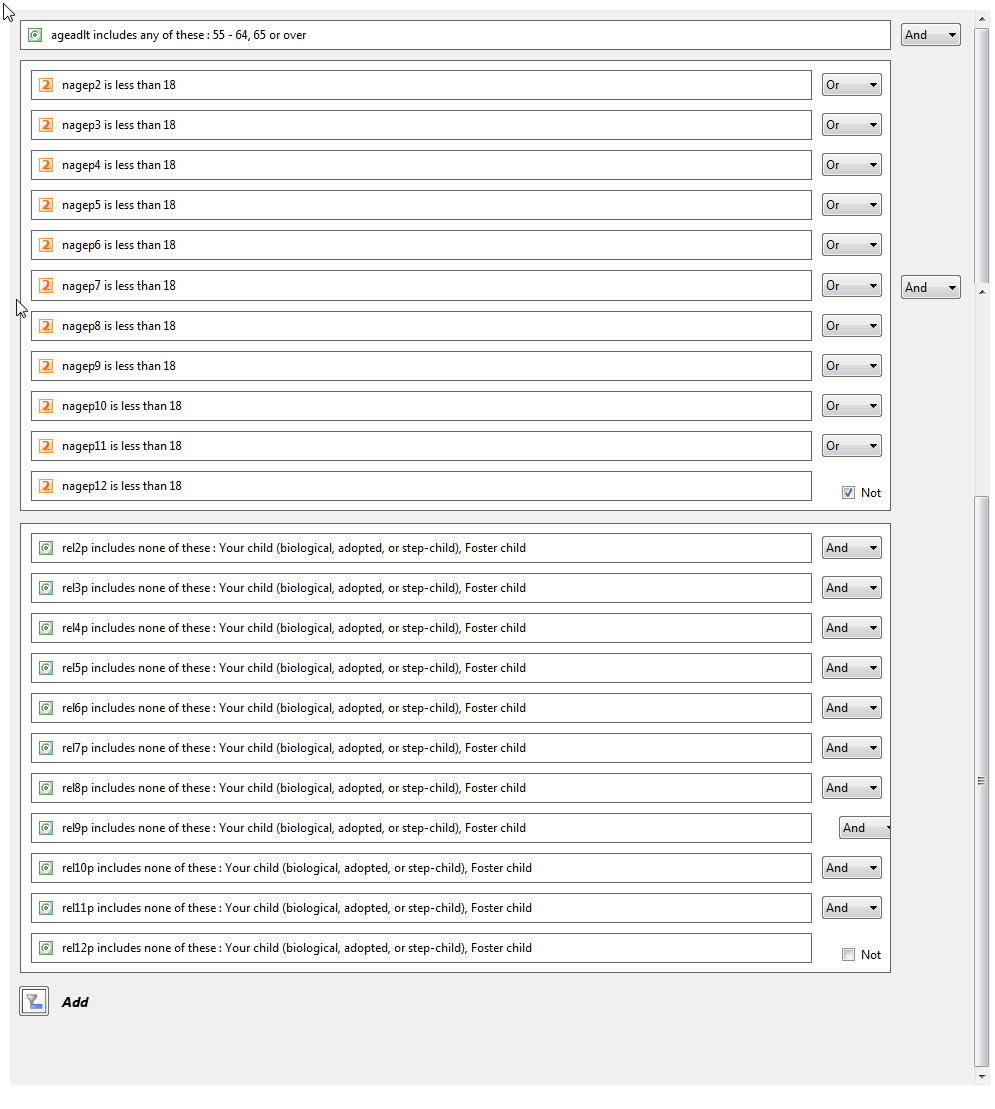
Als Referenz haben Sie auch den folgenden Screenshot eingefügt, der Ihren Datenfilter zeigt.
Ich habe festgestellt, dass Ihr Filter einen großen Teil von OR-Klauseln für Altersgruppen < 18 hatte, die mit einem NOT negiert wurden. Dies ist das Äquivalent zu einer Reihe von UND-Klauseln für Alter => 18.
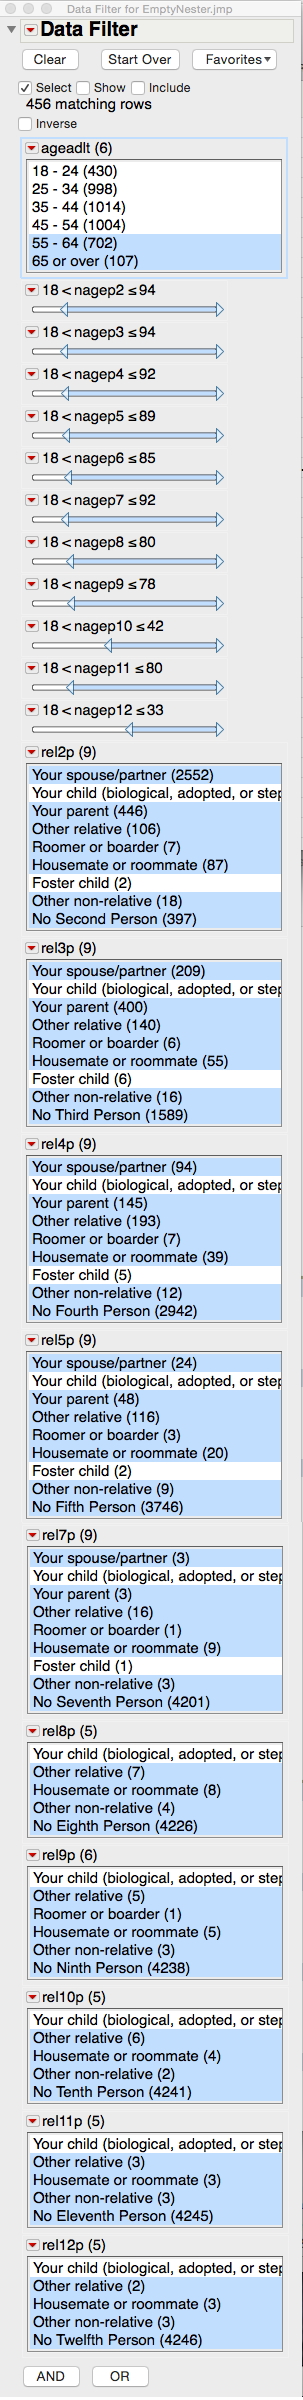
Ich kann das ziemlich einfach mit dem Datenfilter in JMP erstellen
Wenn Sie den Datenfilter aufrufen, müssen Sie „Auto-clear“ im roten Dreieck oben deaktivieren. Dadurch können Sie eine Mehrfachauswahl treffen.
Fügen Sie dann die Spalten hinzu, nach denen Sie filtern möchten.
Wählen Sie die Gruppe 55-64 aus und klicken Sie bei gedrückter Umschalttaste auf die Gruppe 65 oder darüber.
Für die nagegp#-Spalten müssen Sie für jede von ihnen „Fehlende auswählen“ aus dem roten Dreieck auswählen. Auf diese Weise werden Zeilen ausgewählt, wenn sie die Bedingung erfüllen ODER sie fehlen. Dies ist notwendig, da das Fehlen keinen numerischen Wert hat.
Wählen Sie schließlich für die Spalten rel#p alle Beziehungen außer "Ihr Kind..." und "Pflegekind" aus. Dies geschieht schnell mit der Tastatur, indem Sie auf einen beliebigen Wert in der Gruppe klicken, um den Tastaturfokus auf diese Gruppe zu legen, und dann Strg-A drücken, um alle Werte auszuwählen, und dann bei gedrückter Strg-Taste auf die beiden Werte klicken, die Sie abwählen möchten.
Hier ist ein kurzes Video, das die Erstellung des Filters zeigt.

Schließlich können Sie dies und viel kompliziertere Filter mit dem Formeleditor durchführen, um eine neue Spalte in der Datentabelle zu erstellen.

In diesem Fall können wir die verwenden Minimum()-Funktion um sicherzustellen, dass das Mindestalter in den Nagep#-Spalten größer als 18 ist. Wie John betonte, müssen Sie einen konstanten Wert in das Argument von Funktionen aufnehmen, um sich vor dem Fall zu schützen, in dem alle anderen Argumente fehlen. In diesem Fall schließen wir 18 ein.
Wir können auch die verwenden Enthält() Funktion mit der ! (NOT)-Operator für die rel#p-Spalten, um die Zeilen zu finden, die die Werte "Ihr Kind..." und "Pflegekind..." nicht enthalten.
Wie ich oben angemerkt habe, musste ich für die Vergleiche keinen OR-Operator oder irgendeine Klammergruppierung verwenden, aber all das ist verfügbar.
Ich hänge die von Ihnen gesendete Datentabelle an, die so geändert wurde, dass sie das Datenfilterskript und die Filterspaltenformel enthält.
Lassen Sie uns wissen, wenn Sie Fragen oder Bedenken haben.
Du hast gesagt, dass du und Station.am.2 häufig komplexe Datenfilter. Fühlen Sie sich frei, hier zu posten, wenn Sie solche Probleme in Zukunft durcharbeiten, und wir helfen Ihnen gerne weiter.
-Jeff

