グループ化を可能にするデータフィルター-消費者調査にとって重要<meta http-equiv="Content-Type" content="text/html; charset=UTF-8" />AND OR間のグループ化(括弧)を可能にするフィルター。ブール代数はコンピューターによって行われます。
今日、グループ化で行うことは次のとおりです。Aと(B1またはB2または…またはB10)と(C1とC2と…とC10)。JMPでは、これには21用語ではなく126用語が必要です。
- アリスと私は、P&GDRユーザーファイルに見られるのと同じ複雑なフィルター結果をJMPで達成しようとしていました。 サブセット、フィルタリング、再コーディング、数式、およびトリックでいくつかを行うことができます。これにレンガの壁をぶつけました。Aと(B1またはB2または…またはB10)と(C1とC2と…とC10)になります。Bグループが逆になります。このフィルターは、研究で空の巣を見つけるだけです。アリスは長い間試してみました。運が悪かったので、JMPで3時間試しました。
- ブール代数を実行する場合は、andを*または+に置き換えるのでA *(B1 + B2+…+B10)*(C1 * C2*…*C10)。今あなたの代数を行います。
- したがって、JMPフィルターは次のようになります。AとB1とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10またはAとB2とC1とC2とC3とC4とC5とC6とC7とC8 C9とC10またはAとB3とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10またはAとB4とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10またはAとB5とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10またはAとB6とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10またはAとB7とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10またはAとB8とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10またはAとB9とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10またはAとB10とC1とC2とC3とC4とC5とC6とC7とC8とC9とC10
- 上記をJMPに入力しようとはしませんでした。 各文字は、特定のレベルが選択された列です。
Re:グループ化を可能にするデータフィルター-消費者調査にとって重要こんにちはジェフ、
上記と同様のフィルター式を作成しようとしていますが、MultipleResponse列を使用しています。 JMP Filter Formula列を含むEmptyNesterfromJMPファイルから始めて、最初に新しいファイルコピーEmptyNesterfromJMP Multiを作成し、MultipleResponse列を追加しました。 typstor 、をデータテーブルに追加し、[数式のフィルター]列をコピーして数式を変更します。すべての「!Contains」を削除しましたrelp」参照。参照する含むを追加しましたtypstorこれは、9つのバリューコードのリストからバリューコード2と3を指定します。 この式を適用すると、結果はすべてゼロになります。

選択した基準に一致する行が存在することを確認したいので、テーブルにデータフィルターの2番目のコピーを作成しました。 ageadltとナゲップ列。 フィルタを実行した結果、672行が選択され、選択した行(すべての列)のサブセットテーブルが作成されました。 私はのカテゴリを構築しましたageadl vs typstorバリューコード2および3に対する応答の数を確認します。ローカルフィルターを使用してフィルターをかけましたtypstor値2と3を使用すると、160行が一致します。 Show Subsetを使用して、関連するすべてのテーブルを生成することができました。行。そのため、フィルターとして使用したいデータは存在しますが、数式エディターからアクセスできませんでした。

メインファイルEmptyNesterfromJMPMultiに戻り、672行のデータフィルターを選択したまま、同じフィルター基準を使用して同じカテゴリを作成しました。今回は、レポートデータは最初のカテゴリと一致しますが、ローカルフィルターには850の一致する行が表示されるようになりました。

さらに、[ローカルフィルター]で[サブセットの表示]を選択すると、[JMPフィルター形式]列を示すテーブルが生成されます。

このような複数応答列を使用してフィルター式を設定するための正しいパスに関するフィードバックは、大歓迎です。
このメッセージウィンドウで使用しているファイルを添付する方法がわかりません。そのため、個別にメールで送信します。
ありがとう、
アリスワード
Re:グループ化を可能にするデータフィルター-消費者調査にとって重要ちなみに、Contains()関数はCharacter関数グループに含まれていますが、リストでも機能します。
それが私が上記でそれを使用している方法です。 最初の引数は、私が興味を持っているすべての可能な値です。この場合、「あなたの子供...」と「里子」の値の{3、7}です。 2番目の引数は、私がテストしている列です。 したがって、英語では、Contains関数は、「リスト{3、7}にはrel#p列の値が含まれていますか?」という質問に答えています。
-ジェフ
Re:グループ化を可能にするデータフィルター-消費者調査にとって重要こんにちはマイク、
あなたと話せてよかったですfarris.ddで。
空のネスターフィルターを説明するデータテーブルを送ってくれてありがとう。
議論したように、数式エディタデータフィルターで使用できる新しい列の形式で、任意に複雑なフィルターを作成できます。
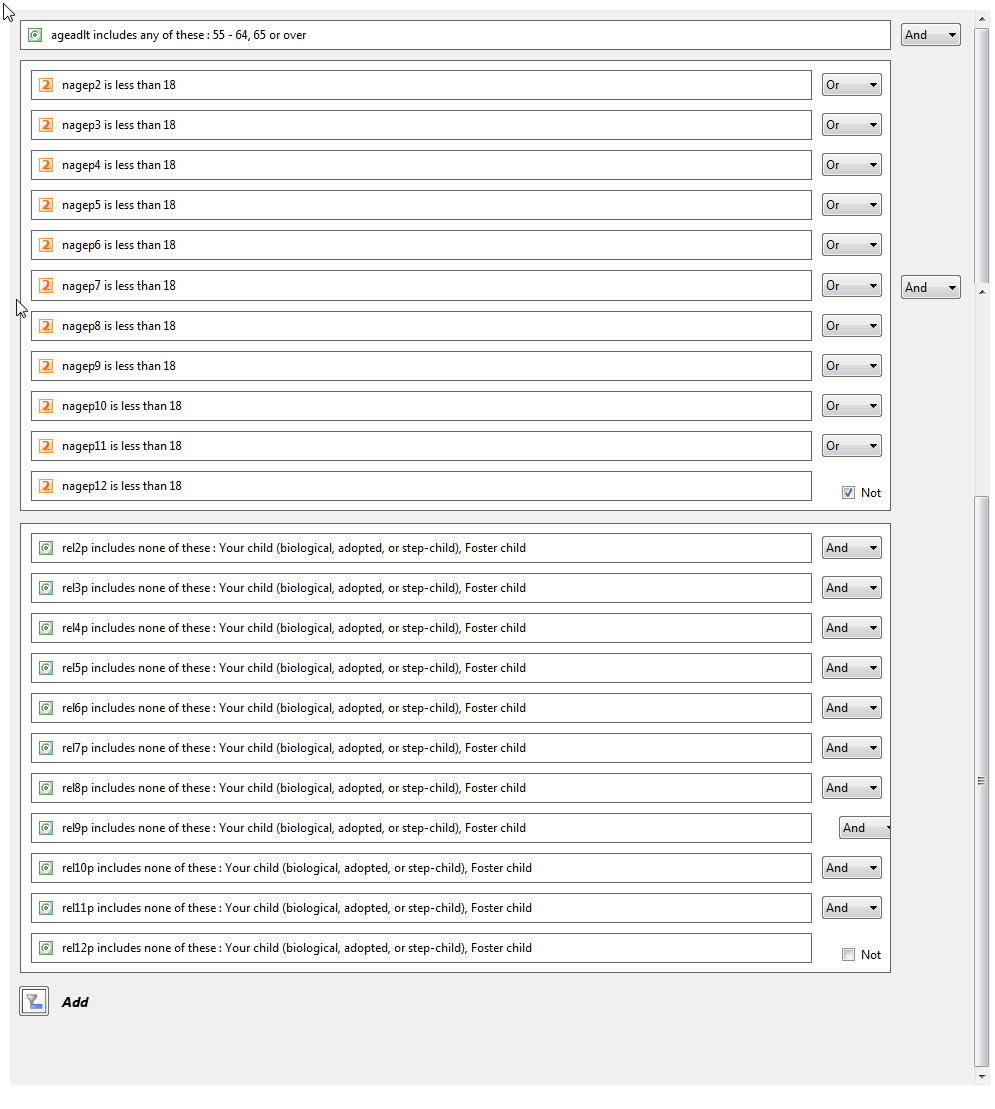
参考までに、データフィルターを示す次のスクリーンショットも含めました。
フィルタには、18歳未満のOR句の大部分があり、NOTで否定されていることに注意しました。 これは、年齢=>18のAND句のセットに相当します。
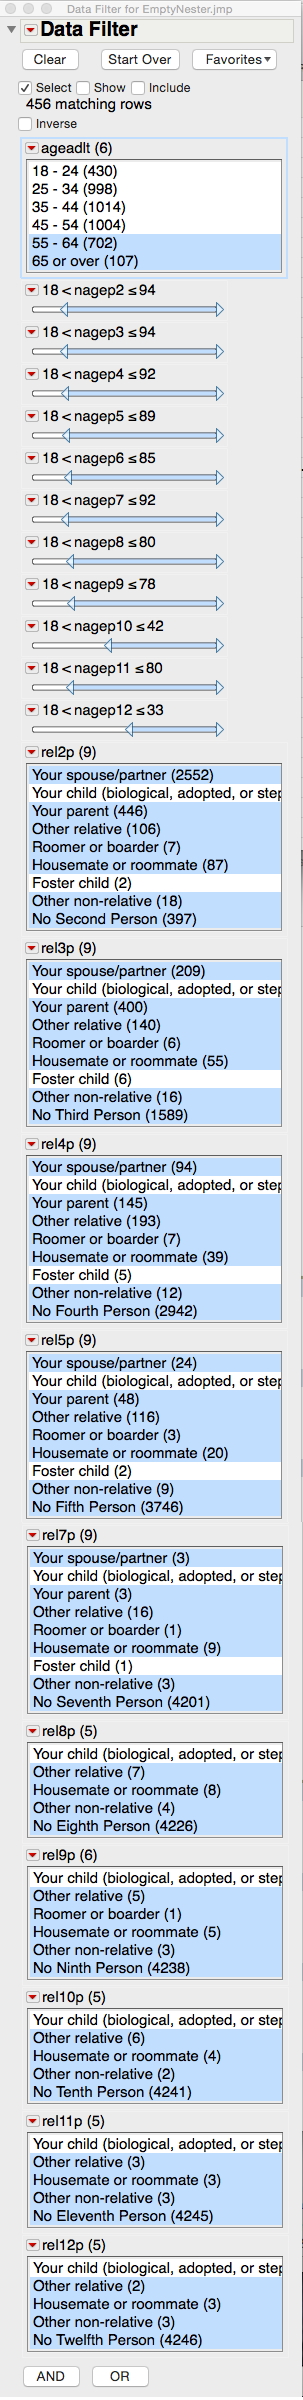
JMPのデータフィルターを使用してこれを非常に簡単に構築できます
データフィルターを上げるときは、上部の赤い三角形から「自動クリア」をオフにする必要があります。 これにより、複数の選択を行うことができます。
次に、フィルタリングする列を追加します。
55-64グループを選択し、Shiftキーを押しながら65以上のグループをクリックします。
nagegp#列の場合、各列の赤い三角形から「SelectMissing」を選択する必要があります。 そうすれば、条件を満たしているか、欠落している場合に行が選択されます。 欠落には数値がないため、これが必要です。
最後に、rel#p列で、「Yourchild...」と「Fosterchild」を除くすべてのリレーションを選択します。 これは、グループ内の任意の値をクリックしてそのグループにキーボードフォーカスを置き、Ctrl-Aを押してすべての値を選択し、選択を解除する2つをCtrlキーを押しながらクリックすることで、キーボードですばやく実行できます。
これは、フィルターの作成を示す簡単なビデオです。

最後に、数式エディタを使用してこれとはるかに複雑なフィルタを実行し、データテーブルに新しい列を作成できます。

この場合、使用することができます最小()関数nagep#列の最小年齢が18を超えていることを確認します。 Johnが指摘したように、他のすべての引数が欠落している場合から保護するために、関数の引数に定数値を含める必要があります。 この場合、18を含めます。
使用することもできますcontains() !で機能します(NOT)rel#p列の演算子で、「Yourchild...」および「Fosterchild...」の値を含まない行を検索します。
上で述べたように、比較のためにOR演算子や括弧で囲まれたグループを使用する必要はありませんでしたが、それらはすべて利用可能です。
送信したデータテーブルを添付し、データフィルタースクリプトとフィルター列の数式を含めるように変更しました。
ご質問やご不明な点がございましたら、お気軽にお問い合わせください。
あなたはあなたとward.am.2頻繁に作成される複雑なデータフィルター。 今後、このような作業を行う際は、ここに投稿してください。喜んでサポートさせていただきます。
-ジェフ

