그룹화를 허용하는 데이터 필터 - 소비자 조사에 중요<meta http-equiv="Content-Type" content="text/html; charset=UTF-8" />AND OR 사이의 그룹화(괄호)를 허용하는 필터입니다.부울 대수는 컴퓨터로 수행됩니다.
오늘 우리가 그룹화하여 수행하는 작업은 다음과 같습니다. A 및 (B1 또는 B2 또는 ... 또는 B10) 및 (C1 및 C2 및 ... 및 C10).JMP에서는 21개 용어 대신 126개 용어가 필요합니다.
- Alice와 나는 P&G DR 사용자 파일에서 볼 수 있는 것과 동일한 복잡한 필터 결과를 JMP에서 달성하려고 노력했습니다. 부분 집합, 필터링, 레코딩, 공식 및 트릭으로 일부 작업을 수행할 수 있습니다.우리는 이것에 벽돌 벽에 부딪쳤다.A 및 (B1 또는 B2 또는 ... 또는 B10) 및 (C1 및 C2 및 ... 및 C10) 진행됩니다.B 그룹은 반전됩니다.이 필터는 연구에서 빈 네스터를 찾습니다.앨리스는 오랫동안 노력했습니다.나는 운없이 JMP에서 3 시간 동안 시도했습니다.
- 부울 대수를 수행하려면 and를 * 및 또는 +로 대체하여 A * (B1 + B2 + ... + B10) * (C1 *C2 * ... * C10)을 수행합니다.이제 대수학을 수행하십시오.
- 따라서 JMP 필터는 A 및 B1 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B2 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B3 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B4 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B5 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B6 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B7 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B8 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B9 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10 또는 A 및 B10 및 C1 및 C2 및 C3 및 C4 및 C5 및 C6 및 C7 및 C8 및 C9 및 C10
- 위의 내용을 JMP에 입력하려고 하지 않았습니다. 각 문자는 특정 수준이 선택된 열입니다.
Re: 그룹화를 허용하는 데이터 필터 - 소비자 조사에 중요안녕하세요 제프,
위와 유사하지만 다중 응답 열을 사용하는 필터 수식을 구성하려고 합니다. JMP 필터 수식 열이 포함된 EmptyNesterfromJMP 파일로 시작하여 먼저 새 파일 복사본인 EmptyNesterfromJMP Multi를 만들고 다중 응답 열을 추가했습니다. 타이프스터 , 데이터 테이블에 복사하고 필터 수식 열을 복사하여 수식을 수정합니다."!포함"을 모두 제거했습니다. 반성" 참조. 다음을 참조하는 포함을 추가했습니다. 타이프스터 9개의 값 코드 목록에서 값 코드 2와 3을 지정합니다. 이 공식을 적용하면 결과는 모두 0입니다.

선택한 기준과 일치하는 행이 있는지 확인하기 위해 테이블에서 데이터 필터의 두 번째 복사본을 만들었습니다. 나이 그리고 나셉 열. 필터를 실행하여 672개의 행을 선택한 다음 선택한 행(모든 열)의 하위 집합 테이블을 만들었습니다. 나는 카테고리를 구성했다. 나이들 대 타이프스터 값 코드 2 및 3에 대한 응답 수를 확인합니다.로컬 필터를 사용하여 필터링했습니다. 타이프스터 값 2와 3을 사용하여 160개의 일치하는 행이 생성됩니다. Show Subset을 사용하여 모든 관련 테이블을 생성할 수 있었습니다. 행.그래서 필터로 사용하고 싶은 데이터가 존재하는데, Formula Editor를 통해 접근할 수 없었습니다.

672개 행의 데이터 필터 선택이 여전히 있는 상태에서 기본 파일 EmptyNesterfromJMP Multi로 돌아가서 동일한 필터링 기준을 사용하여 동일한 범주를 만들었습니다.이번에는 보고서 데이터가 첫 번째 범주와 일치하지만 이제 로컬 필터에 850개의 일치하는 행이 표시됩니다.

또한 Local Filter에서 Show Subset을 선택하면 JMP Filter Fornula 열만 표시하는 테이블이 생성됩니다.

이와 같은 다중 응답 열을 사용하여 필터 수식을 설정하는 올바른 경로에 대한 피드백은 대단히 감사합니다.
이 메시지 창에서 제가 사용하고 있는 파일들을 어떻게 첨부해야 할지 막막해서 따로 이메일로 보내드리도록 하겠습니다.
감사해요,
앨리스 워드
Re: 그룹화를 허용하는 데이터 필터 - 소비자 조사에 중요그건 그렇고, Contains() 함수는 문자 함수 그룹에 있지만 목록에서도 작동합니다.
위와 같이 사용하고 있습니다. 첫 번째 인수는 내가 관심을 가질 수 있는 모든 값입니다. 이 경우에는 "Your child..." 및 "Foster child" 값에 대해 {3, 7}입니다. 두 번째 인수는 내가 테스트 중인 열입니다. 따라서 영어에서 Contains 함수는 "목록 {3, 7}에 rel#p 열의 값이 포함되어 있습니까?"라는 질문에 답하고 있습니다.
-제프
Re: 그룹화를 허용하는 데이터 필터 - 소비자 조사에 중요안녕 마이크,
당신과 이야기하는 것이 좋았습니다. Farris.dd ~에 .
빈 네스터 필터를 설명하는 데이터 테이블을 함께 보내주셔서 감사합니다.
우리가 논의한 바와 같이, 수식 편집기 데이터 필터에서 사용할 수 있는 새 열의 형태로 임의로 복잡한 필터를 만들 수 있습니다.
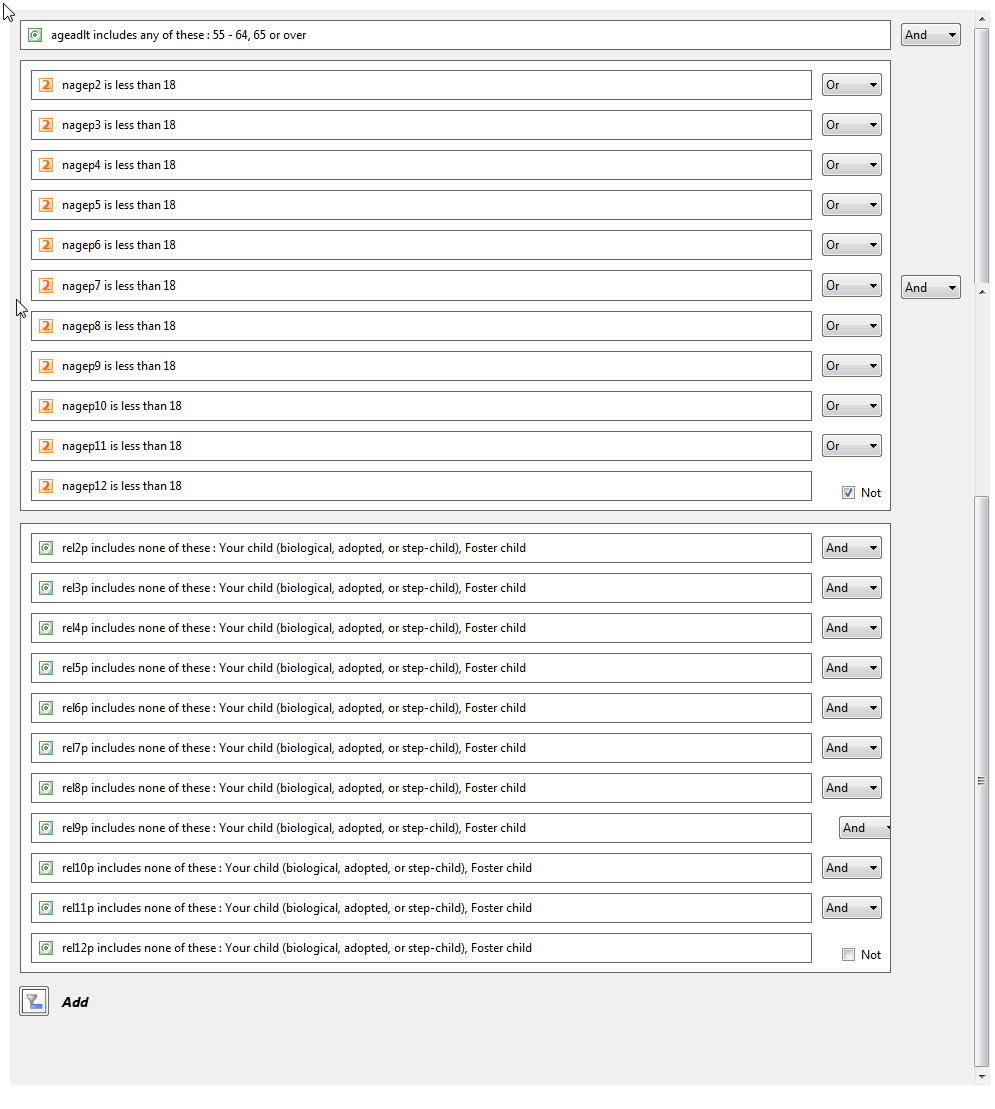
참고로 데이터 필터를 보여주는 다음 스크린샷도 포함했습니다.
귀하의 필터에 NOT으로 무효화된 18세 미만의 OR 절이 많이 포함되어 있음을 확인했습니다. 이것은 연령 => 18에 대한 AND 절 세트와 동일합니다.
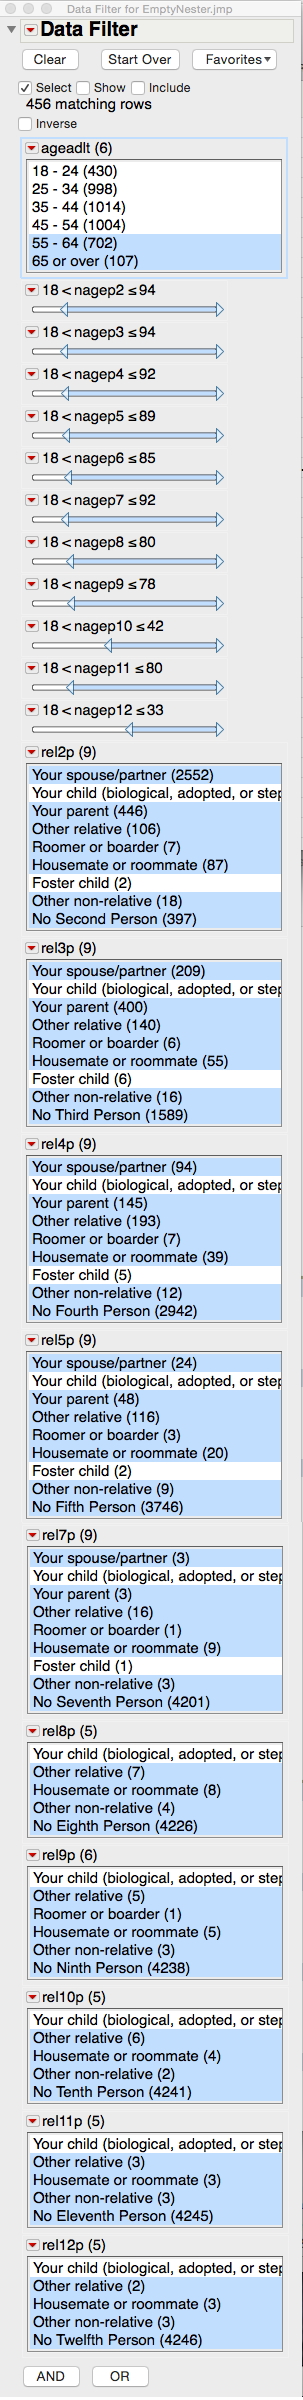
JMP의 데이터 필터를 사용하여 이것을 아주 쉽게 구축할 수 있습니다.
데이터 필터를 불러올 때 상단의 빨간색 삼각형에서 "자동 지우기"를 꺼야 합니다. 이렇게 하면 여러 항목을 선택할 수 있습니다.
그런 다음 필터링할 열을 추가합니다.
55-64 그룹을 선택하고 65 이상 그룹을 Shift 키를 누른 상태에서 클릭합니다.
nagegp# 열의 경우 각 열에 대한 빨간색 삼각형에서 "누락 선택"을 선택해야 합니다. 그렇게 하면 조건을 충족하거나 누락된 행이 선택됩니다. 누락에는 숫자 값이 없기 때문에 필요합니다.
마지막으로 rel#p 열에 대해 "Your child..." 및 "Foster child"를 제외한 모든 관계를 선택합니다. 이 작업은 그룹의 값을 클릭하여 해당 그룹에 키보드 포커스를 놓은 다음 Ctrl-A를 눌러 모든 값을 선택한 다음 선택을 취소하려는 두 개를 Ctrl-클릭하면 키보드로 빠르게 수행됩니다.
다음은 필터 생성을 보여주는 빠른 비디오입니다.

마지막으로 수식 편집기를 사용하여 이 작업과 훨씬 더 복잡한 필터를 수행하여 데이터 테이블에 새 열을 만들 수 있습니다.

이 경우 우리는 다음을 사용할 수 있습니다. 최소() 함수 nagep# 열의 최소 연령이 18세 이상인지 확인합니다. John이 지적했듯이 다른 모든 인수가 누락된 경우를 방지하기 위해 함수에 대한 인수에 상수 값을 포함해야 합니다. 이 경우 18을 포함합니다.
우리는 또한 사용할 수 있습니다 포함() 기능! (NOT) 연산자를 사용하여 "Your child..." 및 "Foster child..." 값이 포함되지 않은 행을 찾습니다.
위에서 언급했듯이 비교를 위해 OR 연산자나 괄호로 묶인 그룹을 사용할 필요가 없었지만 모두 사용할 수 있습니다.
데이터 필터 스크립트와 필터 열 수식을 포함하도록 수정하여 보내주신 데이터 테이블을 첨부합니다.
질문이나 우려 사항이 있으면 알려주십시오.
당신은 당신과 ward.am.2 복잡한 데이터 필터를 자주 만듭니다. 앞으로 이와 같은 작업을 수행할 때 언제든지 여기에 게시해 주시면 기꺼이 도와드리겠습니다.
-제프

