개발자 튜토리얼: JMP Pro 일반화 회귀를 사용하여 관측 데이터를 더 잘 이해합니다.관찰 데이터는 대규모 데이터 세트, 직교성을 나타내지 않는 데이터, 해석보다는 예측에 관심이 있는 상황에 유용한 분석에 적합합니다.일반화 회귀 플랫폼은 설계된 실험과 관찰 데이터 모두에 대한 회귀 모델을 구축하는 장소입니다.명심해야 할 몇 가지 사항:
1) 페널티화된 회귀는 관측 데이터에 대한 큰 가능성을 보여줍니다.
2) 효과 유전은 아마도 필요하지 않을 것입니다.
3) 데이터가 충분하면 홀드아웃 세트를 사용하고, 그렇지 않으면 AICc를 사용하십시오.
방법을 확인하세요:
- 추정과 관련된 배경 원칙과 고려해야 할 필요성을 이해합니다.
- 추정치가 진실과 얼마나 멀리 떨어져 있는지(편향)
- 추정치의 가변성(분산)
- 편향과 분산 원리의 결합을 추정기의 평균 제곱 오차로 측정할 수 있는 방법
- Penalized Regression 기술 이해(Ridge, Lasso, Elastic Net, Adaptive Lasso, Double Lasso, Dantzig Selector)
- JMP Pro에서 효과 유전이 어떻게 처리되는지 알아보세요.
- 그리드 컨트롤 옵션 선택
- 강제 용어 사용, 조기 중지 및 정보 누락
자원

예측 모델링 및 기계 학습답: 개발자 튜토리얼: JMP Pro 일반화 회귀를 사용하여 관측 데이터를 더 잘 이해합니다.@H2OSUP 프레젠테이션이 유용하다고 생각해서 정말 기뻐요! 맞습니다. 예측 변수 중 하나에 누락된 값이 있는 경우 기본 동작은 장르가 해당 데이터 행 전체를 무시하는 것입니다.
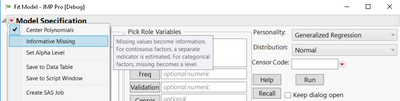
하지만 Fit Model의 "Informative Missing" 옵션을 사용하면 이 문제를 해결할 수 있는 방법이 있습니다. 모델 적합 모델 사양 대화 상자(아래 스크린샷)의 빨간색 삼각형 메뉴에서 찾을 수 있습니다. 간단히 말해서 이 옵션은 누락된 값에 대한 평균 대체를 사용하고 모델에 누락에 대한 지표를 추가한다는 것입니다. 그러나 더 자세한 내용은 John Sall이 썼습니다. 블로그 게시물 정보 누락 옵션에 대해
답: 개발자 튜토리얼: JMP Pro 일반화 회귀를 사용하여 관측 데이터를 더 잘 이해합니다.@clay_barker 지난 가을에 튜토리얼을 소개해주셔서 감사합니다. 나는 당신의 프리젠테이션이 매우 유용하고 잘 진행되었다고 생각합니다. GENREG가 데이터 세트에서 누락된 셀을 처리하는 방법에 대한 질문이 있습니다. 입력에 대해 하나의 셀이 누락된 경우 GENREG가 분석에서 전체 행을 제외합니까? 다른 입력에 누락된 값이 있는 경우 GENREG에 행에 대해 누락되지 않은 입력이 포함된 모델에 대한 행이 포함되는지 궁금합니다. 고마워요, 마이크.
