Mon cours préféré au lycée était les sciences de la Terre. Je me souviens avoir pris des relevés météorologiques quotidiens pendant notre section de météorologie. Chaque matin, nous sortions, mesurions la température humide et sèche, la vitesse et la direction du vent et estimions la couverture nuageuse. Une ou deux fois, nous sommes retournés en classe pour nous rendre compte qu'une lecture était erronée ou n'avait aucun sens. Pas de problème, nous sommes retournés dehors et avons refait la mesure – ce n’était pas grave de faire les 50 pas et de reprendre la mesure.
Le problème
Environ 18 ans plus tard, je travaille sur l' Helix Q4000 , essayant d'acquérir des échantillons d'hydrate de méthane à partir de sédiments situés à plus d'un kilomètre sous mes pieds. Il a fallu plus de 24 heures pour acquérir notre premier noyau. Lorsqu'il est remonté à la surface, rien n'avait fonctionné correctement : l'échantillon était dépressurisé et les quelque 10 % de sédiments récupérés n'étaient que de la soupe. Contrairement à mes relevés de température au lycée, nous ne pouvions pas revenir en arrière et réessayer – cet échantillon de sédiments avait disparu à jamais.
C’est le défi auquel les géologues et les ingénieurs sont régulièrement confrontés lorsqu’ils travaillent dans des environnements souterrains difficiles. Les données sont coûteuses à acquérir et vous n’obtenez qu’une seule photo. Alors, que faire lorsque les données ne reviennent pas comme elles le devraient ? Peut-être que l'outil tombe en panne en profondeur ou, pire encore, se coince et que tout le puits doit être abandonné ? Comment pouvons-nous exploiter le peu d’informations dont nous disposons et leur donner un sens utile ? Nous pouvons bien sûr utiliser les puissants outils prédictifs de JMP Pro !
L'expérience
 Input parameters of Gamma (blue), Formation Density (red), Compressional Velocity (green), and Shear Velocity (purple). Interval one is >2064 ftkb and is above the black upper black line, interval two is between the two black lines (2065-2127 ftkb), and interval three is below the black line (2128-2206 ftkb).Paramètres d'entrée Gamma (bleu), densité de formation (rouge), vitesse de compression (vert) et vitesse de cisaillement (violet). L'intervalle un est > 2 064 ftkb et se trouve au-dessus de la ligne noire supérieure noire, l'intervalle deux se situe entre les deux lignes noires (2 065-2 127 ftkb) et l'intervalle trois est en dessous de la ligne noire (2 128-2 206 ftkb).
Comparons quelques méthodes différentes pour prédire une variable mal acquise par rapport à des méthodes plus robustes. Dans ce cas, nous essayons de comprendre la saturation en hydrocarbures (hydrate de méthane), qui est peu disponible dans ce puits particulier ( puits Mt Elbert, North Slope, AK ). Ce que nous avons, ce sont des ensembles complets de quatre variables : rayons gamma, densité de formation, vitesse de compression et vitesse de cisaillement. Dans le sous-sol, il y a trois intervalles de sables contenant des hydrates, et nous voulons utiliser le premier intervalle (2003-2064 pieds sous la bague Kelly, ftkb) pour prédire la saturation en hydrates dans les deux intervalles inférieurs, 2065-2127 ftkb et 2128- 2206 ftko, respectivement. Nous testerons différents modèles prédictifs : moindres carrés standard, régression généralisée, réseau neuronal et XGBoost. Nous utiliserons les valeurs R2 comme première étape de la qualité du modèle, mais évaluerons ensuite qualitativement les journaux de puits réels et prévus pour évaluer la qualité globale de chaque modèle.
Résultats
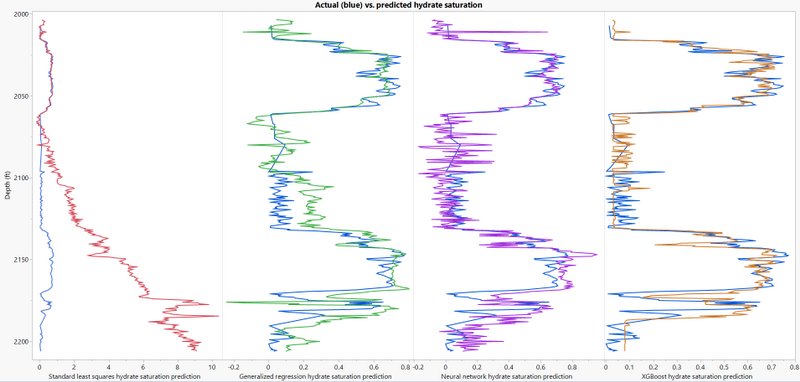 Actual hydrate saturation (blue) compared to predicted hydrate saturation for Standard Least Squares (red), Generalized Regression (green), Neural Network (purple), and XGBoost (burnt orange).Saturation réelle en hydrates (bleu) par rapport à la saturation prévue en hydrates pour les moindres carrés standard (rouge), la régression généralisée (vert), le réseau neuronal (violet) et XGBoost (orange brûlé).
Les moindres carrés standards ne suffisent tout simplement pas. Il modélise de manière robuste l'intervalle 1 mais ne parvient absolument pas à prédire avec précision la saturation en hydrocarbures dans les deux intervalles inférieurs. La régression généralisée (adaptative ; Elastic Net) est légèrement meilleure, mais surprédit généralement les deux intervalles inférieurs de 0,1 à 0,2 unités de saturation. Les modèles d'apprentissage automatique font un travail beaucoup plus robuste, mais je donne l'avantage à XGBoost. Le réseau neuronal produit un signal beaucoup plus « bruyant » dans la mesure où il existe de nombreux coups de pied qui représentent 10 à 20 % de sur et de sous-prédiction, tandis que XGBoost fournit une prédiction beaucoup plus stable à des saturations d'hydrocarbures faibles et élevées.
C'est un thème commun que j'observe lorsque je travaille avec des données géologiques et/ou de fond de puits : les systèmes naturels sont incroyablement complexes, pleins d'hétérogénéités, et les modèles d'apprentissage automatique (Bootstrap Forest, Neural Network et XGBoost, etc.) ont tendance à fournir de meilleures prévisions. modèles dans leur ensemble.

 Model results for validation data sets of XGBoost (top) and Neural Network (bottom).Résultats du modèle pour les ensembles de données de validation de XGBoost (en haut) et de Neural Network (en bas).
Avancer
La plupart des personnes travaillant dans l’industrie disposeront de beaucoup plus de données à portée de main qu’un seul puits. Une bonne pratique consiste à utiliser le clustering pour regrouper les puits en utilisant des paramètres géologiques (lithologie, porosité, perméabilité, etc.) et à construire des modèles prédictifs par cluster. Cette méthode peut vous permettre d'obtenir de meilleurs résultats car le modèle est spécialement conçu pour un jeu particulier, ou même pour un bassin particulier au sein d'un jeu particulier. Au-delà de cela, une bonne pratique consiste à faire un tour visuel de vos données dans Graph Builder – essayez d'avoir une idée de ce qui se passe avec les paramètres individuels pour identifier la meilleure voie à suivre.
Enfin, la démocratisation de l'analyse des données dans votre organisation va vous permettre d'atteindre de meilleurs objectifs plus rapidement : mettez des outils puissants entre les mains des utilisateurs, montrez-leur comment créer et interpréter des modèles, puis asseyez-vous et profitez-en !
La source de données
Ces données ont été collectées dans le cadre d'un accord de coopération de forage entre le DOE et BP Exploration Alaska (BPXA), en collaboration avec l'US Geological Survey (USGS) et plusieurs universités et partenaires industriels, pour évaluer si l'hydrate de gaz naturel du versant nord de l'Alaska pourrait être produit de manière viable, que ce soit techniquement ou commercialement. Le puits du mont Elbert a été foré en 2007 et les données sont disponibles via l' observatoire terrestre Lamont Doherty de l'université de Columbia. J'ai sous-ensemble les données, je les ai nettoyées et je les ai rendues disponibles dans une table JMP sur JMP Public (Remarque : sans JMP Pro , les scripts GenReg, Neural w/KFold et XGBoost ne s'exécuteront pas. De plus, le script XGBoost nécessite JMP Pro et le complément XGBoost ).
Félicitations, cher collègue! Vous avez accompli un travail brillant. Et veuillez recevoir un merci tout particulier pour vos conseils concernant les approches des modèles d'ensemble. Passe un bon week-end!
Sincèrement,
Michael
Michael, l'erreur quadratique moyenne (deuxième mesure d'ajustement sur le rapport JMP NN) pour cet ensemble de données particulier change sur six démarrages aléatoires varie d'environ 0,01, ce qui est assez mineur. En ce qui concerne les modèles d'ensemble, dans JMP Pro, vous pouvez utiliser la forêt Bootstrap ou utiliser stimuler dans les NN ou les arbres de décision. Toutes ces fonctionnalités sont disponibles dans JMP 15 Pro. J'espère que ça aide!
Super truc, Peter! Et dites-moi s'il vous plaît, comment étaient les RMSE. Car, pour les régressions, le RMSE est le principal KPI. Espérons que ce paramètre ne change pas radicalement. Maintenant, faites-moi savoir comment vous créez les ensembles sur JMP Pro. Le mien est 15.0, donc le vôtre peut être 16, puisque les ensembles ne sont pas rencontrés dans la 15ème version. Je vous serais très reconnaissant !
Merci beaucoup pour la question @Nazarkovski , c'est un sujet très important que vous avez évoqué. J'ai rencontré des cas où des recherches fondamentales ont finalement été rétractées parce que l'auteur avait trouvé des corrélations très robustes en utilisant des NN, mais lorsque d'autres utilisateurs ont exécuté les mêmes NN sur les mêmes données mais en utilisant un départ aléatoire différent, ils ont trouvé des corrélations considérablement inférieures. C'est là que les modèles d'ensemble peuvent vraiment être utiles (par exemple Bootstrap Forest, Boosted NN's, etc.). Cela dit et soulignant l’importance de le faire, je dois admettre que je ne l’ai pas fait à l’origine. MAIS je n'ai pas pu m'en empêcher et après avoir lu votre commentaire, je suis revenu et j'ai réexécuté une série de NN en utilisant des paramètres identiques avec des graines aléatoires différentes. L'ensemble de validation moyen R^2 était de 0,92 +/- 0,01, juste un peu inférieur à ce que j'avais trouvé à l'origine.
Merci pour cet article si instructif et minutieusement écrit ! Eh bien, je m'occupe également de la chimie en utilisant JMP Pro pour les tâches respectives.
Eh bien, ma question concerne le réseau neuronal (NN). Dans JMP pour les cas de régression, même à graine aléatoire fixe, les valeurs prédites par NN diffèrent avec toutes leurs métriques (RMSE, R2 etc) si l'on relance un modèle identique. Pour la classification, tout est reproductible en conservant les métriques. Avez-vous joué en réorganisant votre modèle NN en gardant des conditions identiques ?
Merci!
Michael

