我在高中最喜欢的课是地球科学。 我记得在我们的气象部分每天读取天气读数。 每天早上,我们到户外测量干湿球温度、风速和风向,并估算云量。 有一次或两次,我们回到教室却发现阅读已关闭或没有意义。 没问题,我们回到外面重新测量 - 走 50 步并重新测量没什么大不了的。
问题
快进大约 18 年,我正在研究螺旋Q4000 ,试图从我脚下一英里多的沉积物中获取甲烷水合物样本。 获得我们的第一个核心花了 24 多个小时。 当它浮出水面时,没有任何东西正常工作:样品被减压,回收的 10% 左右的沉积物只是汤。 不像我在高中时的温度读数,我们不能回去再试一次——沉积物样本永远消失了。
这是地质学家和工程师在恶劣的地下环境中经常面临的挑战。 获取数据的成本很高,而且您只能获得一次机会。 那么,当数据没有按预期返回时,您会怎么做? 也许该工具在深度失效或更糟,卡住了,不得不放弃整个井? 我们如何利用我们拥有的少量信息并对其进行有用的理解? 我们可以用JMP专业版当然是强大的预测工具!
本实验
 Gamma(蓝色)、地层密度(红色)、压缩速度(绿色)和剪切速度(紫色)的输入参数。 区间一>2064 ftkb且在黑色上黑线上方,区间二在两条黑线之间(2065-2127 ftkb),区间三在黑线下方(2128-2206 ftkb)。
让我们比较几种从更稳健的变量中预测获取不佳的变量的不同方法。 在这种情况下,我们试图了解碳氢化合物饱和度(甲烷水合物),这在这口井中稀少(艾尔伯特山井,北坡,AK )。 我们所拥有的是完整的四个变量集:伽马射线、地层密度、压缩速度和剪切速度。 在地下,有三个含水合物砂层,我们想用第一个层段(方钻套管下 2003-2064 英尺,ftkb)来预测下面两个层段的水合物饱和度,2065-2127 ftkb 和 2128-分别为 2206 ftkb。 我们将测试不同的预测模型:标准最小二乘法、广义回归、神经网络和 XGBoost。 我们将使用 R2 值作为模型质量的第一次通过,但随后将定性评估实际测井与预测测井曲线,以评估每个模型的整体质量。
结果
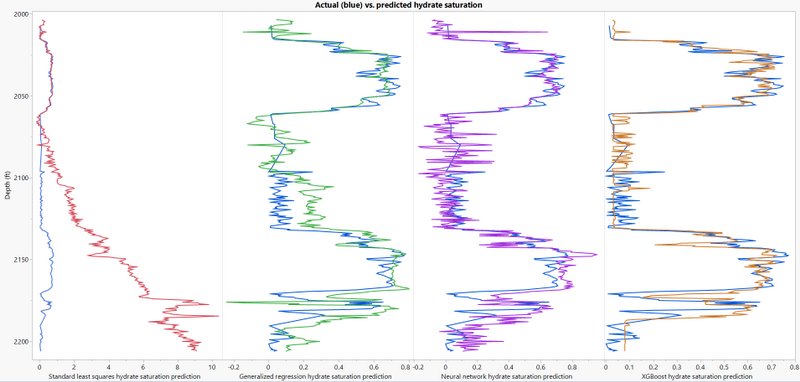 实际水合物饱和度(蓝色)与标准最小二乘法(红色)、广义回归(绿色)、神经网络(紫色)和 XGBoost(橙色)的预测水合物饱和度相比。
标准最小二乘法并没有削减它。 它对区间 1 进行了稳健的建模,但完全无法准确预测下两个区间的碳氢化合物饱和度。 广义回归(自适应;弹性网络)稍微好一些,但通常会高估较低的两个区间 0.1 到 0.2 个饱和单位。 机器学习模型做得更强大,但我认为 XGBoost 具有优势。 神经网络产生的“噪声”大得多,因为有大量的冲击占预测的 10-20%,而 XGBoost 在低烃饱和度和高烃饱和度下提供了更稳定的预测。
这是我在处理地质和/或井下数据时观察到的一个共同主题:自然系统极其复杂,充满异质性,而机器学习模型(Bootstrap Forest、神经网络和 XGBoost 等)倾向于提供更好的预测模型整体。

 XGBoost(顶部)和神经网络(底部)验证数据集的模型结果。
向前进
大多数在该行业工作的人将拥有比单口井更多的数据。 一个强有力的做法是使用聚类将井使用地质参数(岩性、孔隙度、渗透率等)组合在一起,并按聚类构建预测模型。 这种方法可以让您获得更好的结果,因为该模型是专门为特定游戏甚至特定游戏中的特定盆地而构建的。 除此之外,一个很好的做法是在 Graph Builder 中对您的数据进行可视化走访——尝试了解各个参数的情况,以确定最佳前进路径。
最后,组织中数据分析的民主化将使您能够更快地实现更大的目标:将强大的工具交到用户手中,向他们展示如何构建和解释模型,然后坐下来享受!
数据源
这些数据是收集到的通过美国能源部和 BP 阿拉斯加勘探公司 (BPXA) 与美国地质调查局 (USGS) 以及几所大学和行业合作伙伴之间的合作钻探协议,评估阿拉斯加北坡的天然气水合物是否可以在技术上或商业上。 Mt. Elbert 井于 2007 年钻探,数据可通过拉蒙特多尔蒂地球观测站在哥伦比亚大学。 我对数据进行子集化、清理并使其在 JMP 表中可用JMP公开(注:无JMP专业版,GenReg、Neural w/KFold 和 XGBoost 脚本将不会执行。 此外,XGBoost 脚本需要 JMP Pro 和XGBoost 插件)。
感谢您提供如此翔实且详尽的文章! 好吧,我还使用 JMP Pro 来处理相应任务的化学问题。
好吧,我的问题是关于神经网络 (NN)。 在回归案例的 JMP 中,即使在固定的随机种子下,如果我们重新启动相同的模型,NN 的预测值与其所有指标(RMSE、R2 等)都不同。 对于分类,一切都是可重复的,维护指标。 您是否在保持相同条件的情况下重新安排了 NN 模型?
谢谢!
迈克尔
非常感谢你的问题@纳扎尔科夫斯基,这是你提出的一个非常重要的话题。 我遇到过开创性研究最终被撤回的情况,因为作者发现使用 NN 的相关性非常强,但是当其他用户在相同的数据上运行相同的 NN 但使用不同的随机开始时,发现相关性大大降低。 这是集成模型可以真正发挥作用的地方(例如 Bootstrap Forest、Boosted NN's 等)。 说了这么多,并强调了这样做的重要性,我不得不承认,我最初并没有这样做。 但是我无法自拔,在阅读了您的评论后,我返回并使用具有不同随机种子的相同设置重新运行了一系列 NN。 平均验证集 R^2 为 0.92 +/- 0.01,仅比我最初发现的低一点。
好东西,彼得! 请告诉我,RMSE 是怎样的。 因为,对于回归,RMSE 是主要的 KPI。 希望这个参数不会发生剧烈变化。 现在请告诉我,您是如何在 JMP Pro 上制作合奏的。 我的是 15.0,所以你的可能是 16,因为在第 15 个版本中没有遇到合奏。 我会非常感谢你!
Michael,这个特定数据集在六个随机开始时的均方根误差(JMP NN 报告中的第二个拟合度量)变化约 0.01,非常小。 对于集成模型,在 JMP Pro 中您可以使用 Bootstrap 森林或使用助推在神经网络或决策树中。 所有这些功能都在 JMP 15 Pro 中可用。 我希望这有帮助!
恭喜你,亲爱的同事! 你完成了一项出色的工作。 请特别感谢您对集成模型方法的建议。 周末愉快!
真挚地,
迈克尔

