高校時代の私の一番好きな授業は地球科学でした。気象学のセクションで毎日の天気予報を行っていたことを思い出します。毎朝、外に出て、乾球と湿球の温度、風速と風向を測定し、雲量を推定しました。一度か二度、私たちは教室に戻って、読み方が間違っていたり、意味が分からなかったりしたことに気づきました。問題ありません。外に戻って測定をやり直しました。50 歩歩いて測定をやり直すのは大したことではありませんでした。
問題
それから約 18 年が経ち、私はHelix Q4000に取り組んでおり、足元 1 マイル以上の堆積物からメタンハイドレートのサンプルを取得しようとしています。最初のコアを取得するまでに 24 時間以上かかりました。表面に上がったとき、何も正常に機能していませんでした。サンプルは減圧されており、回収された沈殿物の 10% 程度は単なるスープでした。高校時代に測定した温度とは異なり、戻って再試行することはできませんでした。その堆積物サンプルは永久に失われてしまいました。
これは、地質学者や技術者が過酷な地下環境で作業する際に常に直面する課題です。データの取得には費用がかかり、取得できるのは 1 回だけです。では、データが正常に返されない場合はどうすればよいでしょうか?もしかしたら、ツールが深さで失敗したり、さらに悪いことにスタックして井戸全体が放棄されなければならなくなったりするのでしょうか?私たちが持っているわずかな情報をどのように活用して有益に理解できるでしょうか?もちろん、 JMP Proの強力な予測ツールを使用できます。
実験
 Input parameters of Gamma (blue), Formation Density (red), Compressional Velocity (green), and Shear Velocity (purple). Interval one is >2064 ftkb and is above the black upper black line, interval two is between the two black lines (2065-2127 ftkb), and interval three is below the black line (2128-2206 ftkb).ガンマ (青)、地層密度 (赤)、圧縮速度 (緑)、およびせん断速度 (紫) の入力パラメーター。間隔 1 は >2064 ftkb で上の黒い線の上にあり、間隔 2 は 2 本の黒い線の間 (2065 ~ 2127 ftkb)、間隔 3 は黒い線の下 (2128 ~ 2206 ftkb) です。
取得が不十分な変数をより堅牢な変数から予測するいくつかの異なる方法を比較してみましょう。この例では、この特定の井戸 ( アラスカ州ノース スロープのエルバート山井戸) ではまばらに入手可能な炭化水素飽和 (メタン ハイドレート) を理解しようとしています。私たちが持っているのは、ガンマ線、地層密度、圧縮速度、せん断速度という 4 つの変数の完全なセットです。地下にはハイドレートを含む砂の間隔が 3 つあり、最初の間隔 (ケリー ブッシュの下 2003 ~ 2064 フィート、ftkb) を使用して、下の 2 つの間隔、2065 ~ 2127 ftkb と 2128 ~ におけるハイドレートの飽和を予測したいと考えています。それぞれ2206ftkb。標準最小二乗法、一般化回帰、ニューラル ネットワーク、XGBoost などのさまざまな予測モデルをテストします。モデル品質の最初のパスとして R2 値を使用しますが、その後、実際の坑井ログと予測坑井ログを定性的に評価して、各モデルの全体的な品質を評価します。
結果
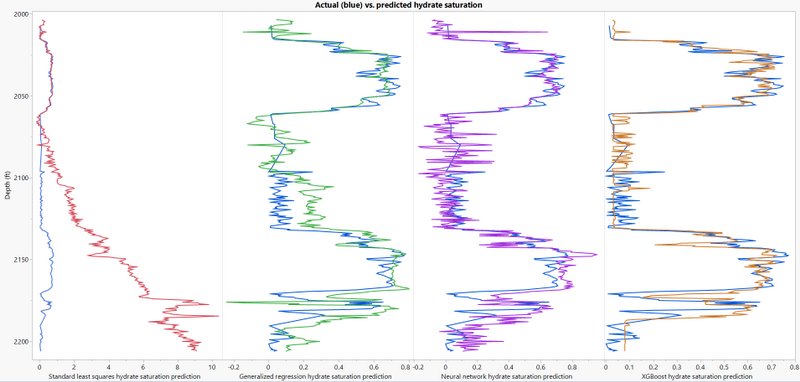 Actual hydrate saturation (blue) compared to predicted hydrate saturation for Standard Least Squares (red), Generalized Regression (green), Neural Network (purple), and XGBoost (burnt orange).標準最小二乗法 (赤)、一般化回帰 (緑)、ニューラル ネットワーク (紫)、および XGBoost (濃いオレンジ色) の予測されたハイドレート飽和と比較した実際のハイドレート飽和 (青)。
標準的な最小二乗法では十分ではありません。これは区間 1 を堅牢にモデル化しますが、下位 2 つの区間の炭化水素飽和度を正確に予測することはまったくできません。一般化回帰 (アダプティブ、エラスティック ネット) はわずかに優れていますが、一般に、下位 2 つの区間を 0.1 ~ 0.2 飽和単位で過大予測します。機械学習モデルはより堅牢な仕事をしますが、私は XGBoost に優位性を与えます。ニューラル ネットワークは、予測の 10 ~ 20% の過不足を占めるキックが多数あるため、はるかに「ノイズの多い」信号を生成しますが、XGBoost は、炭化水素の飽和度が低い場合と高い場合の両方で、より安定した予測を提供します。
これは、地質データや坑井データを扱うときに私が観察する共通のテーマです。自然システムは信じられないほど複雑で、不均一性が多く、機械学習モデル (ブートストラップ フォレスト、ニューラル ネットワーク、XGBoost など) はより優れた予測を提供する傾向があります。モデル全体。

 Model results for validation data sets of XGBoost (top) and Neural Network (bottom).XGBoost (上) と Neural Network (下) の検証データセットのモデル結果。
前進する
業界で働くほとんどの人は、単一の井戸よりもはるかに多くのデータをすぐに利用できるようになります。クラスタリングを使用して、地質パラメータ (岩質、間隙率、透水性など) を使用して井戸をグループ化し、クラスターごとに予測モデルを構築することを推奨します。この方法を使用すると、モデルが特定の遊び、さらには特定の遊び内の特定の盆地専用に構築されているため、より良い結果を達成できます。さらに、グラフ ビルダーでデータを視覚的に確認して、個々のパラメーターで何が起こっているのかを把握して、今後の最適な道筋を特定することをお勧めします。
最後に、組織内でのデータ分析の民主化により、より大きな目的をより早く達成できるようになります。強力なツールをユーザーに手に入れ、モデルの構築方法と解釈方法を示し、後は座って楽しむことができます。
情報元
このデータは、アラスカ北斜面からの天然ガスハイドレートが採取できるかどうかを評価するために、米国地質調査所 (USGS) およびいくつかの大学および業界パートナーと協力して、DOE と BP Exploration Alaska (BPXA) の間の協力協定掘削を通じて収集されました。技術的にも商業的にも実行可能に生産される。エルバート山の井戸は 2007 年に掘削され、データはコロンビア大学のラモント ドハティ地球観測所を通じて入手できます。データをサブセット化し、クリーンアップして、 JMP Publicの JMP テーブルで利用できるようにしました (注: JMP Proがないと、GenReg、KFold 付きニューラル、および XGBoost スクリプトは実行されません。さらに、XGBoost スクリプトには JMP Pro とXGBoost アドイン)。
おめでとうございます、親愛なる同僚! あなたは素晴らしい仕事をしてくれました。 また、アンサンブルモデルへのアプローチに関してアドバイスをいただき、心より感謝申し上げます。 良い週末を!
心から、
マイケル
マイケル、この特定のデータセットの 6 回のランダムな開始にわたる変化の二乗平均平方根誤差 (JMP NN レポートの適合の 2 番目の尺度) の変動は ~0.01 であり、非常にわずかです。 アンサンブル モデルに関しては、JMP Pro では Bootstrap フォレストを使用するか、ブーストNN またはデシジョン ツリーで。 これらの機能はすべて JMP 15 Pro で利用できます。 これがお役に立てば幸いです!
すごいよ、ピーター! RMSE はどうだったのか教えてください。 回帰の場合、RMSE が主な KPI であるためです。 このパラメータが大幅に変更されないことを願っています。 では、JMP Pro でアンサンブルをどのように作成しているのか教えてください。 私のバージョンは 15.0 なので、15 バージョンではアンサンブルが発生しないため、あなたのバージョンは 16 になる可能性があります。 とても感謝しています!
ご質問ありがとうございます@ナザルコフスキー、これはあなたが提起した非常に重要なトピックです。 著者が NN を使用して非常に堅牢な相関関係を発見したにもかかわらず、他のユーザーが同じデータに対して同じ NN を実行し、別のランダムスタートを使用した場合には、大幅に低い相関関係が見つかったため、独創的な研究が最終的に撤回された例に遭遇しました。 これは、アンサンブル モデルが本当に役立つ場所です (例: Bootstrap Forest、Boosted NN など)。 ここまで述べ、これを行うことの重要性を強調しましたが、私は最初からこれを行ったわけではないことを認めなければなりません。 しかし、私は自分自身を助けることができず、あなたのコメントを読んだ後、戻って、異なるランダムシードで同じ設定を使用して一連のNNを再実行しました。 平均検証セット R^2 は 0.92 +/- 0.01 で、最初に見つけた値よりわずかに低かったです。
このような有益で徹底的に書かれた投稿をありがとう! さて、私はそれぞれのタスクで JMP Pro を使用して化学にも取り組んでいます。
さて、私の質問はニューラル ネットワーク (NN) についてです。 回帰ケースの JMP では、固定ランダム シードであっても、同じモデルを再起動すると、NN による予測値はすべてのメトリクス (RMSE、R2 など) と異なります。 分類では、メトリクスを維持しながらすべてが再現可能です。 NN モデルを同じ条件を維持して再配置してプレイしましたか?
ありがとう!
マイケル

