高中時我最喜歡的課程是地球科學。我記得在氣象學部分每天都會讀取天氣資料。每天早上,我們都會到戶外測量乾濕球溫度、風速和風向,並估計雲量。有一兩次,我們回到教室卻發現閱讀內容沒有完成或沒有意義。沒問題,我們回到外面重新測量——走 50 步並重新測量沒什麼大不了的。
問題
快進到大約 18 年,我正在開發Helix Q4000 ,試圖從腳下一英里的沉積物中獲取甲烷水合物樣本。我們花了超過 24 小時才獲得第一個核心。當它到達表面時,一切都不起作用:樣品被減壓,回收的約 10% 的沉積物只是湯。與我在高中時的溫度讀數不同,我們無法返回並再次嘗試 - 沉積物樣本永遠消失了。
這是地質學家和工程師在惡劣的地下環境中經常面臨的挑戰。獲取數據的成本很高,而且您只能獲得一次機會。那麼,當資料沒有如預期返回時,您該怎麼辦?也許該工具在深度發生故障,或者更糟的是,被卡住,整個井都必須廢棄?我們怎樣才能利用我們所掌握的少量資訊並對其進行有用的理解呢?當然,我們可以使用JMP Pro強大的預測工具!
本實驗
 Input parameters of Gamma (blue), Formation Density (red), Compressional Velocity (green), and Shear Velocity (purple). Interval one is >2064 ftkb and is above the black upper black line, interval two is between the two black lines (2065-2127 ftkb), and interval three is below the black line (2128-2206 ftkb).輸入參數:伽瑪(藍色)、地層密度(紅色)、壓縮速度(綠色)和剪切速度(紫色)。區間一大於 2064 ftkb,位於黑色上黑線上方,區間二位於兩條黑線 (2065-2127 ftkb) 之間,區間三位於黑線下方 (2128-2206 ftkb)。
讓我們比較一下預測不良獲取變數和更穩健變數的幾種不同方法。在本例中,我們試圖了解碳氫化合物飽和度(甲烷水合物),這在該特定井( 阿拉斯加州北坡埃爾伯特井)中很少獲得。我們擁有的是完整的四個變數集:伽馬射線、地層密度、壓縮速度和剪切速度。在地下,有三個含水合物砂層段,我們希望使用第一個層段(方鑽桿套管下方2003-2064 英尺,ftkb)來預測較低的兩層段(2065-2127 ftkb 和2128-2128 ftkb)的水合物飽和度。分別為 2206 ftkb。我們將測試不同的預測模型:標準最小平方法、廣義迴歸、神經網路和 XGBoost。我們將使用 R2 值作為模型品質的第一步,但隨後將定性評估實際與預測測井曲線,以評估每個模型的整體品質。
結果
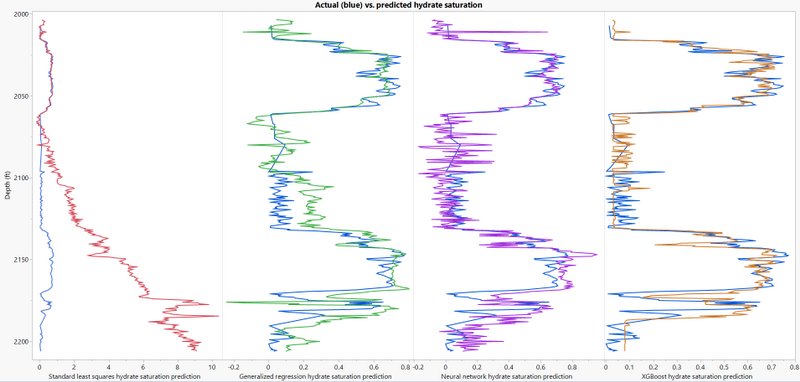 Actual hydrate saturation (blue) compared to predicted hydrate saturation for Standard Least Squares (red), Generalized Regression (green), Neural Network (purple), and XGBoost (burnt orange).實際水合物飽和度(藍色)與標準最小平方法(紅色)、廣義迴歸(綠色)、神經網路(紫色)和 XGBoost(焦橙色)預測的水合物飽和度進行比較。
標準最小平方法並不能解決這個問題。它對區間 1 進行了穩健建模,但完全無法準確預測較低兩個區間的碳氫化合物飽和度。廣義迴歸(自適應;彈性網路)稍好一些,但通常會高估較低的兩個區間 0.1 到 0.2 個飽和單位。機器學習模型的工作更加穩健,但我認為 XGBoost 更具優勢。神經網路產生的訊號非常“雜訊”,因為存在大量的衝擊,佔預測的 10-20%,而 XGBoost 在低碳氫化合物飽和度和高碳氫化合物飽和度下都提供了更穩定的預測。
這是我在處理地質和/或井下資料時觀察到的常見主題:自然系統非常複雜,充滿異質性,機器學習模型(Bootstrap Forest、神經網路和 XGBoost 等)往往能提供更好的預測整體模型。

 Model results for validation data sets of XGBoost (top) and Neural Network (bottom).XGBoost(上)和神經網路(下)驗證資料集的模型結果。
向前進
大多數在該行業工作的人都將擁有比單口井更多的數據。一種強有力的做法是使用聚類,利用地質參數(岩性、孔隙度、滲透率等)將井分組在一起,並按聚類建立預測模型。這種方法可以使您獲得更好的結果,因為該模型是專門為特定區域甚至特定區域內的特定流域而建造的。除此之外,一個很好的做法是在圖形生成器中對數據進行可視化漫遊 - 嘗試了解各個參數的情況,以確定最佳的前進路徑。
最後,組織中資料分析的民主化將使您能夠更快地實現更大的目標:將強大的工具交到使用者手中,向他們展示如何建立和解釋模型,然後坐下來享受!
資料來源
這些數據是透過美國能源部和BP Exploration Alaska (BPXA) 之間的合作鑽探協議收集的,並與美國地質調查局(USGS) 以及幾所大學和行業合作夥伴合作,以評估來自阿拉斯加北坡的天然氣水合物是否可以開採。技術上或商業上可行的生產。艾伯特山井於 2007 年鑽探,數據可透過哥倫比亞大學拉蒙特多爾蒂地球觀測站取得。我將資料子集化、清理並使其在JMP Public上的 JMP 表中可用(注意:如果沒有JMP Pro ,GenReg、帶有 KFold 的 Neural 和 XGBoost 腳本將無法執行。此外,XGBoost 腳本需要 JMP Pro 和XGBoost 插件)。
恭喜你,親愛的同事! 你的工作表現非常出色。 特別感謝您就整合模型方法提出的建議。 有一個美好的週末!
真摯地,
麥可
Michael,此特定資料集的均方根誤差(JMP NN 報告中擬合的第二個測量值)在六個隨機開始中的變化約為 0.01,相當小。 至於整合模型,在 JMP Pro 中您可以使用 Bootstrap 森林或使用提升在神經網路或決策樹中。 所有這些功能均在 JMP 15 Pro 中提供。 我希望這有幫助!
好東西,彼得! 請告訴我 RMSE 是多少。 因為對於迴歸來說,RMSE 是主要 KPI。 希望這個參數不會有太大變化。 現在請告訴我您如何在 JMP Pro 上製作合奏。 我的是 15.0,所以你的可能是 16,因為在 15 版本中沒有遇到這些合奏。 我將非常感謝你!
非常感謝你的提問@納扎爾科夫斯基,這是您提出的一個非常重要的主題。 我遇到一些開創性的研究最終被撤銷的例子,因為作者使用神經網路發現了非常強大的相關性,但當其他用戶在相同的數據上運行相同的神經網路但使用不同的隨機開始時,發現相關性大大降低。 這就是整合模型真正可以幫助的地方(例如 Bootstrap Forest、Boosted NN 等)。 說了這一切並強調了這樣做的重要性,我不得不承認我最初並沒有這樣做。 但我無法控制自己,在閱讀了你的評論後,我回去並使用相同的設定和不同的隨機種子重新運行了一系列神經網路。 平均驗證集 R^2 為 0.92 +/- 0.01,僅比我最初發現的低一點。
感謝您提供如此內容豐富且寫得詳盡的帖子! 嗯,我還使用 JMP Pro 來處理化學相關的任務。
嗯,我的問題是關於神經網路(NN)的。 在 JMP 的迴歸案例中,即使使用固定隨機種子,如果我們重新啟動相同的模型,NN 的預測值也會因其所有指標(RMSE、R2 等)而有所不同。 對於分類,一切都是可重複的,維護指標。 您是否在保持相同條件的情況下重新排列您的神經網路模型?
謝謝!
麥可

