La mia lezione preferita al liceo era Scienze della Terra. Ricordo di aver effettuato letture meteorologiche giornaliere durante la nostra sezione di meteorologia. Ogni mattina uscivamo, misuravamo la temperatura del bulbo umido e secco, la velocità e la direzione del vento e stimavamo la copertura nuvolosa. Una o due volte siamo tornati in classe solo per renderci conto che una lettura era sbagliata o non aveva senso. Nessun problema, siamo tornati fuori e abbiamo rifatto la misurazione: non è stato un grosso problema fare 50 passi e ripetere la misurazione.
Il problema
Avanti veloce di circa 18 anni e sto lavorando sull'Helix Q4000 , tentando di acquisire campioni di idrato di metano dai sedimenti a oltre un miglio sotto i miei piedi. Ci sono volute più di 24 ore per acquisire il nostro primo nucleo. Quando è venuto in superficie, nulla aveva funzionato correttamente: il campione era depressurizzato e circa il 10% del sedimento recuperato era solo zuppa. A differenza delle mie letture della temperatura al liceo, non potevamo tornare indietro e riprovare: quel campione di sedimento era scomparso per sempre.
Questa è la sfida che geologi e ingegneri affrontano regolarmente lavorando nei difficili ambienti del sottosuolo. I dati sono costosi da acquisire e hai solo una possibilità. Allora cosa fare quando i dati non ritornano come dovrebbero? Forse lo strumento si guasta in profondità o, peggio ancora, si blocca e l'intero pozzo deve essere abbandonato? Come possiamo prendere le poche informazioni che abbiamo e dargli un senso utile? Naturalmente possiamo utilizzare i potenti strumenti predittivi di JMP Pro !
L'esperimento
 Input parameters of Gamma (blue), Formation Density (red), Compressional Velocity (green), and Shear Velocity (purple). Interval one is >2064 ftkb and is above the black upper black line, interval two is between the two black lines (2065-2127 ftkb), and interval three is below the black line (2128-2206 ftkb).Parametri di input di Gamma (blu), Densità di formazione (rosso), Velocità di compressione (verde) e Velocità di taglio (viola). L'intervallo uno è >2064 ftkb ed è sopra la linea nera superiore, l'intervallo due è tra le due linee nere (2065-2127 ftkb) e l'intervallo tre è sotto la linea nera (2128-2206 ftkb).
Confrontiamo alcuni metodi diversi per prevedere una variabile scarsamente acquisita rispetto a variabili più robuste. In questo caso, stiamo cercando di comprendere la saturazione degli idrocarburi (idrato di metano), che è scarsamente disponibile in questo particolare pozzo ( pozzo Mt Elbert, North Slope, AK ). Ciò che abbiamo sono set completi di quattro variabili: raggi gamma, densità di formazione, velocità di compressione e velocità di taglio. Nel sottosuolo, ci sono tre intervalli di sabbie contenenti idrati e vogliamo utilizzare il primo intervallo (2003-2064 piedi sotto il kelly bushing, ftkb) per prevedere la saturazione di idrati nei due intervalli inferiori, 2065-2127 ftkb e 2128- 2206 ftkb, rispettivamente. Testeremo diversi modelli predittivi: minimi quadrati standard, regressione generalizzata, rete neurale e XGBoost. Utilizzeremo i valori R2 come primo passaggio della qualità del modello, ma poi valuteremo qualitativamente i registri dei pozzi effettivi rispetto a quelli previsti per valutare la qualità complessiva di ciascun modello.
Risultati
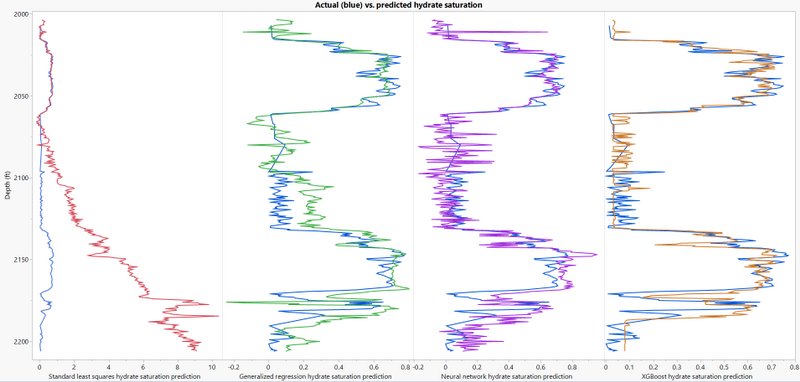 Actual hydrate saturation (blue) compared to predicted hydrate saturation for Standard Least Squares (red), Generalized Regression (green), Neural Network (purple), and XGBoost (burnt orange).Saturazione effettiva degli idrati (blu) rispetto alla saturazione degli idrati prevista per i minimi quadrati standard (rosso), regressione generalizzata (verde), rete neurale (viola) e XGBoost (arancione bruciato).
I minimi quadrati standard semplicemente non bastano. Modella in modo robusto l'Intervallo 1 ma non riesce completamente a prevedere con precisione la saturazione degli idrocarburi nei due intervalli inferiori. La regressione generalizzata (adattativa; rete elastica) è leggermente migliore, ma generalmente sovrastima i due intervalli inferiori di 0,1-0,2 unità di saturazione. I modelli di machine learning svolgono un lavoro molto più efficace, ma io do il vantaggio a XGBoost. La rete neurale produce un segnale molto "rumore" in quanto sono presenti numerosi kick che rappresentano il 10-20% di previsione sopra e sotto, mentre XGBoost fornisce una previsione molto più stabile sia a saturazioni di idrocarburi basse che alte.
Questo è un tema comune che osservo quando lavoro con dati geologici e/o downhole: i sistemi naturali sono incredibilmente complessi, carichi di eterogeneità e i modelli di apprendimento automatico (Bootstrap Forest, Neural Network e XGBoost, ecc.) tendono a fornire una migliore previsione modelli in generale.

 Model results for validation data sets of XGBoost (top) and Neural Network (bottom).Risultati del modello per set di dati di convalida di XGBoost (in alto) e Rete neurale (in basso).
Andando avanti
La maggior parte delle persone che lavorano nel settore avranno a portata di mano una quantità di dati sostanzialmente maggiore rispetto a un singolo pozzo. Una pratica diffusa è quella di utilizzare il clustering per raggruppare i pozzi insieme utilizzando parametri geologici (litologia, porosità, permeabilità, ecc.) e costruire modelli predittivi per cluster. Questo metodo può consentire di ottenere risultati migliori perché il modello è creato appositamente per uno spettacolo particolare, o anche per un bacino particolare all'interno di uno spettacolo particolare. Oltre a ciò, un'ottima pratica è fare una passeggiata visiva con i tuoi dati nel Costruttore di grafici: cercare di avere un'idea di cosa sta succedendo con i singoli parametri per identificare il percorso migliore da seguire.
Infine, la democratizzazione dell'analisi dei dati nella tua organizzazione ti consentirà di raggiungere obiettivi più ambiziosi più rapidamente: mettere a disposizione degli utenti strumenti potenti, mostrare loro come costruire e interpretare modelli, quindi sedersi e divertirsi!
Fonte di dati
Questi dati sono stati raccolti attraverso un accordo di cooperazione di perforazione tra DOE e BP Exploration Alaska (BPXA), in collaborazione con l'US Geological Survey (USGS) e diverse università e partner industriali, per valutare se l'idrato di gas naturale dell'Alaska North Slope potrebbe essere prodotto in modo sostenibile dal punto di vista tecnico o commerciale. Il pozzo Mt. Elbert è stato perforato nel 2007 e i dati sono disponibili tramite l' Osservatorio terrestre Lamont Doherty della Columbia University. Ho creato un sottoinsieme dei dati, li ho puliti e li ho resi disponibili in una tabella JMP su JMP Public (Nota: senza JMP Pro , gli script GenReg, Neural w/ KFold e XGBoost non verranno eseguiti. Inoltre, lo script XGBoost richiede JMP Pro e il componente aggiuntivo XGBoost ).
Congratulazioni, caro collega! Hai svolto un lavoro brillante. E per favore ricevi un ringraziamento speciale per i tuoi consigli riguardo agli approcci ai modelli d'insieme. Passa un buon fine settimana!
Cordiali saluti,
Michael
Michael, la radice quadrata dell'errore medio (seconda misura di adattamento nel report JMP NN) per questo particolare set di dati cambia su sei inizi casuali varia di ~ 0,01, un valore piuttosto lieve. Per quanto riguarda i modelli ensemble, in JMP Pro è possibile utilizzare la foresta Bootstrap o utilizzare potenziamento in NN o alberi decisionali. Tutte queste funzionalità sono disponibili in JMP 15 Pro. Spero che aiuti!
Grandi cose, Pietro! E dimmi, per favore, come erano gli RMSE. Perché, per le regressioni, RMSE è il KPI principale. Si spera che questo parametro non cambi drasticamente. Ora per favore fammi sapere come realizzi gli ensemble su JMP Pro. Il mio è 15.0, quindi il tuo potrebbe essere 16, poiché gli ensemble non si incontrano nella 15a versione. Te ne sarei molto grato!
Grazie mille per la domanda @Nazarkovskij , questo è un argomento molto importante che hai sollevato. Mi sono imbattuto in casi in cui la ricerca fondamentale è stata definitivamente ritrattata perché l'autore aveva trovato correlazioni molto solide utilizzando gli NN, ma quando altri utenti hanno eseguito gli stessi NN sugli stessi dati ma utilizzando un inizio casuale diverso hanno riscontrato correlazioni drasticamente inferiori. È qui che i modelli di insieme possono davvero aiutare (ad esempio Bootstrap Forest, Boosted NN, ecc.). Detto tutto questo e sottolineando l'importanza di farlo, devo ammettere che originariamente non l'ho fatto. MA non ho potuto trattenermi e dopo aver letto il tuo commento sono tornato indietro e ho eseguito nuovamente una serie di NN utilizzando impostazioni identiche con semi casuali diversi. Il set di validazione medio R^2 era 0,92 +/- 0,01, appena leggermente inferiore a quello trovato originariamente.
Grazie per un post così informativo e scritto in modo approfondito! Ebbene, mi occupo anche di chimica utilizzando JMP Pro per i rispettivi compiti.
Bene, la mia domanda riguarda la rete neurale (NN). In JMP per i casi di regressione, anche al seme casuale fisso, i valori previsti da NN differiscono con tutte le loro metriche (RMSE, R2 ecc.) se rilanciamo il modello identico. Per la classificazione tutto è ripetibile mantenendo le metriche. Hai giocato a riorganizzare il tuo modello NN mantenendo le stesse condizioni?
Grazie!
Michael

