Mi clase favorita en la escuela secundaria era Ciencias de la Tierra. Recuerdo haber tomado lecturas meteorológicas diarias durante nuestra sección de meteorología. Todas las mañanas salíamos, medimos la temperatura del bulbo húmedo y seco, la velocidad y dirección del viento y estimamos la nubosidad. Una o dos veces regresamos al salón de clases sólo para darnos cuenta de que una lectura estaba equivocada o no tenía sentido. No hay problema, volvimos a salir y rehicimos la medición; no fue gran cosa caminar los 50 pasos y volver a tomar la medición.
El problema
Avancemos unos 18 años y estoy trabajando en el Helix Q4000 , intentando adquirir muestras de hidrato de metano de sedimentos a más de una milla bajo mis pies. Nos llevó más de 24 horas adquirir nuestro primer núcleo. Cuando llegó a la superficie, nada había funcionado correctamente: la muestra estaba despresurizada y el 10% aproximadamente del sedimento recuperado era solo sopa. A diferencia de mis lecturas de temperatura en la escuela secundaria, no pudimos regresar e intentarlo de nuevo: esa muestra de sedimento desapareció para siempre.
Este es el desafío al que se enfrentan habitualmente los geólogos e ingenieros al trabajar en los duros entornos subterráneos. Los datos son costosos de adquirir y solo hay una oportunidad. Entonces, ¿qué haces cuando los datos no regresan como deberían? ¿Quizás la herramienta falla en profundidad o, peor aún, se atasca y hay que abandonar todo el pozo? ¿Cómo podemos tomar la poca información que tenemos y darle un sentido útil? ¡Podemos utilizar las poderosas herramientas predictivas de JMP Pro , por supuesto!
El experimento
 Input parameters of Gamma (blue), Formation Density (red), Compressional Velocity (green), and Shear Velocity (purple). Interval one is >2064 ftkb and is above the black upper black line, interval two is between the two black lines (2065-2127 ftkb), and interval three is below the black line (2128-2206 ftkb).Parámetros de entrada de Gamma (azul), Densidad de formación (rojo), Velocidad de compresión (verde) y Velocidad de corte (púrpura). El intervalo uno es >2064 ftkb y está por encima de la línea negra superior, el intervalo dos está entre las dos líneas negras (2065-2127 ftkb) y el intervalo tres está debajo de la línea negra (2128-2206 ftkb).
Comparemos algunos métodos diferentes para predecir una variable mal adquirida con otros más sólidos. En este caso, estamos tratando de comprender la saturación de hidrocarburos (hidrato de metano), que está escasamente disponible en este pozo en particular ( pozo Mt Elbert, North Slope, AK ). Lo que sí tenemos son conjuntos completos de cuatro variables: rayos gamma, densidad de formación, velocidad de compresión y velocidad de corte. En el subsuelo, hay tres intervalos de arenas que contienen hidratos, y queremos usar el primer intervalo (2003-2064 pies debajo del casquillo Kelly, ftkb) para predecir la saturación de hidratos en los dos intervalos inferiores, 2065-2127 ftkb y 2128- 2206 ftkb, respectivamente. Probaremos diferentes modelos predictivos: mínimos cuadrados estándar, regresión generalizada, red neuronal y XGBoost. Usaremos los valores de R2 como un primer paso de la calidad del modelo, pero luego evaluaremos cualitativamente los registros de pozo reales versus los pronosticados para evaluar la calidad general de cada modelo.
Resultados
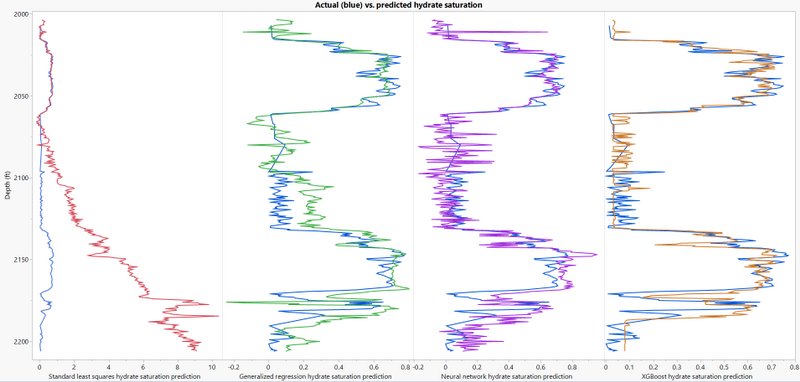 Actual hydrate saturation (blue) compared to predicted hydrate saturation for Standard Least Squares (red), Generalized Regression (green), Neural Network (purple), and XGBoost (burnt orange).Saturación de hidratos real (azul) comparada con la saturación de hidratos prevista para mínimos cuadrados estándar (rojo), regresión generalizada (verde), red neuronal (púrpura) y XGBoost (naranja quemado).
Los mínimos cuadrados estándar simplemente no son suficientes. Modela de manera sólida el Intervalo 1, pero no logra predecir con precisión la saturación de hidrocarburos en los dos intervalos inferiores. La regresión generalizada (adaptativa; red elástica) es ligeramente mejor, pero generalmente sobrepredice los dos intervalos inferiores entre 0,1 y 0,2 unidades de saturación. Los modelos de aprendizaje automático hacen un trabajo mucho más sólido, pero le doy la ventaja a XGBoost. Neural Network produce una señal mucho más "ruidosa" en el sentido de que hay numerosos impulsos que representan entre un 10% y un 20% de predicción por encima y por debajo, mientras que XGBoost proporciona una predicción mucho más estable en saturaciones de hidrocarburos tanto bajas como altas.
Este es un tema común que observo cuando trabajo con datos geológicos y/o de fondo de pozo: los sistemas naturales son increíblemente complejos, plagados de heterogeneidades y los modelos de aprendizaje automático (Bootstrap Forest, Neural Network y XGBoost, etc.) tienden a proporcionar mejores predicciones. modelos en general.

 Model results for validation data sets of XGBoost (top) and Neural Network (bottom).Resultados del modelo para conjuntos de datos de validación de XGBoost (arriba) y Neural Network (abajo).
Avanzando
La mayoría de las personas que trabajan en la industria tendrán sustancialmente más datos a su alcance que un solo pozo. Una práctica sólida es utilizar la agrupación para agrupar pozos utilizando parámetros geológicos (litología, porosidad, permeabilidad, etc.) y construir modelos predictivos por agrupación. Este método puede permitirle lograr mejores resultados porque el modelo está diseñado específicamente para una obra en particular, o incluso para una cuenca particular dentro de una obra en particular. Más allá de eso, una buena práctica es realizar un recorrido visual con sus datos en Graph Builder: intente tener una idea de lo que sucede con los parámetros individuales para identificar el mejor camino a seguir.
Por último, la democratización del análisis de datos en su organización le permitirá alcanzar mayores objetivos más rápidamente: poner herramientas poderosas en manos de los usuarios, mostrarles cómo construir e interpretar modelos y luego sentarse y disfrutar.
Fuente de datos
Estos datos se recopilaron a través de un acuerdo de cooperación entre el DOE y BP Exploration Alaska (BPXA), en colaboración con el Servicio Geológico de EE. UU. (USGS) y varias universidades y socios industriales, para evaluar si el hidrato de gas natural de la vertiente norte de Alaska podría ser producidos de manera viable, ya sea técnica o comercialmente. El pozo Mt. Elbert se perforó en 2007 y los datos están disponibles a través del Observatorio Terrestre Lamont Doherty de la Universidad de Columbia. Subconstruí los datos, los limpié y los puse a disposición en una tabla JMP en JMP Public (Nota: sin JMP Pro , los scripts GenReg, Neural w/ KFold y XGBoost no se ejecutarán. Además, el script XGBoost requiere JMP Pro y el complemento XGBoost ).
¡Felicidades, querido colega! Has realizado un trabajo brillante. Y reciba un agradecimiento especial por sus consejos sobre cómo abordar los modelos de conjunto. ¡Tener un buen fin de semana!
Atentamente,
Miguel
Michael, la raíz del error cuadrático promedio (segunda medida de ajuste en el informe JMP NN) para los cambios de este conjunto de datos en particular en seis inicios aleatorios varía en ~0,01, algo bastante menor. En cuanto a los modelos de conjunto, en JMP Pro puedes usar el bosque Bootstrap o usar impulsando en NN o árboles de decisión. Todas estas funciones están disponibles en JMP 15 Pro. ¡Espero que esto ayude!
¡Qué gran cosa, Pedro! Y cuéntame por favor, cómo eran los RMSE. Porque, para las regresiones, RMSE es el principal KPI. Esperemos que este parámetro no cambie drásticamente. Ahora déjame saber cómo haces los conjuntos en JMP Pro. El mío es 15.0, por lo que el tuyo puede ser 16, ya que los conjuntos no se encuentran en la versión 15. ¡Te lo agradecería mucho!
Muchas gracias por la pregunta @Nazarkovsky , este es un tema muy importante que has mencionado. Me he encontrado con casos en los que la investigación fundamental finalmente se retractó porque el autor había encontrado correlaciones muy sólidas usando NN, pero cuando otros usuarios ejecutaron los mismos NN con los mismos datos pero usando un inicio aleatorio diferente, encontraron correlaciones drásticamente más bajas. Aquí es donde los modelos de conjunto realmente pueden ayudar (por ejemplo, Bootstrap Forest, Boosted NN, etc.). Habiendo dicho todo esto y resaltando la importancia de hacer esto, debo admitir que no lo hice originalmente. PERO no pude evitarlo y después de leer tu comentario volví y volví a ejecutar una serie de NN usando configuraciones idénticas con diferentes semillas aleatorias. El conjunto de validación medio R^2 fue 0,92 +/- 0,01, un poco más bajo de lo que encontré originalmente.
¡Gracias por una publicación tan informativa y minuciosamente escrita! Bueno, también me ocupo de la química utilizando JMP Pro para las respectivas tareas.
Bueno, mi pregunta es sobre la red neuronal (NN). En JMP para los casos de regresión, incluso con la semilla aleatoria fija, los valores predichos por NN difieren con todas sus métricas (RMSE, R2, etc.) si relanzamos un modelo idéntico. Para la clasificación todo es repetible manteniendo las métricas. ¿Jugaste reorganizando tu modelo NN manteniendo condiciones idénticas?
¡Gracias!
Miguel

