Meine Lieblingsklasse in der High School war Geowissenschaften. Ich erinnere mich, dass ich während unserer Meteorologie-Sektion tägliche Wettermessungen gemacht habe. Jeden Morgen gingen wir nach draußen, maßen die Feucht- und Trockenkugeltemperatur, Windgeschwindigkeit und -richtung und schätzten die Wolkenbedeckung. Ein- oder zweimal kehrten wir ins Klassenzimmer zurück, nur um festzustellen, dass eine Lesung nicht funktionierte oder keinen Sinn ergab. Kein Problem, wir gingen wieder nach draußen und machten die Messung erneut – es war keine große Sache, die 50 Schritte zu gehen und die Messung zu wiederholen.
Das Problem
Schneller Vorlauf über 18 Jahre, und ich arbeite an der Helix Q4000 , bei dem Versuch, Methanhydratproben aus Sedimenten über eine Meile unter meinen Füßen zu gewinnen. Es dauerte über 24 Stunden, um unseren ersten Kern zu beschaffen. An der Oberfläche hatte nichts richtig funktioniert: Die Probe war drucklos und die etwa 10 % des gewonnenen Sediments waren nur Suppe. Im Gegensatz zu meinen Temperaturmessungen in der High School konnten wir nicht zurückgehen und es noch einmal versuchen – diese Sedimentprobe war für immer verschwunden.
Dieser Herausforderung stellen sich Geologen und Ingenieure bei der Arbeit in den rauen Untergrundumgebungen regelmäßig. Die Erfassung der Daten ist teuer, und Sie erhalten nur eine Aufnahme. Was also tun, wenn die Daten nicht wie gewünscht zurückkommen? Vielleicht versagt das Werkzeug in der Tiefe oder noch schlimmer, bleibt stecken und muss das gesamte Bohrloch verlassen? Wie können wir die wenigen Informationen, die wir haben, sinnvoll nutzen? Wir können benutzen JMP Pro 's leistungsstarke Vorhersagewerkzeuge, natürlich!
Das Experiment
 Eingabeparameter Gamma (blau), Formationsdichte (rot), Kompressionsgeschwindigkeit (grün) und Schergeschwindigkeit (violett). Intervall eins ist >2064 ftkb und liegt oberhalb der schwarzen oberen schwarzen Linie, Intervall zwei liegt zwischen den beiden schwarzen Linien (2065-2127 ftkb) und Intervall drei liegt unterhalb der schwarzen Linie (2128-2206 ftkb).
Lassen Sie uns einige verschiedene Methoden zur Vorhersage einer schlecht erfassten Variablen mit robusteren vergleichen. In diesem Fall versuchen wir die Kohlenwasserstoffsättigung (Methanhydrat) zu verstehen, die in diesem speziellen Bohrloch nur spärlich verfügbar ist ( Mt Elbert gut, Nordhang, AK ). Was wir haben, sind vollständige Sätze von vier Variablen: Gammastrahlung, Formationsdichte, Kompressionsgeschwindigkeit und Schergeschwindigkeit. Im Untergrund gibt es drei Intervalle mit hydrathaltigen Sanden, und wir möchten das erste Intervall (2003-2064 Fuß unterhalb der Kelly Bushing, ftkb) verwenden, um die Hydratsättigung in den unteren beiden Intervallen, 2065-2127 ftkb und 2128- 2206 ftkb bzw. Wir testen verschiedene Vorhersagemodelle: Standard Least Squares, Generalized Regression, Neural Network und XGBoost. Wir verwenden die R2-Werte als ersten Durchlauf der Modellqualität, bewerten dann jedoch die tatsächlichen vs. vorhergesagten Bohrlochprotokolle qualitativ, um die Gesamtqualität jedes Modells zu bewerten.
Ergebnisse
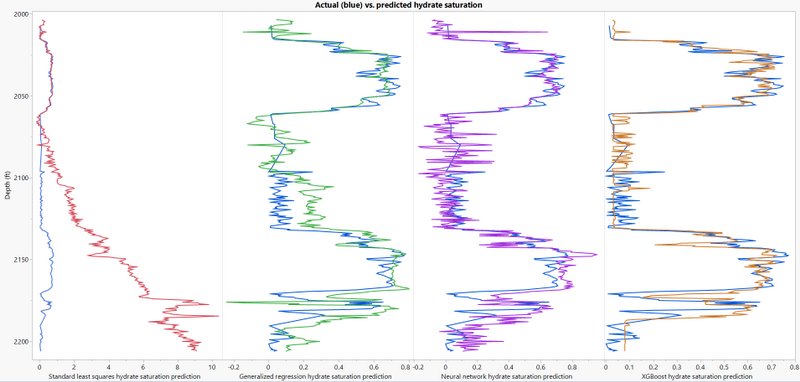 Tatsächliche Hydratsättigung (blau) im Vergleich zur vorhergesagten Hydratsättigung für Standard Least Squares (rot), generalisierte Regression (grün), neuronales Netzwerk (lila) und XGBoost (gebrannte Orange).
Standard Least Squares reicht einfach nicht. Es modelliert das Intervall 1 robust, kann jedoch die Kohlenwasserstoffsättigung in den unteren beiden Intervallen nicht mit irgendeiner Genauigkeit vorhersagen. Die generalisierte Regression (adaptiv; elastisches Netz) ist geringfügig besser, überschätzt jedoch im Allgemeinen die unteren beiden Intervalle um 0,1 bis 0,2 Sättigungseinheiten. Die Modelle für maschinelles Lernen leisten eine viel robustere Arbeit, aber ich gebe XGBoost den Vorteil. Das neuronale Netzwerk erzeugt ein viel "rauschendes" Signal, da es zahlreiche Kicks gibt, die 10-20% Über- und Untervorhersage ausmachen, während XGBoost eine viel stabilere Vorhersage sowohl bei niedrigen als auch bei hohen Kohlenwasserstoffsättigungen bietet.
Dies ist ein häufiges Thema, das ich bei der Arbeit mit geologischen und/oder Bohrlochdaten beobachte: Die natürlichen Systeme sind unglaublich komplex, voller Heterogenitäten, und Modelle des maschinellen Lernens (Bootstrap Forest, Neural Network und XGBoost usw.) bieten tendenziell bessere Vorhersagen Modelle insgesamt.

 Modellergebnisse für Validierungsdatensätze von XGBoost (oben) und neuronalen Netzen (unten).
Vorwärts gehen
Die meisten Leute, die in der Branche arbeiten, werden wesentlich mehr Daten zur Hand haben als ein einzelner Brunnen. Eine starke Praxis ist die Clusterbildung, um Bohrlöcher unter Verwendung geologischer Parameter (Lithologie, Porosität, Permeabilität usw.) zu gruppieren und Vorhersagemodelle nach Clustern zu erstellen. Mit dieser Methode können Sie bessere Ergebnisse erzielen, da das Modell speziell für ein bestimmtes Spiel oder sogar ein bestimmtes Becken innerhalb eines bestimmten Spiels entwickelt wurde. Darüber hinaus ist es eine gute Übung, mit Ihren Daten im Graph Builder einen visuellen Rundgang zu machen – versuchen Sie, ein Gefühl dafür zu bekommen, was mit einzelnen Parametern vor sich geht, um den besten Weg nach vorne zu identifizieren.
Schließlich wird die Demokratisierung der Datenanalyse in Ihrem Unternehmen es Ihnen ermöglichen, schneller größere Ziele zu erreichen: Benutzern leistungsstarke Tools in die Hand geben, ihnen zeigen, wie Modelle erstellt und interpretiert werden, und dann lehnen Sie sich zurück und genießen Sie!
Datenquelle
Diese Daten wurden erhoben durch eine Kooperationsvereinbarung Bohrungen zwischen DOE und BP Exploration Alaska (BPXA), in Zusammenarbeit mit dem US Geological Survey (USGS) und mehreren Universitäten und Industriepartnern, um zu bewerten, ob Erdgashydrat aus dem Alaska North Slope entweder technisch oder kommerziell. Die Quelle Mt. Elbert wurde 2007 gebohrt, und die Daten sind über die Erdobservatorium Lamont Doherty an der Columbia-Universität. Ich habe die Daten untergeordnet, bereinigt und in einer JMP-Tabelle verfügbar gemacht JMP Öffentlich (Hinweis: Ohne JMP Pro , werden die Skripte GenReg, Neural w/KFold und XGBoost nicht ausgeführt. Darüber hinaus erfordert das XGBoost-Skript JMP Pro und die XGBoost-Add-In ).
Danke für diesen informativen und ausführlich geschriebenen Beitrag! Nun, ich beschäftige mich auch mit Chemie mit JMP Pro für die jeweiligen Aufgaben.
Nun, meine Frage bezieht sich auf das neuronale Netzwerk (NN). In JMP für die Regressionsfälle unterscheiden sich die prognostizierten Werte von NN selbst beim festen Zufallsstartwert mit all ihren Metriken (RMSE, R2 usw.), wenn wir das identische Modell erneut starten. Für die Klassifizierung ist alles wiederholbar, indem die Metriken beibehalten werden. Haben Sie gespielt, Ihr NN-Modell unter Beibehaltung der gleichen Bedingungen neu zu arrangieren?
Vielen Dank!
Michael
Vielen Dank für die Frage @Nazarkovsky , dies ist ein sehr wichtiges Thema, das Sie angesprochen haben. Ich bin auf Fälle gestoßen, in denen bahnbrechende Forschungen endgültig zurückgezogen wurden, weil der Autor sehr robuste Korrelationen mit NNs gefunden hatte, aber als andere Benutzer die gleichen NNs mit den gleichen Daten, aber mit einem anderen zufälligen Start ausführten, fanden sich drastisch niedrigere Korrelationen. Hier können Ensemble-Modelle wirklich helfen (zB Bootstrap Forest, Boosted NN's, etc.). Nachdem ich all dies gesagt und die Bedeutung dieser Vorgehensweise hervorgehoben habe, muss ich zugeben, dass ich dies ursprünglich nicht getan habe. ABER ich konnte nicht anders und nachdem ich Ihren Kommentar gelesen hatte, ging ich zurück und ließ eine Reihe von NNs mit identischen Einstellungen mit unterschiedlichen zufälligen Seeds erneut laufen. Der durchschnittliche Validierungssatz R^2 war 0,92 +/- 0,01, nur etwas niedriger als das, was ich ursprünglich gefunden habe.
Tolle Sache, Peter! Und sagen Sie mir bitte, wie RMSEs waren. Denn für die Regressionen ist RMSE der wichtigste KPI. Hoffentlich ändert sich dieser Parameter nicht drastisch. Lassen Sie mich nun wissen, wie Sie die Ensembles auf JMP Pro erstellen. Meins ist 15,0, deins kann also 16 sein, da die Ensembles in der 15. Version nicht angetroffen werden. Ich wäre Ihnen sehr dankbar!
Michael, der quadratische Fehler (zweites Maß für die Anpassung im JMP NN-Bericht) für diese bestimmten Datensatzänderungen bei sechs zufälligen Starts variiert um ~ 0,01, ziemlich gering. Was Ensemble-Modelle betrifft, können Sie in JMP Pro Bootstrap Forest verwenden oder verwenden erhöhen in NN oder Entscheidungsbäumen. Alle diese Funktionen sind in JMP 15 Pro verfügbar. Ich hoffe das hilft!
Herzlichen Glückwunsch, lieber Kollege! Sie haben einen brillanten Job gemacht. Und bitte herzlichen Dank für Ihre Hinweise zu den Ansätzen von Ensemblemodellen. Ein schönes Wochenende!
Aufrichtig,
Michael

