高校での私の好きなクラスは地球科学でした。 気象学のセクションで毎日天気を読んだことを思い出します。 毎朝、外に出て、乾球温度と乾球温度、風速と風向を測定し、雲量を推定しました。 一度か二度、私たちは読書がオフであるか意味がないことに気づいただけで教室に戻りました。 問題ありません。外に戻って測定をやり直しました。50歩歩いて測定をやり直すのは大したことではありませんでした。
問題
約18年早送りし、私はに取り組んでいますHelix Q4000 、私の足の下1マイル以上の堆積物からメタンハイドレートサンプルを取得しようとしています。 最初のコアを取得するのに24時間以上かかりました。 表面に出たとき、何も適切に機能していませんでした。サンプルは減圧され、回収された堆積物の10%程度はただのスープでした。 高校での私の体温測定値とは異なり、戻って再試行することはできませんでした。その堆積物サンプルは永久になくなっていました。
これは、地質学者やエンジニアが過酷な地下環境での作業に定期的に直面する課題です。 データの取得には費用がかかり、1回のショットしか取得できません。 では、データが期待どおりに戻らない場合はどうしますか? たぶん、ツールは深さで失敗するか、さらに悪いことに、行き詰まり、井戸全体を放棄する必要がありますか? 私たちが持っている小さな情報をどのように取り、それを有用に理解することができますか? 使用できますJMPプロもちろん、の強力な予測ツールです。
実験
 ガンマ(青)、形成密度(赤)、圧縮速度(緑)、およびせん断速度(紫)の入力パラメーター。 間隔1は> 2064 ftkbで、黒い上部の黒い線の上にあり、間隔2は2つの黒い線の間にあり(2065-2127 ftkb)、間隔3は黒い線の下にあります(2128-2206ftkb)。
取得が不十分な変数をより堅牢な変数から予測するいくつかの異なる方法を比較してみましょう。 この例では、この特定の井戸でまばらに利用できる炭化水素飽和(メタンハイドレート)を理解しようとしています(アラスカ州ノーススロープのエルバート山)。 私たちが持っているのは、ガンマ線、地層密度、圧縮速度、せん断速度の4つの変数の完全なセットです。 地下には、ハイドレートを含む砂の3つの間隔があり、最初の間隔(ケリーブッシングの下2003-2064フィート、ftkb)を使用して、下の2つの間隔、2065-2127ftkbと2128-のハイドレート飽和を予測します。それぞれ2206フィートkb。 標準最小二乗法、一般化回帰、ニューラルネットワーク、XGBoostなどのさまざまな予測モデルをテストします。 モデル品質の最初のパスとしてR2値を使用しますが、その後、実際の検層と予測された検層を定性的に評価して、各モデルの全体的な品質を評価します。
結果
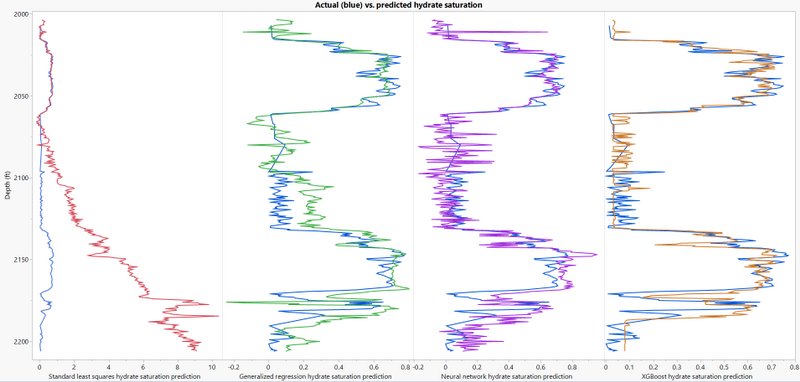 標準最小二乗(赤)、一般化回帰(緑)、ニューラルネットワーク(紫)、およびXGBoost(焦げたオレンジ)の予測されたハイドレート飽和と比較した実際のハイドレート飽和(青)。
標準最小二乗法はそれをカットしません。 区間1をロバストにモデル化しますが、下の2つの区間の炭化水素飽和度を正確に予測することはできません。 一般化回帰(適応型;エラスティックネット)はわずかに優れていますが、一般に、下の2つの間隔を0.1から0.2飽和単位だけ過大予測します。 機械学習モデルははるかに堅牢な仕事をしますが、私はXGBoostに優位性を与えます。 ニューラルネットワークは、予測の上下に10〜20%を占める多数のキックがあるという点で、はるかに「ノイズの多い」信号を生成しますが、XGBoostは、炭化水素の飽和度が低い場合と高い場合の両方で、はるかに安定した予測を提供します。
これは、地質データやダウンホールデータを扱うときに私が観察する一般的なテーマです。自然システムは非常に複雑で、不均一性に満ちており、機械学習モデル(ブートストラップフォレスト、ニューラルネットワーク、XGBoostなど)はより良い予測を提供する傾向があります全体的なモデル。

 XGBoost(上)とニューラルネットワーク(下)の検証データセットのモデル結果。
前進する
業界で働くほとんどの人々は、単一の井戸よりもはるかに多くのデータをすぐに利用できるようになります。 強力な方法は、クラスタリングを使用して、地質学的パラメーター(岩相、多孔性、浸透性など)を使用して井戸をグループ化し、クラスターごとに予測モデルを構築することです。 この方法では、モデルが特定のプレイ、または特定のプレイ内の特定の盆地向けに設計されているため、より良い結果を得ることができます。 それ以上に、グラフビルダーでデータを視覚的にウォークアバウトすることをお勧めします。個々のパラメーターで何が起こっているのかを把握して、最適なパスを特定してください。
最後に、組織内のデータ分析の民主化により、より大きな目的をより迅速に達成できるようになります。ユーザーの手に強力なツールを入手し、モデルの構築と解釈の方法を示してから、座って楽しんでください。
情報源
このデータは収集されました米国地質調査所(USGS)といくつかの大学および業界パートナーと協力して、DOEとBP Exploration Alaska(BPXA)の間の協力協定の掘削を通じて、アラスカ北極圏からの天然ガスハイドレートが技術的または商業的に。 エルバート山の井戸は2007年に掘削され、データはラモントドハティ地球観測所コロンビア大学で。 データをサブセット化し、クリーンアップして、上のJMPテーブルで利用できるようにしました。 JMPパブリック(注:なしJMPプロ、GenReg、Neural w / KFold、およびXGBoostスクリプトは実行されません。 さらに、XGBoostスクリプトにはJMPProとXGBoostアドイン)。
そのような有益で徹底的に書かれた投稿をありがとう! さて、私はそれぞれのタスクにJMPProを使用して化学も扱います。
さて、私の質問はニューラルネットワーク(NN)についてです。 回帰ケースのJMPでは、固定ランダムシードでも、同じモデルを再起動すると、NNによる予測値がすべてのメトリック(RMSE、R2など)で異なります。 分類については、メトリックを維持しながらすべてが再現可能です。 NNモデルを同じ条件に保ちながら再配置しましたか?
ありがとう!
マイケル
質問ありがとうございます@ナザルコフスキー、これはあなたが提起した非常に重要なトピックです。 著者がNNを使用して非常に堅牢な相関関係を見つけたが、他のユーザーが同じデータに対して同じNNを実行したが、異なるランダムスタートを使用した場合、相関関係が大幅に低くなったため、独創的な研究が最終的に撤回された例に出くわしました。 これは、アンサンブルモデルが実際に役立つ場所です(たとえば、ブートストラップフォレスト、ブーストされたNNなど)。 これをすべて言い、これを行うことの重要性を強調したので、私はもともとこれをしなかったことを認めなければなりません。 しかし、私は自分自身を助けることができませんでした、そしてあなたのコメントを読んだ後、私は戻って、異なるランダムシードで同じ設定を使用して一連のNNを再実行しました。 平均検証セットR ^ 2は0.92 +/- 0.01で、最初に見つけたものよりわずかに低かった。
素晴らしいもの、ピーター! そして、RMSEがどうだったか教えてください。 なぜなら、回帰の場合、RMSEがメインのKPIであるためです。 うまくいけば、このパラメータは大幅に変更されません。 JMPProでアンサンブルを作成する方法を教えてください。 私のは15.0なので、15番目のバージョンではアンサンブルに遭遇しないため、16になる可能性があります。 よろしくお願いします!
Michael、6回のランダムな開始にわたるこの特定のデータセットの変化のルート平均二乗誤差(JMP NNレポートの適合の2番目の尺度)は、約0.01だけ変動し、非常に小さいです。 アンサンブルモデルに関しては、JMP Proでは、ブートストラップフォレストを使用するか、ブースティングNNまたは決定木で。 これらの機能はすべて、JMP 15Proで使用できます。 これがお役に立てば幸いです。
おめでとう、親愛なる同僚! あなたは素晴らしい仕事をしました。 また、アンサンブルモデルへのアプローチに関するアドバイスに特に感謝します。 良い週末を!
心から、
マイケル

