고등학교 때 가장 좋아했던 수업은 지구과학이었습니다. 나는 기상학 섹션에서 매일 날씨를 읽었던 것을 기억합니다. 매일 아침 우리는 밖에 나가 습구 온도와 건구 온도, 풍속과 풍향을 측정하고 구름의 양을 추정했습니다. 한두 번, 우리는 읽기가 잘못되었거나 의미가 없다는 것을 깨닫기 위해 교실로 돌아왔습니다. 문제 없습니다. 우리는 밖에 나가서 다시 측정을 했습니다. 50보를 걸으면서 다시 측정을 하는 것은 큰 문제가 되지 않았습니다.
문제
약 18년을 빨리 감기, 나는 헬릭스 Q4000 , 내 발 아래 1마일 이상의 퇴적물에서 메탄 하이드레이트 샘플을 얻으려고 시도했습니다. 첫 번째 코어를 얻는 데 24시간 이상이 걸렸습니다. 표면에 나왔을 때 제대로 작동하는 것이 없었습니다. 샘플은 감압되었고 회수된 침전물의 10% 정도는 그냥 수프였습니다. 고등학교에서 측정한 온도와 달리, 우리는 되돌아가서 다시 시도할 수 없었습니다. 그 침전물 샘플은 영원히 사라졌습니다.
이것은 지질학자와 엔지니어가 가혹한 지하 환경에서 작업하면서 정기적으로 직면하는 과제입니다. 데이터는 수집하는 데 비용이 많이 들고 한 번만 얻을 수 있습니다. 그러면 데이터가 원래대로 돌아오지 않을 때 어떻게 해야 합니까? 아마도 도구가 깊이에서 실패하거나 더 나빠져서 막혀서 전체 우물을 버려야 합니까? 우리가 가진 작은 정보를 어떻게 유용하게 활용할 수 있습니까? 우리는 사용할 수 있습니다 JMP 프로 의 강력한 예측 도구는 물론입니다!
실험
 Gamma(파란색), Formation Density(빨간색), Compressional Velocity(녹색) 및 Shear Velocity(보라색)의 입력 매개변수. 간격 1은 >2064 ftkb이고 검은색 위쪽 검은색 선 위에 있고 간격 2는 두 검은색 선 사이(2065-2127 ftkb)이고 간격 3은 검은색 선 아래(2128-2206 ftkb)입니다.
보다 강력한 변수에서 제대로 획득되지 않은 변수를 예측하는 몇 가지 다른 방법을 비교해 보겠습니다. 이 예에서 우리는 이 특정 유정( 엘버트 산 우물, 노스 슬로프, AK ). 우리가 가지고 있는 것은 Gamma Ray, Formation Density, Compression Velocity 및 Shear Velocity의 4가지 변수의 완전한 세트입니다. 지하에는 3개의 수화물 함유 모래 구간이 있으며 첫 번째 구간(켈리 부싱 아래 2003-2064피트, ftkb)을 사용하여 아래쪽 2개 구간인 2065-2127ftkb 및 2128-2128-에서 수화물 포화도를 예측하려고 합니다. 각각 2206ftkb. 표준 최소 제곱, 일반화 회귀, 신경망 및 XGBoost와 같은 다양한 예측 모델을 테스트합니다. 우리는 R2 값을 모델 품질의 첫 번째 패스로 사용하지만 각 모델의 전체 품질을 평가하기 위해 실제 대 예측 웰 로그를 정성적으로 평가합니다.
결과
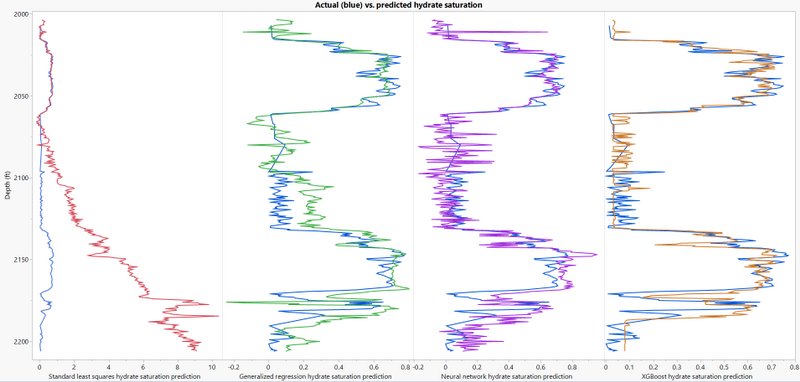 Standard Least Squares(빨간색), Generalized Regression(녹색), Neural Network(보라색) 및 XGBoost(주황색)에 대한 예측된 수화물 포화도와 비교한 실제 수화물 포화도(파란색).
Standard Least Squares는 그것을 자르지 않습니다. 간격 1을 강력하게 모델링하지만 더 낮은 두 간격에서 탄화수소 포화도를 정확하게 예측하는 데 완전히 실패합니다. 일반화 회귀(Adaptive; Elastic Net)가 약간 더 낫지만 일반적으로 하위 두 구간을 0.1~0.2 포화 단위만큼 과대 예측합니다. 기계 학습 모델은 훨씬 더 강력한 작업을 수행하지만 XGBoost에 우위를 제공합니다. Neural Network는 예측의 10-20%를 차지하는 수많은 킥이 있다는 점에서 훨씬 "잡음이 많은" 신호를 생성하는 반면 XGBoost는 탄화수소 포화도가 낮거나 높을 때 훨씬 더 안정적인 예측을 제공합니다.
이것은 지질 및/또는 다운홀 데이터로 작업할 때 관찰하는 일반적인 주제입니다. 자연 시스템은 엄청나게 복잡하고 이질성이 가득하며 기계 학습 모델(Bootstrap Forest, Neural Network, XGBoost 등)은 더 나은 예측을 제공하는 경향이 있습니다. 전체적으로 모델.

 XGBoost(상단) 및 신경망(하단)의 검증 데이터 세트에 대한 모델 결과.
앞으로 나아가 다
업계에서 일하는 대부분의 사람들은 하나의 유정보다 훨씬 더 많은 데이터를 손쉽게 사용할 수 있습니다. 강력한 방법은 클러스터링을 사용하여 지질학적 매개변수(암석, 다공성, 투과성 등)를 사용하여 우물을 함께 그룹화하고 클러스터별로 예측 모델을 구성하는 것입니다. 이 방법을 사용하면 모델이 특정 플레이 또는 특정 플레이 내의 특정 유역을 위해 특별히 제작되었기 때문에 더 나은 결과를 얻을 수 있습니다. 그 외에도 그래프 빌더에서 데이터를 시각적으로 살펴보는 것이 좋습니다. 개별 매개변수에서 진행 중인 상황을 파악하여 최상의 경로를 식별하는 것입니다.
마지막으로, 조직에서 데이터 분석의 민주화를 통해 더 큰 목표를 더 빨리 달성할 수 있을 것입니다. 사용자의 손에 강력한 도구를 제공하고, 모델을 구축하고 해석하는 방법을 보여주고, 편안히 앉아서 즐기십시오!
데이터 소스
이 데이터는 수집되었습니다 미국 지질 조사국(USGS) 및 여러 대학 및 산업 파트너와 협력하여 DOE와 BP 탐사 알래스카(BPXA) 간의 협력 계약 시추를 통해 알래스카 노스 슬로프의 천연 가스 하이드레이트가 기술적으로 또는 상업적으로. Mt. Elbert 유정은 2007년에 시추되었으며 데이터는 다음을 통해 제공됩니다. 라몬트 도허티 지구 천문대 컬럼비아 대학교에서. 데이터의 하위 집합을 지정하고 정리한 다음 의 JMP 테이블에서 사용할 수 있도록 했습니다. JMP 공개 (참고: 없이 JMP 프로 , GenReg, Neural w/ KFold 및 XGBoost 스크립트는 실행되지 않습니다. 또한 XGBoost 스크립트에는 JMP Pro 및 XGBoost 추가 기능 ).
유익하고 철저하게 작성된 게시물에 감사드립니다! 글쎄, 나는 또한 각각의 작업에 JMP Pro를 사용하여 화학을 다루고 있습니다.
제 질문은 신경망(NN)에 관한 것입니다. 회귀 사례에 대한 JMP의 경우 고정된 랜덤 시드에서도 동일한 모델을 다시 시작하면 NN에 의한 예측 값이 모든 메트릭(RMSE, R2 등)에 따라 다릅니다. 분류의 경우 메트릭을 유지 관리하는 모든 것이 반복 가능합니다. 동일한 조건을 유지하면서 NN 모델을 다시 정렬하는 게임을 했는가?
감사 해요!
남자 이름
질문 너무 감사합니다 @나자르코프스키 , 이것은 당신이 제기한 매우 중요한 주제입니다. 저자가 NN을 사용하여 매우 강력한 상관 관계를 발견했지만 다른 사용자가 동일한 데이터에서 동일한 NN을 실행했지만 다른 무작위 시작을 사용하면 상관 관계가 크게 낮아졌기 때문에 획기적인 연구가 철회된 경우를 보았습니다. 여기에서 앙상블 모델이 실제로 도움이 될 수 있습니다(예: Bootstrap Forest, Boosted NN 등). 이 모든 것을 말하고 이것을 하는 것의 중요성을 강조하면서 나는 이것을 원래 하지 않았다는 것을 인정해야 합니다. 그러나 나는 스스로를 도울 수 없었고 귀하의 의견을 읽은 후 돌아가서 다른 임의의 시드로 동일한 설정을 사용하여 일련의 NN을 다시 실행했습니다. 평균 유효성 검사 세트 R^2는 0.92 +/- 0.01로 내가 원래 발견한 것보다 약간 낮습니다.
좋은 일이야, 피터! 그리고 RMSE가 어땠는지 알려주세요. 회귀의 경우 RMSE가 주요 KPI이기 때문입니다. 바라건대, 이 매개변수는 크게 변경되지 않습니다. 이제 JMP Pro에서 앙상블을 만드는 방법을 알려주세요. 내 것은 15.0이고 앙상블은 15 버전에서 만나지 않기 때문에 당신의 것은 16이 될 수 있습니다. 나는 당신에게 매우 감사 할 것입니다!
Michael, 6개의 임의 시작에 대한 이 특정 데이터 세트 변경에 대한 제곱 평균 제곱 오차(JMP NN 보고서의 두 번째 적합도 측정)는 ~0.01로 매우 작은 차이를 보입니다. 앙상블 모델의 경우 JMP Pro에서 Bootstrap 포리스트를 사용하거나 다음을 사용할 수 있습니다. 부스팅 NN 또는 의사 결정 트리에서 이러한 모든 기능은 JMP 15 Pro에서 사용할 수 있습니다. 이게 도움이 되길 바란다!
축하합니다, 친애하는 동료! 당신은 훌륭한 일을 수행했습니다. 그리고 앙상블 모델에 대한 접근 방식에 대한 조언을 부탁드립니다. 좋은 주말 보내세요!
감사합니다,
남자 이름

