当我在中西部(准确地说是密苏里州哥伦比亚)长大时,调味薯片是我的最爱。 虽然我更喜欢酸奶油和洋葱,但烧烤会在紧要关头做。 想象一下,当我的同事 Ryan Lekivetz 告诉我,我们北方的邻居有一系列全新的薯片口味可供尝试时,我会多么高兴!
想象一下,当我发现两种最受欢迎的口味是番茄酱和莳萝泡菜时,我的失望。
“Blech,”我告诉瑞恩。
“你这么说只是因为名字,”他回答道。
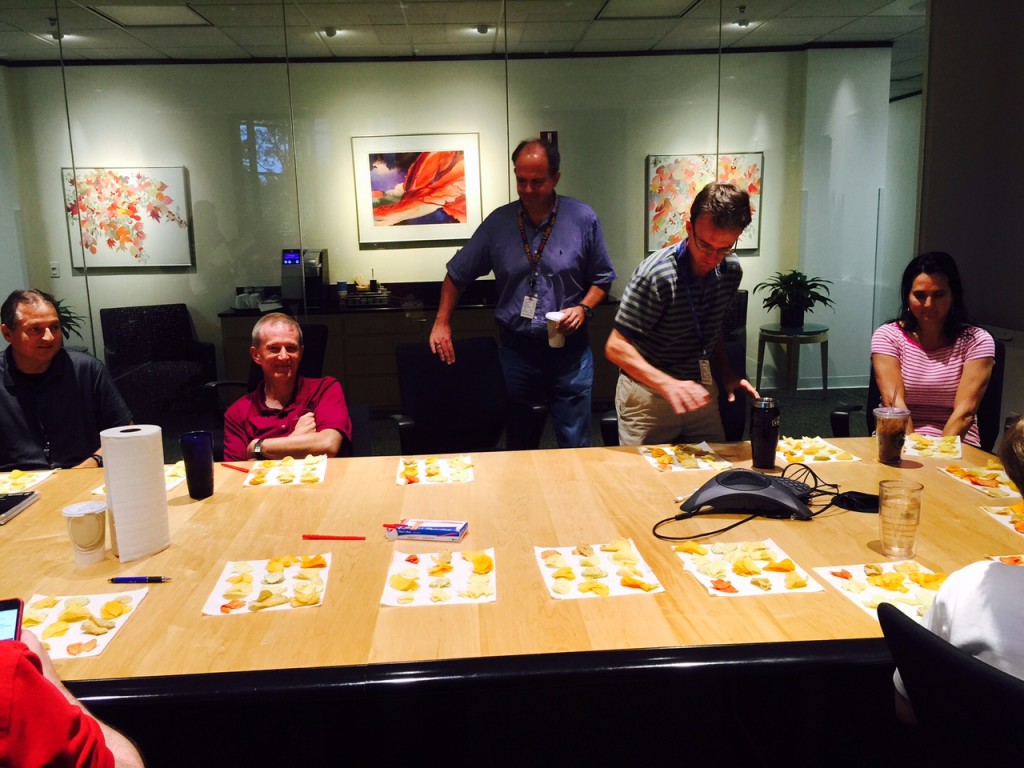
在我们的选择实验中,JMP 工作人员自愿品尝了 10 种不同口味的薯片。
因此,正如统计学家所说,我们同意根据设计实验.
我们选择了 10 种薯片口味,包括加拿大莳萝泡菜和加拿大番茄酱,并请人们进行比较。 因为我们与来自美国的志愿者一起工作,所以我们决定混合一些美国的最爱,比如烧烤和我心爱的酸奶油和洋葱,但我们也会使用乐事给我们调味薯条,看看加拿大薯条如何与其他不熟悉的口味相抗衡。 最后,我们为志愿者品尝了 10 种不同类型的薯片:
纽约鲁本南方饼干和肉汁西海岸松露薯条希腊城陀螺番茄酱全部穿着莳萝泡菜南方热火烧烤烧烤酸奶油和洋葱就像与巧克力大减价,我们觉得让人们品尝 10 块薯片并按最佳到最差排序太难了。 相反,我们需要一个设计好的实验,将 10 个芯片分成可管理的组。 这里的转折是,我们不仅会要求每个组中的“最佳”或“最喜欢”,而且还会要求每个组中的“最差”或“最不喜欢”。 这将允许我们执行最大差异(或最大差异分析),另一种类型选择分析这将使我们能够从每个选择任务中获得更多信息。
Ryan 在他的博客文章中解释了他是如何开发实验设计的:薯片重击:美国与加拿大. Ryan 的设计给了我们四组薯片,每组有三片薯片可供品尝。 和以前一样,有三个不同的调查,给了我们更多的比较总数。 我们召集了 30 名志愿者进行品尝(这比我们上次让志愿者品尝巧克力的实验花费了更多的哄骗性)。 然后,是时候分析了。
分析
可以分析 MaxDiff 模型,就好像受访者做出两个选择一样。 首先,他们选择提供的最佳选择。 其次,他们选择最差的。 每一个都被视为一个单独的选择。 然后,每个受访者为他或她展示的每组筹码做出两个选择。 在数据中,我们用每个选择集的两组条目来表示这一点:
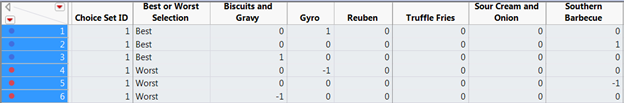
如果我们关注选择集 ID 1,我们会看到三行是最佳选择,三行是最差选择。 我们用指标变量来告诉JMP哪些筹码在集合中。 对于代表最佳选择的行,指标用 1 编码。 对于代表最差选择的行,指标用 -1 编码。 每个指标列在选择模型中作为连续变量输入,因此 JMP 被迫使与“最差选择”行关联的参数等于与“最佳选择”行关联的参数的负值。
在模型对话框中,我们确保将“Best or Worst Selection”列(告知行是与最佳选择还是最差选择相关联的列)添加到分组列中:
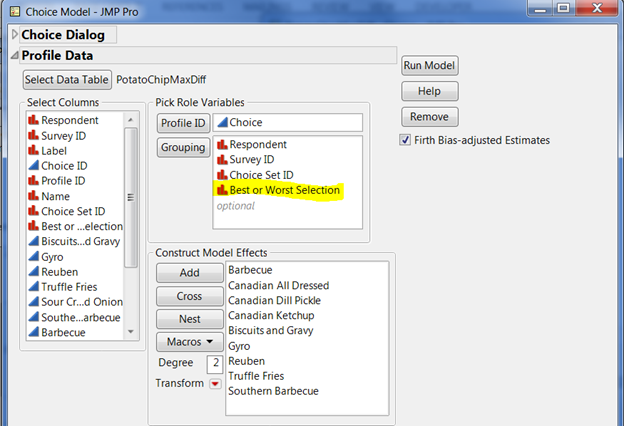
我们还必须选择一种风味作为比较风味,并将其指标排除在模型之外(就像使用任何一组虚拟编码列一样)。 在这种情况下,我比较了酸奶油和洋葱。
为了获得从最佳风味到最差风味的排名,我对生成的报告进行了排序(右键单击并选择“按列排序”)。 烧烤和南方烧烤接近顶部。 似然比检验是测试参数是否与 0 显着不同,因此在这种情况下,风味是否与酸奶油和洋葱显着不同。 看起来这两种熟悉的烧烤口味是最受欢迎的,而 Gyro 绝对落后于其他口味。
可视化结果
我还创建了一个结果图(右键单击估计表并选择“制作成数据表”。 然后我打开 Graph Builder 并按照步骤操作在这篇博文中描述.

如果我们只使用图表,松露薯条是仅次于烧烤口味的第二受欢迎的口味,其次是饼干和肉汁。 加拿大风味接近底部,但统计测试告诉我们,如果我们对不同的人(或同一个人在不同的一天)进行抽样,这些风味可能会排序更高。
那么,谁是对的?
也许我们俩都是对的。 也许我只是对“番茄酱片”这个名字做出反应。也许如果我在盲测中品尝其中一种,我会像酸奶油和洋葱一样喜欢它们。 也许如果我在加拿大长大,我会比烧烤更喜欢它们。
不过,如果 Gyro 赢得了“做我们的味道“ 挑战。
