主成分分析(PCA) 是数据分析中的一种传统方法,更具体地说,是多变量分析中的一种传统方法。PCA由Karl Pearson在1901年开发。
PCA的目标是将一组相关变量的维数减少为较小的一组不相关变量,这些变量解释了原始变量的大部分变化。当在一组预测变量中探索相关结构以及在预测模型或主成分回归(PCR)中将主成分用作回归模型中的预测因子时,这是一种有用的技术。
这是一个简单的示例:让我们考虑一下有关汽车的数据集概率分析和统计 。
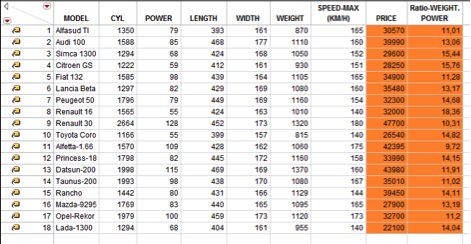
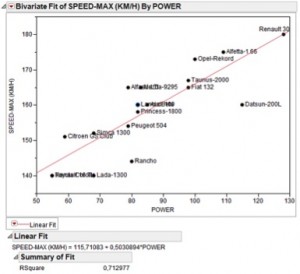
数据集有18行,其中有8个数字列。我们可以研究变量对之间的关系。例如,最大速度与功率相关。
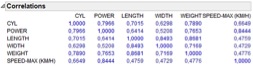
但是,由于存在大量变量,使用相关矩阵总结成对关系更加方便,并且我们观察到大量正相关。我们还看到,最大速度与气缸和功率之间的相关性最强。
由于这组变量中的相关结构,我们可以期望使用PCA减少维数。

我们看到关于第二部分有两个不同的组。一组与汽车的尺寸特征(长度,宽度,重量)有关,第二组与电动机的特征(功率,最大速度,汽缸)有关。
说明性变量
说明性变量对新组件的构造没有影响。它们用于帮助解释组件并将它们与其他变量关联(在这种情况下,是价格和重量功率比)。
您可以下载具有说明性变量的PCA的JMP加载项从JMP文件交换。(下载需要免费的SAS配置文件。)
此加载项将使您可以向PCA添加说明性变量。
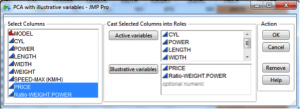
使用前面的示例,具有说明性变量的PCA允许我们可视化价格和权重比(以前数据集中的橙色变量)与主成分之间的关系,而无需使用这些其他变量来构建PCA。

我们可以看到,价格显然与所有变量相关,并与气缸数量,功率和最大速度分组。因此,昂贵的汽车是大型汽车还是功能强大的汽车。
第二示例性变量,即重量与功率之比,就两个分量而言,与汽车的动力呈负相关,而与第一分量有关,则与重量负相关。显然,由于重量会对汽车的动力产生负面影响。
参考文献
G. SAPORTA,《概率论,统计分析》,TECHNIP,2006年(法文)。
丹·奥伯米勒写道:
乔尔
您问题的最佳答案可能是使用变量聚类( http://blogs.sas.com/content/jmp/2013/03/13/variable-clustering-in-jmp/ )。但是,这是JMP Pro功能。
通过一些努力和主观意见,您可以使用PCA的负荷图(带有代表每个变量的光线的图)来减少要测量的变量数量。指向大致相同方向的所有光线彼此高度相关。因此,您可以只使用“集合”中的一个来表示该集合中的所有变量。此方法应有助于您减少需要执行的测试的数量。
艾尼斯·奈尔(Anish Nair) 写道:
夫人,您是否知道如何从主要组成部分中找到责任比例???
迈克·克莱顿写道:
非常感谢。您可能会发现更多的想法,包括此重要领域早期软件所做的一些数据集。化学计量和控制系统的人们传统上使用Matlab,并且有一个Matlab PLS工具箱,该工具箱可与PCA一起使用,以处理许多更复杂的多元问题。Eigenvector研究团队在多年前在Sematech教授了MV方法,当时JMP中唯一的工具是Spin Plot及其子例程。他们使用了一些采石场数据集,向我们展示了如何在JMP中使用该功能,尽管受到了限制。多年以来,另一位多变量监控领导者是Svante Wold,他创立了Umetrics。有人告诉我,PCA与PLS结合使用(可以表示偏最小二乘法或项目潜在结构)可以用于MV SPC监控(但是,没有任何个人经验)。
乔尔·多布森写道:
假设我有一个带有1000个数据记录的半导体测试程序。每个数据记录都是IC芯片上的一些电气测量值,并且是连续变量。例如,每个数据记录都可以是电阻,电流,电容,电感或电压。
每个芯片上测得的许多相同类型的电压可能对应于类似设计但尺寸不同的晶体管。这些多个读数之间通常可能具有广泛的多重共线性。例如,阈值电压固有地与驱动电流有关,而驱动电流与泄漏电流有关。
我的目标是看是否可以通过仅测量几个解释大多数变化的数据记录参数来减少测试时间,并停止测量与我一直阅读的数据高度多共线性的参数。
我曾想过按照您的建议使用PCA来降低维数,但是每个PC特征向量都是所有数据记录参数的线性组合。因此,尽管迁移到前几台PC确实减少了问题的范围,但并没有减少我的测试时间。您能帮我弄清楚如何使用JMP 10做我想做的事情吗?(我没有JMP Pro。)
问候,乔尔·多布森
