하위 범주/반복 측정 분석에 대한 평균 분리(Tukey 절차)를 수행하는 방법은 무엇입니까?내 데이터에 대해 반복 측정 분석(혼합 모델)을 수행했습니다. [3개 그룹(대조군, 1mM 처리, 2mM 처리)이 있고 각 그룹에는 2개의 복제(R1 및 R2)가 있으며 4개 시점(0d)에서 측정합니다. ,1d, 3d,5d). 각 복제에는 6개의 샘플(서브샘플링)이 있으며 모든 시점(반복 측정)에 대해 동일한 샘플 사용]. ( 첨부된 파일 )
------------------------------------- ------------------------------------------------
제가 분석을 수행하는 방법은 다음과 같습니다.
분석 > 전나무 모델
EG1~Y
그룹, 담당자, 시간이 구성 모델에 추가됨
그 다음에, Rep(Group) & Random(속성을 Random 효과로 변경)
방법: REML
달리다!
------------------------------------- ------------------------------------------------
결과 출력은 다음과 같습니다.


아래와 같은 그래프를 그려 각 시점의 유의차를 표시하고 싶은데요?

각 시점에 대한 평균 분리를 개별적으로 얻고 그래프에 표시하고 싶습니까?
시간"0": Control /1mm/2mM의 평균 분리는 무엇입니까
시간 "1": 등.
그리고 어떻게 지냈는지 말해주세요 JMP에서 이 그래프를 생성하세요 그리고 각 시점에 대한 별도의 분리를 의미합니다. ?
당신의 친절한 지원에 감사드립니다
Re: 하위 범주에 대한 평균 분리(Tukey 절차)를 수행하는 방법/반복 측정 분석감사합니다 @케빈_앤더슨 그리고 @Bill_Worley 시간을 내어 나를 도와주세요.
@케빈_앤더슨
당신이 지적했듯이,

첨부하신 파일에서는 해당 내용을 찾을 수 없습니다. 내 파일은 아래 이미지와 같습니다.

통계학자로부터 각 시점마다 6개의 샘플을 채취하므로 Rep*Time(Group)&Random을 포함해야 한다는 말을 들었습니다. 그것은 실제로 내 실험 오류 용어입니다.내가 원하는 분석을 하려면 그룹과 시간 간의 상호 작용을 포함해야 합니다. 이러한 방식으로 Tukey 비교를 수행하는 것은 12개의 그룹 및 시간 조합을 모두 선택하기 때문에 압도적일 것입니다. JMP에서 이 문제를 해결하는 유일한 방법은 직접 스크립트를 작성하는 것입니다.
불행하게도 나는 이 프로그래밍의 전문가가 아닙니다. 이 단계를 수행하는 데 도움을 주시면 감사하겠습니다.
대부분의 실험이 이와 같기 때문에 JMP 분석을 수행하는 데 매우 유용할 것입니다.
감사합니다!
Re: 하위 범주에 대한 평균 분리(Tukey 절차)를 수행하는 방법/반복 측정 분석안녕, 킨다!
첨부한 데이터 세트를 가져와서 여기에 몇 가지 스크립트를 추가했습니다.
첫 번째는 반복된 반복 측정 실험으로 데이터를 분석합니다.경고 : 나는 이러한 데이터를 수집하기 위해 실행한 설계, 데이터 수집 방법 또는 기본적으로 실험에 관한 모든 것에 대해 거의 아무것도 모릅니다.모델이 잘 수렴하지 않고 이에 대한 경고가 표시됩니다.
분석 창의 Fit Mixed 헤더 옆에 있는 Little Inverted Red Triangle(LIRT) 아래에서 모델 대화 상자를 선택하면 모델 설정 방법을 검토할 수 있습니다.
분석을 살펴보고 다중 비교에서 결과를 찾습니다.

분위수와 조정된 DF를 확인하세요.
새 데이터 테이블에 다음 수식을 입력합니다.

...이것이 이상한 신뢰구간 숫자(0.9888777717)를 얻은 방법입니다.
분석 창에서는 쌍별 차이(Pairwise Differences)를 제공합니다. 이것이 바로 "평균 분리"라고 부르는 것입니다.
두 번째 스크립트를 실행하면 그래프가 표시됩니다.

스크립트를 마우스 오른쪽 버튼으로 클릭하고 편집하면 포인트 앤 클릭 인터페이스를 통해 분석을 수행하기 위한 플랫폼 및 설정과 그래프를 검토할 수 있습니다.
행운을 빌어요!
Re: 하위 범주에 대한 평균 분리(Tukey 절차)를 수행하는 방법/반복 측정 분석안녕 킨다,
나는 당신이 요청한 것을 빠르고 쉽게 수행할 수 있는 방법을 생각해낼 수 없습니다.ANOVA를 실행한 다음 연결된 문자 보고서를 마우스 오른쪽 버튼으로 클릭하고 데이터 테이블로 만들기를 클릭하거나 클릭을 제어하고 결합된 데이터 테이블 만들기를 선택할 수 있습니다.그런 다음 서로 다른 문자 열을 결합하여 데이터를 조금 더 뒤섞어야 하지만 여전히 사용자가 원하거나 확인해야 하는 모든 것을 제공하거나 얻을 수는 없습니다.
시도해 볼 수 있는 또 다른 옵션은 Fit Model을 사용하여 EG1을 예측하는 모델을 구축한 다음 상단의 반응에 따라 빨간색 핫스팟을 클릭하는 것입니다.여기에서 추정 > 다중 비교로 이동합니다.이 옵션에서 Tukey 쌍별 비교를 수행하려는 요소를 선택할 수 있지만 연결 문자 보고서는 얻지 못합니다.
어쩌면 누군가가 당신을 위해 더 나은 솔루션을 가지고 있을 수도 있습니다.
최상의,
청구서
Re: 하위 범주에 대한 평균 분리(Tukey 절차)를 수행하는 방법/반복 측정 분석매우 감사합니다 @Bill_Worley 그 단계는 많은 도움이 됩니다.
제 영어가 당신을 혼란스럽게 만들었다면 죄송합니다.
나의 관심은 다음을 수행하는 것입니다. Tukey 테스트(다중 비교/ 이별을 의미함) 각 시점에 대해 JMP로 개별적으로 그래프에 표시합니다.
아래 막대 차트에 표시된 것처럼 각 시점에서 각 막대 사이의 중요한 차이를 표시하고 싶습니다.
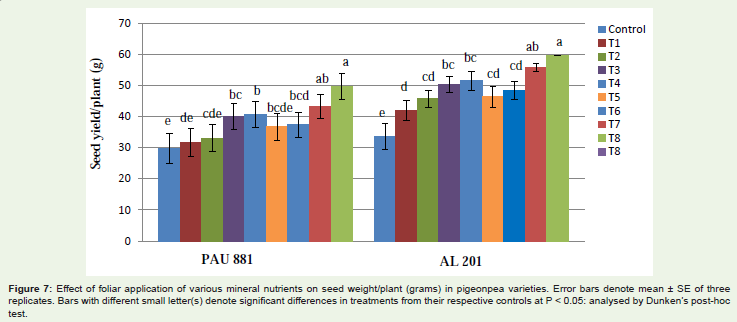
이미지 출처
이를 위해 각 시점에 대한 연결 편지 보고서를 받아야 합니다(예: 아래 이미지).

이미지 출처
따라서 정확한 질문은 반복 측정 분석(혼합 모형) ANOVA를 수행한 후(이 질문에 대해 내 데이터가 정규 분포라고 가정)입니다. JMP에서 다양한 시점에 대해 다중 비교를 어떻게 수행할 수 있습니까?
JMP에서 이것이 가능합니까?
이 작업을 수행하면 다른 시점이 아닌 전체적으로 평균 분리가 발생합니다.
그 사람을 도와주세요.
감사합니다.
Re: 하위 범주에 대한 평균 분리(Tukey 절차)를 수행하는 방법/반복 측정 분석데이터가 준비되면 창 상단에 있는 막대 아이콘을 선택해야 한다는 점을 추가하는 것을 잊어버렸습니다. 선택해야 하는 아이콘은 이미지 상단에 파란색으로 강조 표시되어 있습니다.Re: 하위 범주에 대한 평균 분리(Tukey 절차)를 수행하는 방법/반복 측정 분석안녕 킨다,
그래프 빌더에서 제가 만든 그래프는 실제로 데이터를 드래그하는 데 불과합니다.귀하의 데이터는 스택에 잘 설정되어 있습니다.EG1을 Y축으로 드래그하고 Time을 X축으로 드래그합니다.Group을 오른쪽의 Color by로 드래그한 후, Group을 오른쪽의 Overlay로 드래그하세요.
설정 제어 창 왼쪽의 막대 아래에는 막대 스타일, 요약 및 오류 막대별로 보기를 변경할 수 있는 곳이 있습니다.아래 표시된 그래프에서는 병렬, 자동, 평균, 표준 편차 및 변수별 레이블을 선택했습니다.

도움이 되었기를 바랍니다.
청구서
Re: 하위 범주에 대한 평균 분리(Tukey 절차)를 수행하는 방법/반복 측정 분석감사합니다 @Bill_Worley 감사합니다.
JMP를 통해 각 시점에 대한 평균 분리(Tukey 테스트)를 개별적으로 얻고 그래프에 표시하고 싶습니다.
시간"0": Control /1mm/2mM의 평균 분리는 무엇입니까
시간 "1": 등.
그리고 어떻게 지냈는지 말해주세요 JMP에서 이 그래프를 생성하세요 그리고 각 시점에 대한 별도의 분리를 의미합니다. ?
Re: 하위 범주에 대한 평균 분리(Tukey 절차)를 수행하는 방법/반복 측정 분석안녕하세요,
Graph Builder에서 아래 그래프를 만들었습니다.색상은 필요에 따라 또는 원하는 대로 변경할 수 있습니다.

