NRF 조사는 사람들이 할로윈을 위해 개를 입힐 것을 요청했습니다. Batman과 Superman이 응답 목록을 작성했습니다. (사진 제공 : Kerrie Merullo Wilson)
모퉁이를 돌면 바로 할로윈을 입고 어떤 의상을 입을 지 결정해야합니다.
National Retail Federation은 조사를 실시하여 올해 인기있는 의상들 , 나는 그것을 탐험하고 시각화하는 것이 재미있을 것이라고 생각했다. 설문 조사 결과 .
설문 조사에서는 세 가지 질문을했습니다.
올해 할로윈을위한 의상은 무엇입니까?할로윈의 경우 자녀에게 어떤 복장을합니까?당신은 할로윈을 위해 당신의 애완용 옷을 어떻게 꾸밀 것입니까?데이터를 JMP , 나는 데이터가 약간의 정리가 필요하다는 것을 알았다.
다행히 JMP 12는 새로 설계된 Recode 기능 이렇게하면 데이터를보다 효율적으로 정리할 수 있습니다.
처음에는 가져온 데이터가 다음과 같이 보입니다.
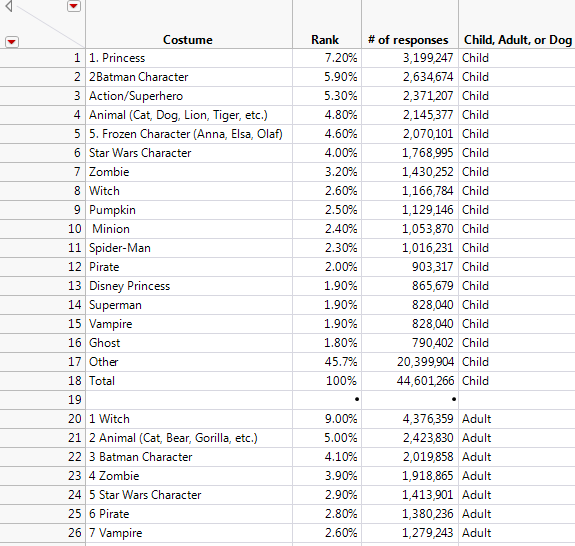
복장 열에 원하지 않는 숫자, 공백 및 데이터 표에 누락 된 값이 있음을 유의하십시오.
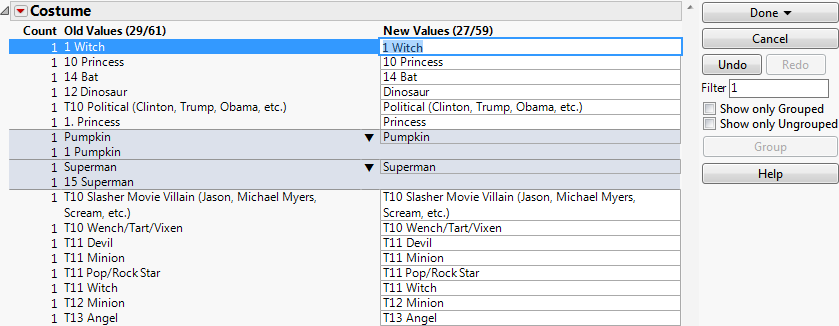
추가 문자를 강조 표시하고 강조 표시하여 의상 열을 다시 기록했습니다. Cols> Recode . 빨간색 삼각형 메뉴의 공백 자르기 옵션을 사용하여 각 값 앞뒤의 공백을 제거했습니다.
필터 검색 표시 줄을 사용하여 레코딩 된 데이터 테이블에 포함하지 않으려는 숫자를 검색했습니다. 검색 창에 "1"을 입력하면 "1"이 포함 된 모든 값이 맨 위에 그룹화됩니다. 새 값 열에서 원하지 않는 문자를 삭제하면 이전 값과 새 값이 그룹화되어 음영으로 표시됩니다. 많은 데이터로 작업 할 때 그룹화 / 그룹 해제 만 표시 확인란을 사용하여 내보기를 제어합니다.
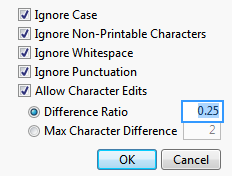
Group Similar Values red-triangle 메뉴 옵션은 특히 일관성을 검사 할 때 데이터를 정리하고 정리할 수있는 좋은 방법입니다. 이 데이터 테이블에는 여러 번 나타나는 값이 있지만 간격이나 문자가 다릅니다 (예 : "Batman"및 "Bat man"). 나는 그 가치들을 찾아 내고 그것들을 재 코딩하여 그들이 테이블 전체에 걸쳐 일관되게하고 싶었다. 차이 비율 및 최대 문자 차이 옵션은 자동으로 두 개의 문자로 다른 값을 그룹화합니다 (설정에 따라 다름). 이렇게하면 실수 나 불일치를 쉽게 찾을 수 있습니다. 나는 기본 차이 비율 값을 .25로 유지했는데, 최대 25 % 차이가있는 그룹화 된 값, 즉 최소 75 % 문자 일치 값이 함께 그룹화되었습니다.
다음은 유사한 값을 그룹화 한 후의 데이터 모습입니다.
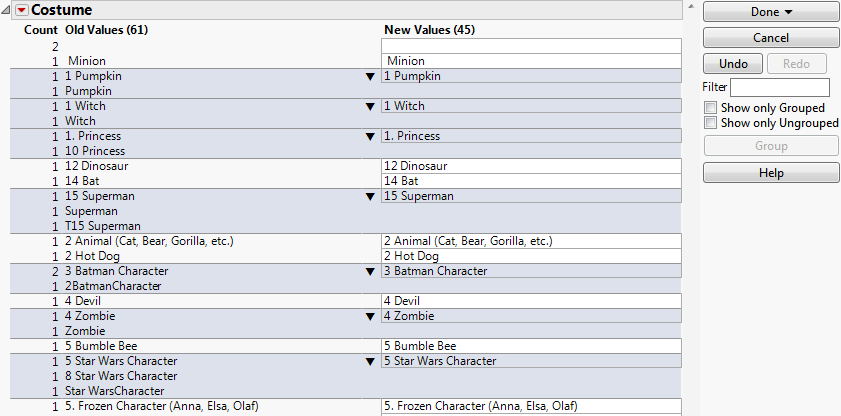
이제 그룹화 된 유사한 값을 쉽게 볼 수 있습니다. 주어진 값의 모든 인스턴스가 동일하게 보이도록 각 그룹을 편집했습니다. 예를 들어, "Star Wars Character"그룹의 새 값을 변경하여 세 인스턴스 각각이 동일한 간격을 갖도록했습니다. 적절한 변경을 한 후, 완료> 자리에 있음 . 이렇게하면 새 값 열의 값이 데이터 테이블의 이전 값을 대체합니다. 원래 데이터를 유지하려면 Recode에서 변경 한 내용을 새 열에 저장하려면 완료> 새 열 또는 수식 열 .
데이터는 다음과 같습니다. 그래프 빌더 복장을 %로 분석했을 때 :
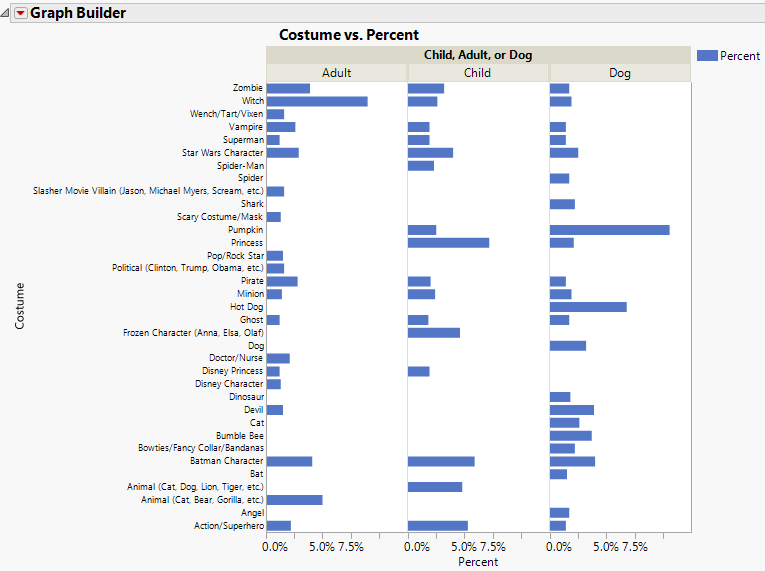
"기타"가 포함 된 행은 제외되고 숨겨졌습니다.
또한 위의 그림은 복잡하고 분석하기가 어렵습니다. 복장을 다시 범주화하여 데이터의 패턴을 쉽게 찾을 수 있도록 복장을 다시 작성했습니다. 의상 열이 들어가면 레코딩 그룹화 할 값을 선택하고 오른쪽 클릭 옵션을 사용했습니다. 그룹 . 많은 동물 의상이 있기 때문에, 나는 그들을 그룹화하고 "동물"카테고리를 만들었습니다.

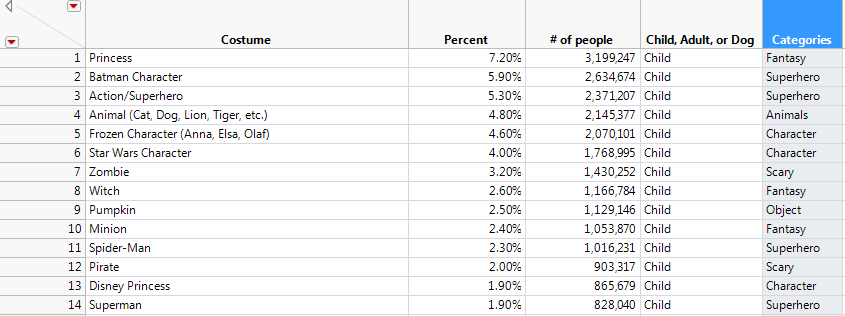
"동물 (고양이, 개, 사자, 호랑이 등)"아래의 모든 동물을 그룹화 한 후에 카테고리의 이름을 "동물"로 단축했습니다. 나는 "Superhero", "Fantasy", "Scary"등과 같은 카테고리로 남은 복장을 그룹화했다. 레코딩 후, 나는 완료> 수식 열 내 원래 의상 열을 보존합니다. 새 열의 이름을 "Categories"로 지정했습니다. 열 머리글을 두 번 클릭하여 수식을 볼 수 있습니다.
다음은 Categories 열의 표와 같습니다.
분석
이제는 의상이 범주로 분류되어 Graph Builder는 더 해석하기 쉬운 음모를 제공합니다. 그래프 빌더에서는 X 변수에 백분율 열을 사용하고 Y 변수에 범주를 사용했습니다. 나는 어린이, 성인 및 개에 의해 데이터를 그룹화하고 대중적으로 주문했습니다. 결과는 다음과 같습니다.
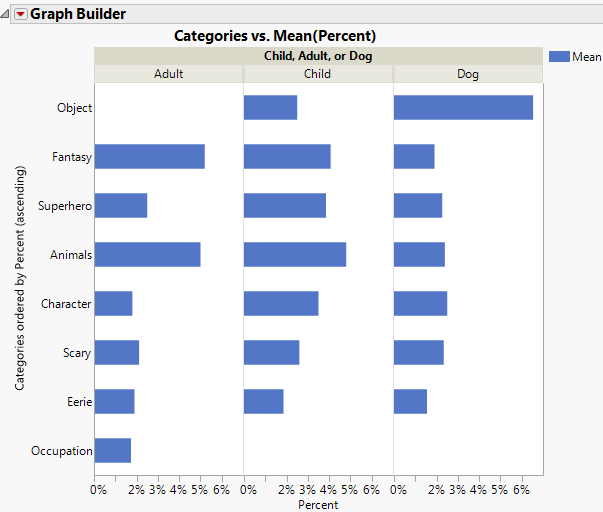
위의 그래프는 각 그룹 (성인, 어린이, 개)에 대한 카테고리 별 복장 선택 비율을 보여줍니다. 어떤 코스튬 카테고리가 성인, 어린이, 개 중에서 가장 큰 히트인지 확인할 수 있습니다. 판타지 카테고리는 성인에게 가장 인기가 많았고, 어린이 카테고리는 동물 카테고리 였고, 개는 객체 카테고리였습니다.
데이터를 더 자세히 분석하기 위해 Local Data Filter를 사용하여 성인용 코스튬 선택 만 살펴 보았습니다. 다음은 어른별로 필터링되고 인기별로 정렬 된 데이터입니다.
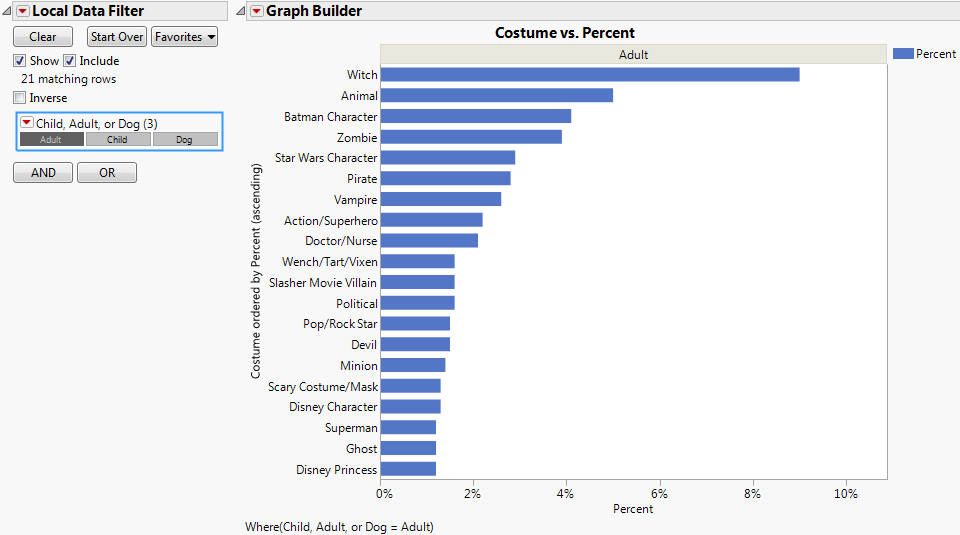
마녀 복장은 올해 성인들에게 가장 인기가 있습니다.
이제 특정 의상이 어린이와 성인에게 가장 인기가 있는지 살펴 보겠습니다. 다시 Graph Builder를 사용하여 특정 의상을 선택한 사람들의 비율을 분석했습니다. 데이터에는 개의상의 개수가 포함되지 않았기 때문에 분석을 실행하기 전에 "성인"과 "아동"만 포함하는 그룹이라는 새 열을 만들었습니다. Dog 행의 항목에 값이 누락되었습니다. 결과를 설명하기 위해 모자이크 플롯이 있습니다.
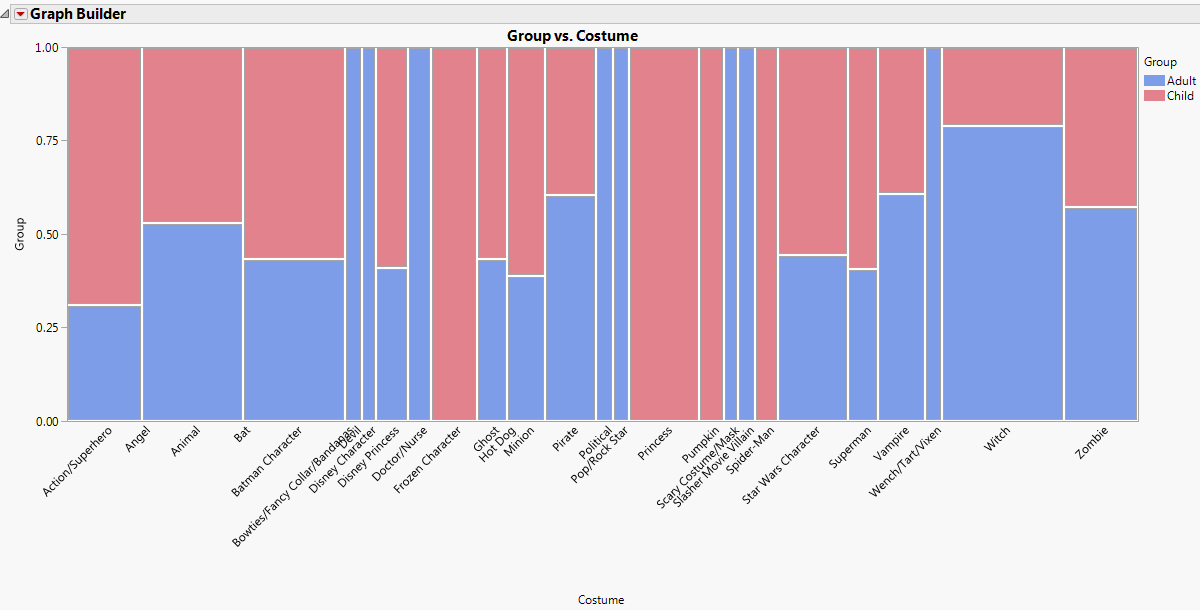
수직축은 복장 열의 어느 비율이 어린이 또는 성인 그룹에 속하는지를 나타냅니다. 각 막대의 전체 크기는 어린이와 성인 모두에게 인기있는 의상을 나타냅니다. 그래프는 마녀 복장을 선택한 사람들의 약 75 %가 어른 이었다는 것을 보여줍니다. 동물 복장을 선택한 사람들의 약 절반은 어른이었고 나머지 절반은 아이들이었다. Princess와 같은 일부 의상 그룹은 한 그룹에 의해 완전히 지배됩니다. 이 경우, 아이들은 공주를 의상으로 선택한 사람들의 전체 비율을 구성합니다.
추가 재미를 위해서 필자는 X 축으로 맞추기 (Fit Y by X) 플랫폼을 사용하여 카테고리별로 데이터를 그룹화하여 다른 모자이크 플롯을 만들었습니다. 플롯의 모양은 다음과 같습니다.
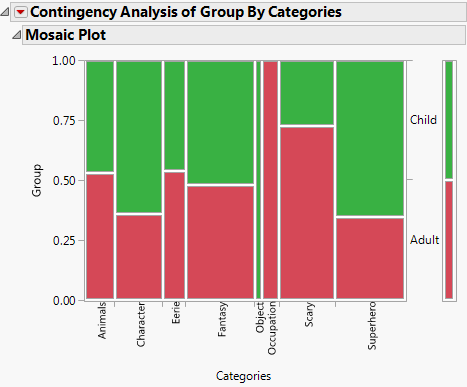
나는 아이들 만이 오브제 부문의 의상을 선택했고 성인 만이 직업 범주의 의상을 선택했다. 전반적인 바 크기를 비교할 때 Fantasy, Scary 및 Superhero는 성인과 어린이 모두에게 가장 인기있는 카테고리입니다. 이전에 언급 한 막대 그래프 중 하나에서 동일한 결과를 볼 수 있지만 모자이크 플롯 (위)을 사용하면 두 그룹에서의 의상 인기를 더 쉽게 비교할 수 있습니다.
나는 모두가 재미 있고 안전한 할로윈이되기를 바랍니다! 마녀를 찾으십시오 - 분명히 우리는 올해 많은 것을 볼 수 있습니다!
할로윈을 위해 당신은 무엇을 할 것입니까?
로버트 페리 쓴 :
훌륭한 기사! 나는 직업과 무서운 범주가 겹칠 것이라고 생각하고있다.
