NRFの調査では、ハロウィーンに関してどのような人々が自分の犬を着飾るのか尋ねた。BatmanとSupermanが回答のリストを作りました。(写真提供:Kerrie Merullo Wilson)
ハロウィーンが間近に迫っているので、今度はどんな衣装を着るかを決める時が来ました。
全国小売連盟はそれを見つけるために調査を行いました今年人気の衣装そして、私はそれを探索し視覚化するのは楽しいだろうと思いましたその調査結果 。
調査は3つの質問をしました:
今年のハロウィンのコスチュームは?あなたの子供はハロウィーンのために何をドレスアップしますか?あなたはハロウィーンのためにあなたのペットに何をドレスアップしますか?にデータをインポートしました JMP そして、私はデータがいくらか片付けが必要であることに気づきました。
幸いなことに、JMP 12は新しく設計された記録機能これにより、データをより効率的にクリーンアップできます。
最初、インポートされたデータは次のようになりました。
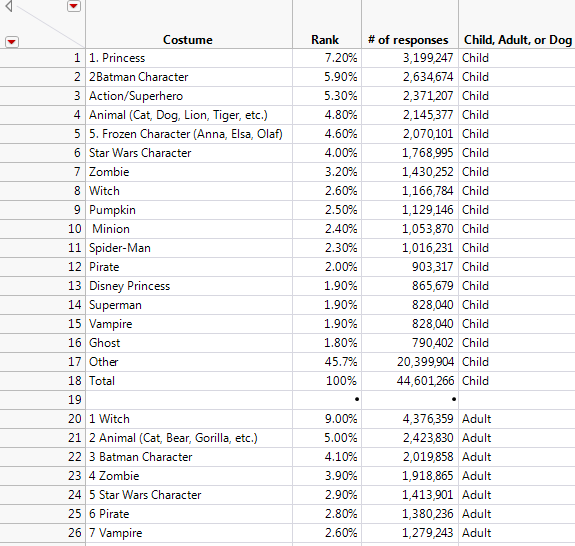
[Costume]列に不要な数字、空白、データテーブルに欠損値があることに注意してください。
強調表示して選択することで余分な文字を削除するためにCostume列を書き直しました。 Cols> Recode 。それぞれの値の前後の空白を取り除くために、赤い三角形のメニューからTrim Whitespaceオプションを使いました。
また、私は自分の記録したデータテーブルに含めたくない数字を検索するためにフィルタ検索バーを使いました。検索バーに「1」を入力すると、「1」を含むすべての値が上部にグループ化されます。[新しい値]列の不要な文字を削除すると、古い値と新しい値がグループ化されて網掛けになります。大量のデータを扱うときは、表示を制御するために[グループ化された/グループ化されていない表示のみ]チェックボックスを使用します。
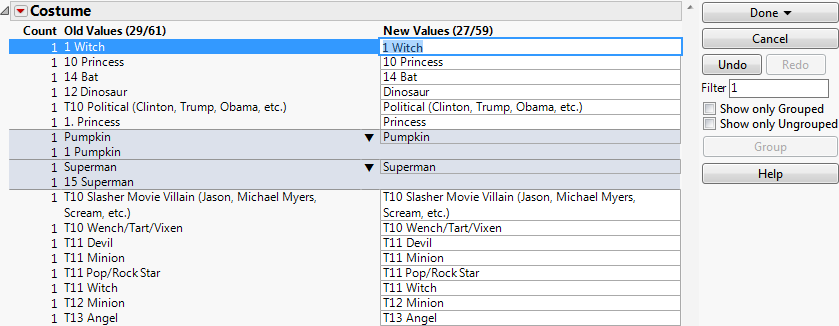
特に値の整合性をチェックする場合は、[類似値のグループ化]の赤い三角メニューオプションを使用してデータを整理して整理することもできます。このデータテーブルには複数回表示される値がありますが、間隔や余分な文字は異なります(たとえば、"Batman"と "Bat man")。私はそれらの値を見つけ、それらがテーブルを通して一貫しているようにそれらを書き換えたいと思いました。Difference RatioオプションとMax Character Differenceオプションは、(設定に応じて)わずか数文字だけ異なる値を自動的にグループ化します。これにより、間違いや矛盾を見つけやすくなります。デフォルトのDifference Ratio値は.25です。これは、最大で25%異なる値をまとめたものです。言い換えれば、少なくとも75%の文字が一致する値はまとめてまとめられています。
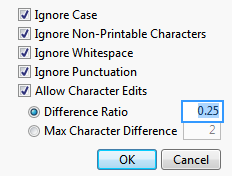
これは、似たような値をグループ化した後のデータです。
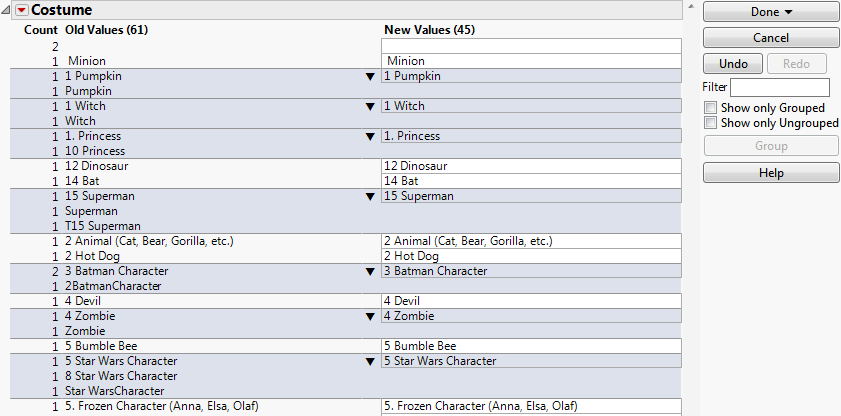
これで、グループ化された同様の値を簡単に見ることができます。特定の値のすべてのインスタンスが同じになるように各グループを編集しました。たとえば、「Star Wars Character」グループの新しい値を変更して、3つのインスタンスのそれぞれが同じ間隔になるようにしました。適切な変更を加えた後、私は選択しました完了>その場で 。このように、New Values列の値はデータテーブルの古い値を置き換えます。元のデータを保持するには、Recodeで行った変更を新しい列に保存します。 [完了]> [新しい列] または式列 。
これは、データがどのように見えるかです。グラフビルダーパーセントで衣装を分析するとき:
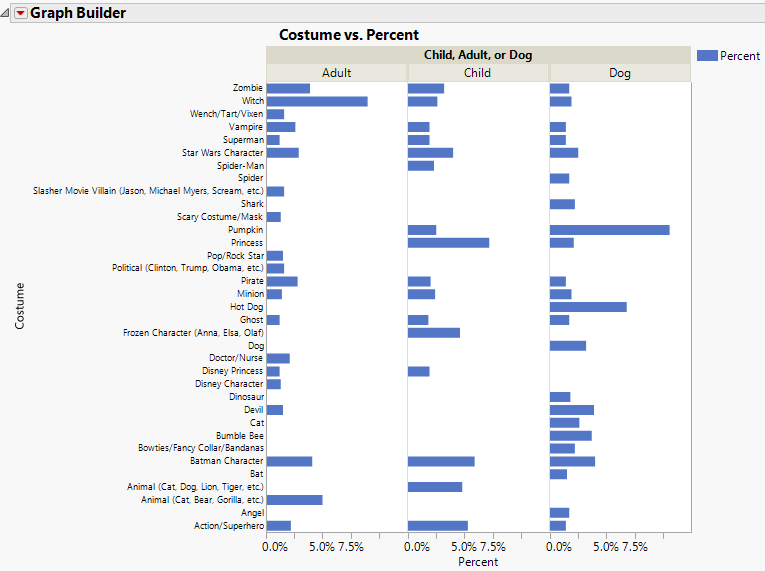
「その他」を含む行は除外され、非表示になっています。
また、上のプロットは雑然としていて分析が難しいことに注意してください。データ内のパターンを見つけやすくするために、Costume列をもう一度コーディングして、衣装をカテゴリに整理しました。Costume列が表示されたら再コード 、グループ化する値を選択して、右クリックオプションを使用しました。グループに 。動物のコスチュームがたくさんあるので、それらをまとめて「動物」のカテゴリーにしました。

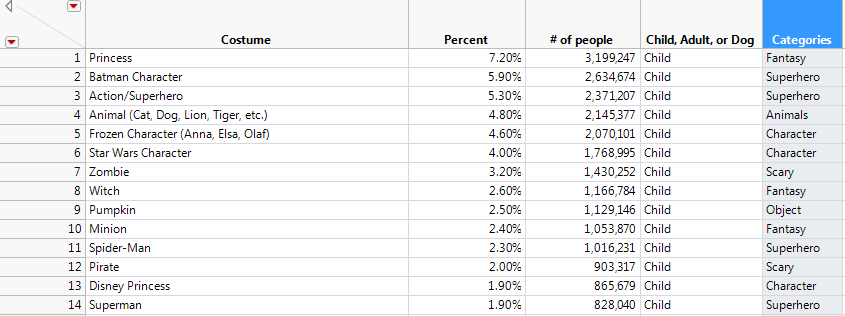
すべての動物を「動物(猫、犬、ライオン、虎など)」の下にまとめた後、カテゴリの名前を「動物」に短縮しました。残りのコスチュームは「スーパーヒーロー」、「ファンタジー」、「怖い」などのカテゴリーに分類しました。記録した後、私は選びました完了>数式列私のオリジナルのコスチュームコラムを保存するために。新しい列に「カテゴリ」という名前を付けました。列見出しをダブルクリックして式を表示できます。
これが、Categories列のテーブルの外観です。
解析
Costumesがカテゴリに分類されたので、Graph Builderはより解釈しやすいプロットを提供します。Graph Builderでは、X変数にパーセント列を、Y変数にカテゴリを使用しました。私は子供、大人、犬ごとにデータをまとめ、人気順に並べました。これが結果です。
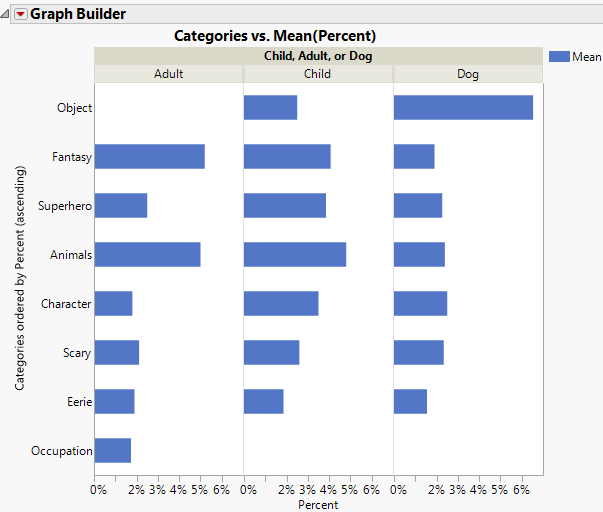
上のグラフは、各グループ(大人、子供、犬)のカテゴリー別の衣装選択の割合を示しています。私は大人、子供、そして犬の中でどのコスチュームカテゴリーが最もヒットしているかを見ることができます。ファンタジーのカテゴリは大人にとって最も人気があり、子供のためには動物カテゴリ、そして犬のためにはオブジェクトカテゴリが最も人気がありました。
さらにデータを分析するために、ローカルデータフィルタを使用して、成人用の衣装の選択肢だけを表示しました。これは、成人向けにフィルタリングされ、人気順に並べ替えられたデータです。
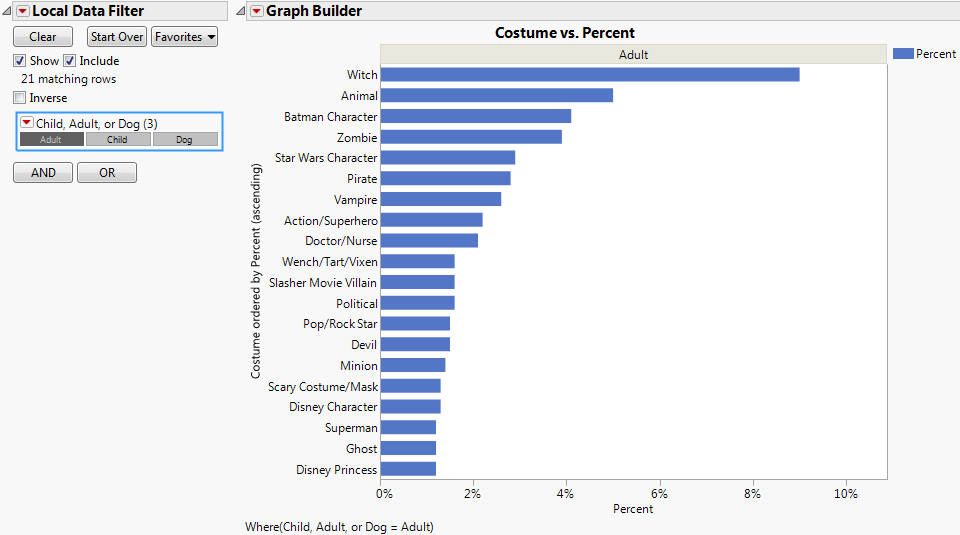
魔女の衣装は、今年大人の間で最も人気があります。
今、私はどの特定の衣装が子供と大人の間で最も人気があるかを調べます。再びGraph Builderを使用して、私は特定の衣装を選んだ人々の割合を分析しました。データには犬のコスチュームの数が含まれていなかったので、分析を実行する前に、「大人」と「子供」のみを含むグループという新しい列を作成しました。Dog行のエントリに値がありませんでした。これが結果を説明するためのモザイクプロットです。
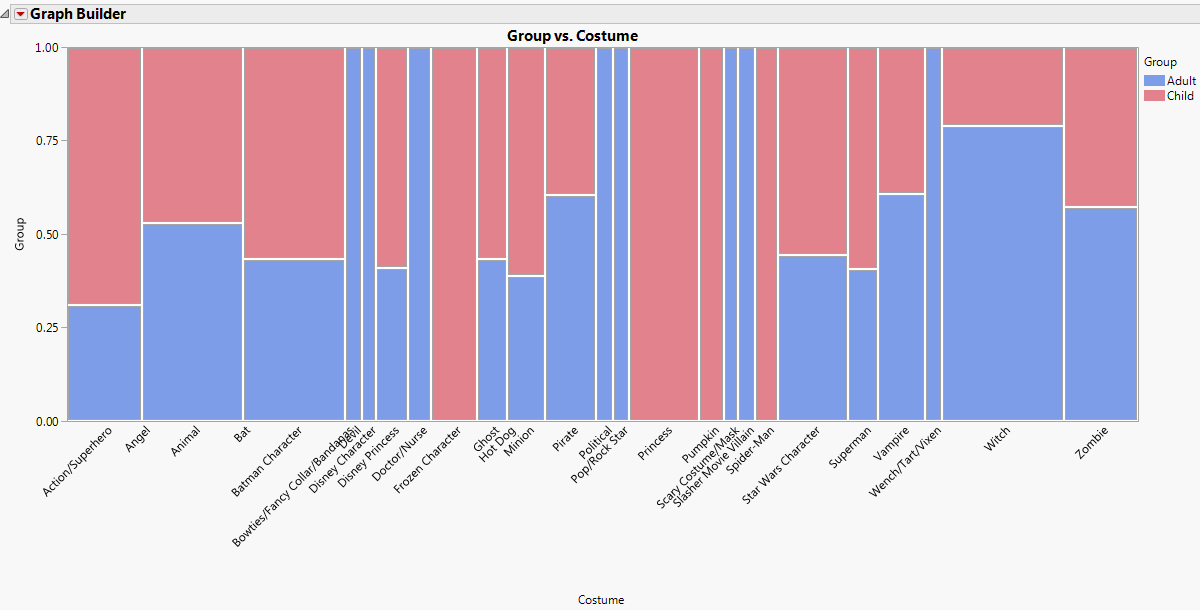
縦軸は、Costume列のどの部分がChildまたはAdultグループに入るかを示します。各バーの全体のサイズは、どの衣装が子供と大人の両方に人気があるかを示します。グラフは、魔女の衣装を選んだ人の約75%が大人だったことを示しています。動物コスチュームを選んだ人の約半分は大人で、半分は子供でした。Princessなどの一部のコスチュームグループは、1つのグループによって完全に支配されています。この場合、子供たちは彼らのコスチュームとして王女を選んだ人々の全体の割合を占めています。
さらに面白くするために、Fit Y by Xプラットフォームを使用してデータをカテゴリ別に分類し、別のモザイクプロットを作成しました。プロットは次のようになります。
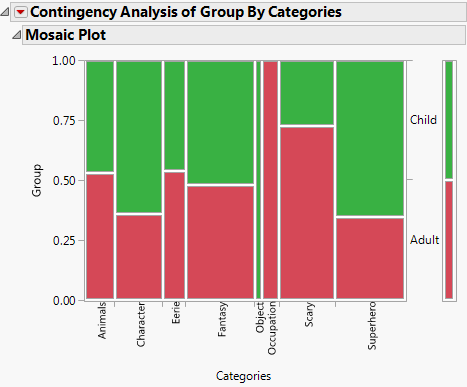
子供だけが物のカテゴリーから衣装を選び、大人だけが職業のカテゴリーから衣装を選んだことがわかります。全体的なバーのサイズを比較すると、ファンタジー、怖いとスーパーヒーローは大人と子供の両方のための最も人気のあるカテゴリです。前述の棒グラフのいずれかで同じ結果を観察できますが、上のモザイクプロットを使用すると、両方のグループで衣装の人気をより簡単に比較できます。
皆さんに楽しく安全なハロウィーンをお祈りします。魔女を探してください - どうやら私たちは今年それらの多くを見ることを期待することができます!
あなたはハロウィーンのために何になりますか?
ロバートペリー書きました:
素晴らしい記事!私の職業と怖いカテゴリーは重なっていると思います。
