¿Qué discos duros de ordenador son los más fiables? ¿Y con qué frecuencia debe reemplazar un disco duro? Esas son algunas de las preguntas que espero responder al explorar y analizar datos sobre las pruebas de disco duro. Una empresa llamada Backblaze, que ofrece servicios de respaldo de datos en línea, pone a disposición del público estos datos a través de su sitio web. Según la descripción de la Datos de prueba del disco duro de Backblaze , la compañía necesita tener discos duros adecuados que sean razonablemente confiables y económicamente factibles. En los últimos dos años, Backblaze recopiló datos diarios en los discos duros que estaban en servicio. Los investigadores de la compañía han publicado algunas conclusiones sobre la mejor unidad y un programa de reemplazo para las unidades, pero también tenían curiosidad sobre qué más se podía encontrar en los datos. Así que veamos si mi análisis está de acuerdo, en desacuerdo y / o encuentra algo más.
Mi primera impresión de los datos es: es grande. ¿Cuan grande? Hay 631 archivos diarios, cada uno es de aproximadamente 4 MB o 9 MB. Los archivos más nuevos son más grandes. El tamaño total de todos los archivos CSV es de alrededor de 3.5 GB. Cada archivo CSV parece tener el mismo formato, lo cual es muy bueno. Todos se ven así:
En lugar de concatenar los archivos en SQLite, lo hago en JMP. La tabla JMP resultante tiene más de 17 millones de filas. Las columnas son: "fecha", cuando se registró la fila; "Número de serie", que es el ID del disco duro; "Capacity_bytes" que es el tamaño del disco duro; "Falla" que indica si ese disco duro falló en ese día; 40 columnas de crudo INTELIGENTE estadísticas sobre el disco duro de ese día; y 40 columnas de estadísticas SMART normalizadas.
¡Y la tabla JMP resultante es más de 12 GB! Hmm, ¿qué acaba de pasar? La descripción de la fuente de datos mencionó que faltan muchas estadísticas SMART en los datos; los valores que faltan en la tabla JMP son números flotantes de doble precisión, pero no ocupan espacios entre dos comas en un archivo CSV. Supongo que hay muchos valores perdidos en los archivos CSV. Eso explica por qué el archivo de datos binarios es mucho mayor que el total de todos los archivos CSV. Volveremos a la cuestión del valor perdido más tarde.
Ahora quiero ver la distribución de vida de un disco duro seleccionado al azar disponible en el almacén de Backblaze, independientemente del fabricante y el modelo. (Supongo que los discos duros grabados forman una buena muestra que representa todos los discos duros que tienen).
De los datos resultantes, podemos recopilar la cantidad de días hasta la falla o la censura, para cada disco duro. En caso de que no esté familiarizado con la terminología de "censura", significa que el disco duro no falló en el momento en que se guardó su último registro. Solemos decir que el fracaso y la censura son eventos. Usamos el "tiempo para el evento" para referir el tiempo a la falla o censura. El cálculo del tiempo hasta el evento se realiza calculando el rango de fechas por número de serie. Usando los valores calculados de tiempo hasta el evento, podemos calcular una estimación no paramétrica de la distribución de fallas de todos los discos duros que han utilizado.
La siguiente captura de pantalla muestra la estimación. ¿Cómo interpretamos la trama? Cada punto de la gráfica tiene dos coordenadas, la coordenada x es el tiempo en Días, y la coordenada y es la probabilidad esperada de que un disco duro elegido al azar falle antes de ese tiempo. Por ejemplo, un punto alrededor de 300 días tiene una probabilidad de alrededor de 0.03. Entonces, si tenemos 100 unidades de disco duro elegidas al azar que comiencen a funcionar el primer día, deberíamos esperar que 3 de ellas fallen antes de 300 días.
Como una declaración, decimos que la probabilidad de falla (a veces también llamada tasa de falla) a los 300 días es de 0.03. Observe que la probabilidad de falla (tasa de falla) aquí es diferente de la tasa de falla que analiza la página web de Datos de prueba del disco duro de Backblaze; ver su mejor disco duro Blog. Su tasa de fracaso está relacionada con, pero no parece ser exactamente, la tasa recurrente en un proceso de renovación en nuestra terminología. Creo que puedo usar mi tasa de fracaso para derivar algo similar a su tasa, pero no al revés. Voy a ver más de cerca más adelante.

Si la vida fuera siempre fácil, probablemente podríamos ajustar los datos usando una distribución paramétrica, por ejemplo, Weibull, Lognormal, etc. Si es así, deberíamos ver la estimación no paramétrica a lo largo de una curva suave sin protuberancias. ¡Pero esta vez no tenemos tanta suerte!
Sin embargo, no es sorprendente ver que hay topes o puntos de inflexión en la estimación. Según la página de Wikipedia en INTELIGENTE Las fallas en el disco duro son de dos tipos: fallas predecibles y fallas impredecibles. Parece que están hablando de modos de falla: desgaste, y todos los demás. Podríamos asumir que cada modo de falla puede ser modelado por una sola distribución, por ejemplo, Weibull, Lognormal. Entonces podemos aplicar los famosos. tasa de fracaso de la bañera .
Esto tampoco es tan fácil. Es sorprendente ver al menos dos puntos de inflexión obvios en la estimación no paramétrica. Uno es alrededor de 150 días, y el otro alrededor de 550 días. Si el último divide los predecibles e impredecibles, ¿nos dice el primer punto de inflexión que podemos clasificar los fallos impredecibles en más de un modo?
Suponiendo que estamos considerando el punto de inflexión alrededor de 550 días como el lugar donde las fallas se vuelven más predecibles, es sorprendente que las fallas se acumulen gradualmente más rápido antes de ese punto. ¿No es ese contador intuitivo? Espero que las fallas inesperadas se desaceleren, de acuerdo con lo que deberíamos esperar del fenómeno de la tasa de fallas en la bañera.
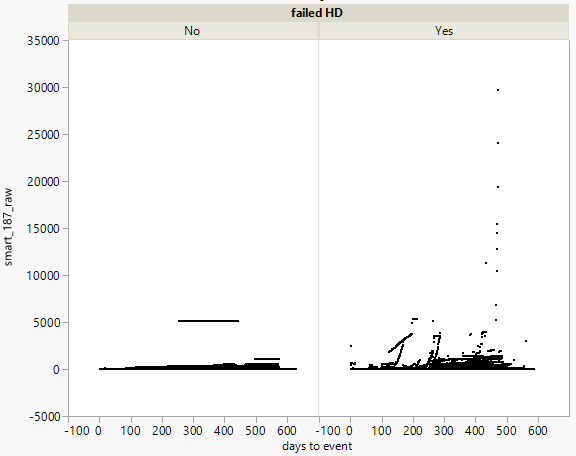
Antes de profundizar, quiero echar un vistazo sobre las estadísticas SMART en los datos. Elegí ver la estadística etiquetada como SMART 187, porque está resaltada en una publicación del blog Backblaze, Estadísticas de disco duro SMART , como una de las variables más prometedoras para decidir si un disco duro necesita reemplazo.
Hice un simple diagrama de dispersión de los valores brutos de SMART 187 contra las edades de los discos duros cuando se registraron los valores de SMART 187 correspondientes. El panel izquierdo dibuja un diagrama de dispersión para los buenos discos duros que no fallaron en sus últimos registros. El panel derecho dibuja un diagrama de dispersión para las unidades de disco duro que han fallado. Según las explicaciones sobre Estadísticas de disco duro SMART , se esperan las diferencias en los dos gráficos, es decir, los valores SMART 187 en los paneles de la derecha parecen ser más grandes que los del panel de la izquierda. Eso es consistente con la afirmación de que cuanto más alto es el valor de SMART 187, más probable es que falle el disco duro.
No hay sorpresas difíciles de entender hasta ahora. Bueno. Pero esos son probablemente hechos bien conocidos. ¿Ahora que? No podemos tener miedo de ensuciarnos las manos, supongo.
Continuará…
