어떤 컴퓨터 하드 드라이브가 가장 안정적입니까? 얼마나 자주 하드 드라이브를 교체해야합니까? 그것들은 하드 드라이브 테스트에 대한 데이터를 탐색하고 분석 할 때 대답하기를 희망하는 몇 가지 질문입니다. 온라인 데이터 백업 서비스를 제공하는 Backblaze라는 회사는이 데이터를 관대하게 웹 사이트를 통해 공개합니다. 의 설명에 따르면 Backblaze 하드 드라이브 테스트 데이터 , 회사는 합리적으로 신뢰할 수 있고 경제적으로 실현 가능한 적절한 하드 드라이브가 필요합니다. 지난 2 년 동안, Backblaze는 서비스중인 하드 드라이브에 대한 일별 데이터를 수집했습니다. 회사 연구원은 드라이브에 대한 최상의 드라이브 및 교체 일정에 대한 결론을 발표했지만 데이터에서 발견 할 수있는 것이 무엇인지 궁금해했습니다. 그럼 내 분석이 동의하는지, 동의하지 않는지, 그리고 / 또는 다른 것을 발견하는지 살펴 봅시다.
데이터에 대한 나의 첫인상은 : 그것은 크다. 얼마나 큰? 매일 631 개의 파일이 있으며 각각은 약 4MB 또는 9MB입니다. 최신 파일이 더 큽니다. 모든 CSV 파일의 전체 크기는 약 3.5GB입니다. 각 CSV 파일의 형식이 같아서 매우 좋습니다. 그들은 모두 다음과 같이 보입니다.
SQLite에서 파일을 연결하는 대신 JMP에서 파일을 연결합니다. 결과 JMP 테이블에는 1700 만 개가 넘는 행이 있습니다. 열은 다음과 같습니다. 행이 기록되었을 때의 "날짜". "serial_number"는 하드 드라이브 ID입니다. 하드 드라이브의 크기 인 "capacity_bytes"; 하드 드라이브가 그 날에 실패했는지 여부를 나타내는 "실패"; 익지 않는 40 열 똑똑한 그 날의 하드 드라이브에 관한 통계; 40 열의 정규화 된 SMART 통계.
결과 JMP 테이블은 12GB 이상입니다! 흠, 방금 무슨 일이 있었 니? 데이터 소스에 대한 설명에서 데이터의 많은 SMART 통계가 누락되었다고 언급했습니다. JMP 테이블의 누락 된 값은 배정 밀도 부동 소수점이지만 CSV 파일의 두 쉼표 사이에 공백을 두지 않습니다. CSV 파일에는 많은 누락 된 값이있는 것 같습니다. 이것이 바이너리 데이터 파일이 모든 CSV 파일의 합계보다 훨씬 큰 이유를 설명합니다. 나중에 누락 된 가치 문제로 돌아갈 것입니다.
이제 제조업체 및 모델에 관계없이 Backblaze 창고에서 임의로 선택한 하드 드라이브의 수명 분포를 살펴보고자합니다. (나는 기록 된 하드 드라이브가 그들이 가진 모든 하드 드라이브를 나타내는 좋은 샘플을 형성한다고 가정하고 있습니다.)
결과 데이터에서 모든 하드 드라이브에 대해 실패 또는 중도 절단까지의 일 수를 수집 할 수 있습니다. "검열 (censoring)"용어에 익숙하지 않은 경우 하드 드라이브가 마지막 기록이 저장되었을 때 실패하지 않았 음을 의미합니다. 우리는 보통 실패와 검열은 사건이라고 말합니다. 우리는 실패 나 중도 절단에 대한 시간을 나타 내기 위해 "사건 발생 시간"을 사용합니다. 이벤트 시간 계산은 날짜 범위를 일련 번호로 계산하여 수행됩니다. 계산 된 이벤트 시간 값을 사용하여 사용 된 모든 하드 드라이브의 오류 분포에 대한 비모수적인 추정치를 계산할 수 있습니다.
다음 스크린 샷은 예상치를 보여줍니다. 어떻게 그 음모를 해석할까요? 플롯의 각 점에는 두 개의 좌표가 있으며 x 좌표는 일 단위의 시간이며 y 좌표는 무작위로 선택한 하드 드라이브가 그 시간 전에 실패 할 것으로 예상되는 확률입니다. 예를 들어, 약 300 일 지점에는 확률이 0.03입니다. 따라서 무작위로 선택한 100 개의 하드 드라이브가 첫날에 실행되기 시작하면 300 일이 지나면 그 중 3 개가 실패 할 것으로 예상됩니다.
성명서에서 300 일 후의 실패 확률 (때로는 실패율이라고도 함)은 0.03이라고합니다. 여기에서 실패 확률 (실패율)은 Backblaze 하드 드라이브 테스트 데이터 웹 페이지에서 논의한 실패율과 다릅니다. 그들의 것을 보아라. 최고의 하드 드라이브 블로그. 그들의 실패율은 우리의 용어에서의 갱신 과정에서 반복되는 비율과 관련이 있지만 정확히는 아닙니다. 나는 나의 실패율을 그들의 비율과 유사한 것을 파생시키기 위해 사용할 수 있다고 믿지만 그 반대의 것은 아니다. 나중에 더 자세히 살펴볼 것입니다.

삶이 항상 쉽다면 우리는 아마도와 이블 (Weibull), 로그 노말 (Lognormal) 등과 같은 파라 메트릭 분포를 사용하여 데이터를 적합시킬 수있었습니다. 그렇다면 우리는 범프없이 부드러운 곡선을 따라 비모수적인 추정치를보아야합니다. 하지만 이번에는 운이 좋지 않습니다!
그러나 예상치에 요동이나 전환점이있는 것은 놀라운 일이 아닙니다. Wikipedia 페이지에 똑똑한 하드 드라이브 오류는 예측 가능한 오류와 예기치 않은 오류의 두 가지 유형입니다. 그것은 그들이 실패 모드에 관해 말하는 것처럼 들린다. 마모와 다른 것들. 우리는 각 고장 모드가 Weibull, Lognormal과 같은 단일 분포에 의해 모델링 될 수 있다고 가정 할 수 있습니다. 그런 다음 유명한 욕조 고장률 .
이것은 쉬운 일도 아닙니다. 비모수적인 추정에서 적어도 두 가지 분명한 전환점을 보는 것은 놀라운 일입니다. 하나는 약 150 일, 다른 하나는 약 550 일입니다. 나중에 하나가 예측 가능하고 예측할 수없는 것들을 나눈다면, 첫 번째 전환점은 우리가 예견 할 수없는 실패를 하나 이상의 모드로 분류 할 수 있다고 말합니까?
우리가 실패를 예상 할 수있는 곳으로 550 일 전후의 전환점을 고려한다고 가정하면, 그 시점 이전에 실패가 점차 빨라지고 있다는 것은 놀랍습니다. 그 카운터가 직관적이지 않습니까? 우리는 욕조 실패율 현상에서 기대해야하는 것에 따라 예기치 못한 실패가 느려질 것으로 예상합니다.
우리가 더 깊이 들어가기 전에 데이터에서 SMART 통계에 대해 살펴보고 싶습니다. 나는 Backblaze 블로그 포스트에서 강조 되었기 때문에 SMART 187이라는 라벨이 붙은 통계를 보았습니다. 하드 드라이브 SMART 통계 하드 드라이브 교체가 필요한지 여부를 결정할 때 가장 유망한 변수 중 하나입니다.
필자는 해당 SMART 187 값이 기록 될 때 하드 드라이브의 수명에 대한 SMART 187 원시 값의 간단한 산점도를 만들었습니다. 왼쪽 패널은 마지막 레코드를 통과하지 못한 좋은 하드 드라이브의 산점도를 그립니다. 오른쪽 패널은 고장난 하드 드라이브에 대한 산점도를 그립니다. 에 대한 설명에 따르면 하드 드라이브 SMART 통계 두 플롯의 차이가 예상됩니다. 즉, 오른쪽 패널의 SMART 187 값이 왼쪽 패널의 SMART 187 값보다 큽니다. 이는 SMART 187 값이 높을수록 하드 드라이브가 실패 할 가능성이 높다는 주장과 일치합니다.
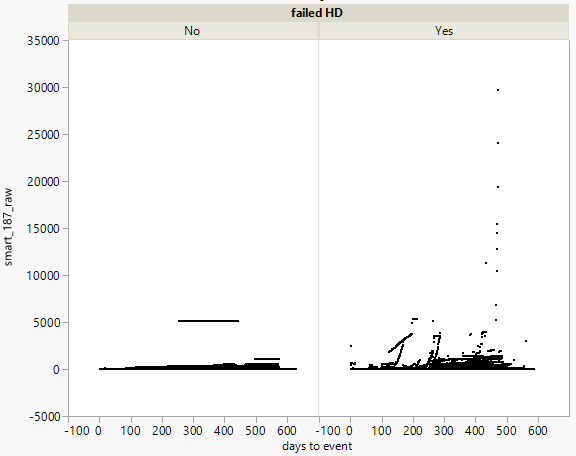
지금까지 이해하기 힘든 놀라움은 없습니다. 좋은. 그러나 그것들은 아마 잘 알려진 사실입니다. 이제 뭐? 우리 손이 더러워지기를 두려워 할 수는 없습니다.
계속하려면 ...
