Quali dischi rigidi per computer sono più affidabili? E quanto spesso dovresti sostituire un disco fisso? Queste sono alcune delle domande a cui spero di rispondere esplorando e analizzando i dati sui test del disco rigido. Una società chiamata Backblaze, che offre servizi di backup dei dati online, rende generosamente questi dati disponibili al pubblico attraverso il suo sito web. Secondo la descrizione del Backblaze Hard Drive Test Data , l'azienda deve disporre di dischi rigidi adeguati, ragionevolmente affidabili ed economicamente fattibili. Negli ultimi due anni, Backblaze ha raccolto dati giornalieri su hard disk in servizio. I ricercatori dell'azienda hanno pubblicato alcune conclusioni sulla migliore guida e un programma sostitutivo per le unità, ma erano anche curiosi di sapere cos'altro poteva essere trovato nei dati. Quindi vediamo se la mia analisi è d'accordo, non è d'accordo e / o trova qualcos'altro.
La mia prima impressione dei dati è: è grande. Quanto grande? Ci sono 631 file giornalieri, ciascuno di circa 4 MB o 9 MB. I file più recenti sono più grandi. La dimensione totale di tutti i file CSV è di circa 3,5 GB. Ogni file CSV sembra avere lo stesso formato, che è molto buono. Sembrano tutti così:
Invece di concatenare i file in SQLite, lo faccio in JMP. La tabella JMP risultante ha più di 17 milioni di righe. Le colonne sono: "date", quando la riga è stata registrata; "Serial number", che è l'ID del disco rigido; "Capacity_bytes" che è la dimensione del disco rigido; "Fallimento" che indica se quel disco rigido non è riuscito in quel giorno; 40 colonne di grezzo INTELIGENTE statistiche sul disco fisso in quel giorno; e 40 colonne di statistiche SMART normalizzate.
E la tabella JMP risultante è più di 12 GB! Hmm, cos'è successo? La descrizione della fonte dei dati indica che mancano molte statistiche SMART nei dati; i valori mancanti nella tabella JMP sono numeri mobili di precisione doppia, ma non occupano spazi tra due virgole in un file CSV. Immagino ci siano molti valori mancanti nei file CSV. Questo spiega perché il file di dati binari finisce molto più del totale di tutti i file CSV. Torneremo al problema del valore mancante in seguito.
Ora voglio esaminare la distribuzione della vita di un disco rigido selezionato a caso disponibile nel magazzino Backblaze, indipendentemente dal produttore e dal modello. (Suppongo che i dischi rigidi registrati formino un buon esempio che rappresenta tutti i dischi rigidi che hanno).
Dai dati risultanti, possiamo raccogliere il numero di giorni fino al fallimento o alla censura, per ogni disco rigido. Nel caso in cui non si abbia familiarità con la terminologia "censura", significa che il disco rigido non ha avuto esito negativo nel momento in cui è stato salvato il suo ultimo record. Di solito diciamo che il fallimento e la censura sono eventi. Usiamo "time-to-event" per riferire il tempo al fallimento o alla censura. Il calcolo del time-to-event viene eseguito calcolando l'intervallo di date per numero di serie. Utilizzando i valori calcolati time-to-event, possiamo calcolare una stima non parametrica della distribuzione degli errori da tutti i dischi rigidi che hanno utilizzato.
La prossima schermata mostra la stima. Come interpretiamo la trama? Ogni punto nel grafico ha due coordinate, la coordinata x è il tempo in Giorni, e la coordinata y è la probabilità prevista che un disco rigido scelto a caso abbia esito negativo prima di quel momento. Ad esempio, un punto intorno a 300 giorni ha una probabilità intorno a 0,03. Quindi, se avremo 100 hard disk scelti casualmente che inizieranno a funzionare al primo giorno, dovremmo aspettarci che 3 di essi falliscano entro 300 giorni.
Come affermazione, diciamo che la probabilità di fallimento (a volte anche chiamata tasso di fallimento) a 300 giorni è 0,03. Si noti che la probabilità di errore (tasso di errore) qui è diversa dalla percentuale di errore discussa dalla pagina Web Dati di test del disco rigido di Backblaze; vedere loro miglior disco rigido blog. Il loro tasso di insuccesso è correlato, ma non sembra esattamente, al tasso ricorrente in un processo di rinnovo nella nostra terminologia. Credo di poter usare il mio tasso di insuccesso per ricavare qualcosa di simile al loro tasso, ma non viceversa. Vedrò più da vicino.

Se la vita fosse sempre facile, potremmo probabilmente adattare i dati utilizzando una distribuzione parametrica, ad esempio, Weibull, Lognormal, ecc. Se è così, dovremmo vedere la stima non parametrica che percorre una curva liscia senza rilievi. Ma non siamo così fortunati questa volta!
Tuttavia, non è sorprendente vedere che ci sono dossi o punti di svolta nella stima. Secondo la pagina di Wikipedia su INTELIGENTE , i guasti del disco rigido sono di due tipi: guasti prevedibili e guasti imprevedibili. Sembra che stiano parlando delle modalità di fallimento: esaurimenti e tutti gli altri. Potremmo presumere che ogni modalità di errore possa essere modellata da una singola distribuzione, ad es. Weibull, Lognormal. Quindi possiamo applicare il famoso tasso di fallimento della vasca da bagno .
Neanche questo è facile. È sorprendente vedere almeno due punti di svolta ovvi nella stima non parametrica. Uno è di circa 150 giorni e l'altro circa 550 giorni. Se la successiva divide quelle prevedibili e imprevedibili, allora il primo punto di svolta ci dice che possiamo classificare i fallimenti imprevedibili in più di una modalità?
Supponendo che stiamo considerando il punto di svolta intorno ai 550 giorni come il luogo in cui i fallimenti diventano più prevedibili, è sorprendente che i fallimenti si stiano gradualmente accelerando prima di quel punto. Non è contro-intuitivo? Mi aspetto che i guasti imprevisti rallentino, in base a ciò che dovremmo aspettarci dal fenomeno del tasso di guasto della vasca da bagno.
Prima di approfondire, voglio dare un'occhiata alle statistiche SMART nei dati. Ho scelto di guardare la statistica etichettata come SMART 187, perché è evidenziata in un post sul blog di Backblaze, Statistiche SMART sul disco rigido , come una delle variabili più promettenti per decidere se un disco rigido deve essere sostituito.
Ho creato un semplice grafico a dispersione dei valori grezzi SMART 187 rispetto all'età dei dischi rigidi quando sono stati registrati i valori SMART 187 corrispondenti. Il pannello di sinistra disegna un grafico a dispersione per i buoni dischi rigidi che non hanno fallito attraverso i loro ultimi record. Il pannello destro disegna un grafico a dispersione per i dischi rigidi guasti. Secondo le spiegazioni su Statistiche SMART sul disco rigido , le differenze nei due grafici sono previste, ovvero i valori SMART 187 nei pannelli di destra sembrano essere più grandi di quelli nel pannello di sinistra. Ciò è coerente con l'affermazione che maggiore è il valore SMART 187, maggiore è la probabilità che il disco rigido non riesca.
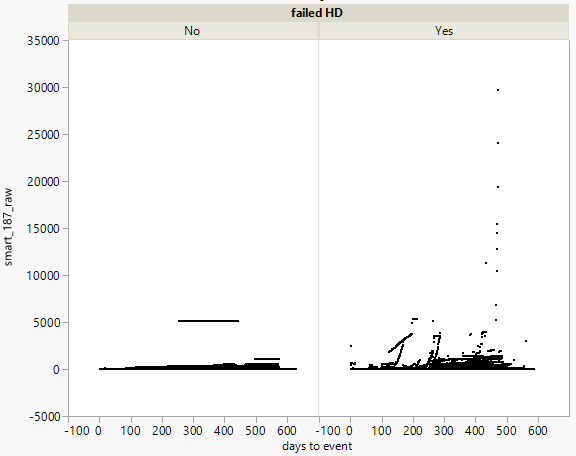
Nessuna sorpresa difficile da capire finora. Buono. Ma quelli sono fatti probabilmente noti. Ora cosa? Non possiamo aver paura di sporcarci le mani, immagino.
Continua…
