どのコンピュータのハードドライブが最も信頼性がありますか?そして、どのくらいの頻度でハードドライブを交換する必要がありますか?これらは、ハードドライブテストに関するデータの調査と分析において私が答えたいと思ういくつかの質問です。オンラインデータのバックアップサービスを提供するBackblazeという会社は、このデータを自社のWebサイトを通じて一般に公開しています。の説明によると Backblazeハードドライブテストデータ 、同社は合理的に信頼性があり経済的に実現可能な十分なハードドライブを持っている必要があります。過去2年間で、Backblazeは稼働中のハードドライブの日々のデータを収集しました。会社の研究者たちは、最高のドライブとドライブの交換スケジュールに関するいくつかの結論を発表しましたが、データに他に何が見つかるかについても興味がありました。それで、私の分析が賛成、反対、そして/または何か他のものを見つけたかどうか見てみましょう。
私のデータに対する最初の印象は次のとおりです。それは大きいです。いくらですか?1日に631ファイルがあり、それぞれ約4 MBまたは9 MBです。新しいファイルは大きいです。すべてのCSVファイルの合計サイズは約3.5 GBです。各CSVファイルは同じフォーマットを持っているようですが、これは非常に優れています。それらはすべてこのように見えます:
SQLiteでファイルを連結する代わりに、JMPでそれを行います。結果のJMPテーブルには、1,700万を超える行があります。列は次のとおりです。行が記録された「日付」。“ serial_number”、これはハードドライブIDです。“ capacity_bytes”はハードドライブのサイズです。その日のそのハードドライブが故障したかどうかを示す「故障」。生の40列スマートその日のハードドライブに関する統計。40列の正規化されたSMART統計。
そして、結果のJMPテーブルは12 GB以上です。うーん、どうしたの?データソースの説明によると、データ内の多くのSMART統計が欠落しています。JMPテーブルの欠損値は倍精度浮動小数点数ですが、CSVファイル内の2つのカンマの間にスペースを入れないでください。CSVファイルには欠損値がたくさんあると思います。これが、バイナリデータファイルがすべてのCSVファイルの合計よりもはるかに大きくなる理由を説明しています。後で、欠損値の問題に戻ります。
製造元やモデルに関係なく、Backblazeの倉庫でランダムに選択されたハードドライブの寿命分布を調べたいと思います。(私は、記録されたハードドライブがそれらが持っているすべてのハードドライブを表す良いサンプルを形成すると仮定しています。)
得られたデータから、すべてのハードドライブについて、故障または検閲までの日数を収集できます。「検閲」という用語に慣れていない場合は、最後のレコードが保存された時点でハードドライブが故障していないことを意味します。我々は通常、失敗と検閲は出来事であると言う。私達は失敗までの時間または打ち切りを指すために「イベントまでの時間」を使用します。イベントまでの時間の計算は、シリアル番号によって日付範囲を計算することによって実行されます。計算されたイベント発生時間値を使用して、使用したすべてのハードドライブから障害分布のノンパラメトリック推定を計算できます。
次のスクリーンショットは見積もりを示しています。プロットをどのように解釈しますか?プロット内の各ドットには2つの座標があり、x座標は日数での時間、y座標はランダムに選択されたハードドライブがそれ以前に故障すると予想される確率です。たとえば、300日前後のポイントの確率は0.03前後です。したがって、100台のランダムに選択されたハードドライブが1日目に起動したとすると、300台のうち3台が故障すると予想する必要があります。
文として、300日での失敗確率(失敗率とも呼ばれる)は0.03であると言います。ここでの失敗確率(失敗率)は、Backblaze Hard DriveテストデータWebページで説明されている失敗率とは異なります。彼らを見て最高のハードドライブブログ それらの失敗率は、私たちの用語の更新プロセスにおける再発率に関連していますが、正確にはそうではありません。私は自分の失敗率を使ってそれらの率に似たものを導き出すことができると信じていますが、その逆はできません。後で詳しく説明します。

人生がいつも簡単なものであれば、おそらくパラメトリック分布、例えばWeibull、Lognormalなどを使ってデータをフィットさせることができます。もしそうであれば、ノンパラメトリック推定がバンプなしで滑らかな曲線に沿って進んでいるのがわかります。しかし、今回はそれほど幸運ではありません。
ただし、見積もりに盛り上がりや転機があるのを見ても驚くことではありません。のウィキペディアのページによるとスマートハードドライブの障害には、予測可能な障害と予測不可能な障害の2種類があります。彼らは失敗モードについて話しているように聞こえます。Weibull、Lognormalなど、各故障モードは単一の分布でモデル化できると想定できます。それから私達は有名なを適用できますバスタブ故障率 。
これもそれほど簡単ではありません。ノンパラメトリック推定に少なくとも2つの明らかな転換点があることは驚くべきことです。1つは約150日、もう1つは約550日です。後者が予測可能なものと予測不可能なものを分けた場合、最初の転換点は予測不可能な失敗を複数のモードに分類することができるということを教えてくれますか?
550日前後の転換点を、障害が予測可能になる場所と見なしていると仮定すると、その障害が発生する前に障害が徐々に急速に増加することは驚くべきことです。それは直観的ではないでしょうか。バスタブの故障率の現象から予想されることによると、私は予期せぬ故障が減速すると予想します。
さらに深く掘り下げる前に、データ内のSMART統計について見てみましょう。これはBackblazeのブログ投稿で強調表示されているので、SMART 187というラベルの統計を見ることにしました。ハードドライブのSMART統計ハードドライブを交換する必要があるかどうかを判断するための最も有望な変数の1つとして。
対応するSMART 187の値が記録されたときの、ハードドライブの使用年数に対するSMART 187の未加工の値の簡単な散布図を作成しました。左側のパネルは、最後の記録で失敗しなかった良質のハードドライブの散布図を描きます。右側のパネルは、故障したハードドライブの散布図を描きます。の説明によるとハードドライブのSMART統計すなわち、右側のパネルのSMART 187の値は左側のパネルの値よりも大きいように見えます。これは、SMART 187の値が高いほど、ハードドライブが故障する可能性が高いという主張と一致しています。
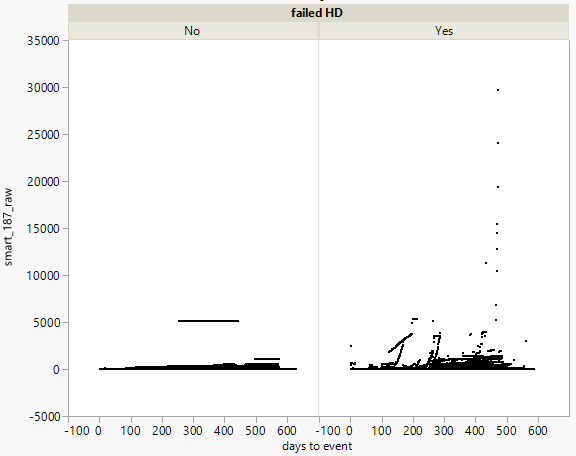
今までのところわかりにくい驚きはありません。良い。しかし、それらはおそらく有名な事実です。それで?手を汚すのを恐れてはいけない、と私は思う。
つづく…
