Quels sont les disques durs les plus fiables? Et combien de fois devriez-vous remplacer un disque dur? Ce sont quelques-unes des questions auxquelles j'espère pouvoir répondre en explorant et en analysant les données relatives aux tests de disque dur. Une société appelée Backblaze, qui propose des services de sauvegarde de données en ligne, met généreusement ces données à la disposition du public via son site Web. Selon la description de la Données de test du disque dur Backblaze , la société doit disposer de disques durs adéquats, à la fois raisonnablement fiables et économiquement réalisables. Au cours des deux dernières années, Backblaze a collecté des données quotidiennes sur les disques durs en service. Les chercheurs de la société ont publié des conclusions sur le meilleur disque et un calendrier de remplacement des disques, mais ils étaient également curieux de savoir ce qui pourrait être trouvé dans les données. Voyons donc si mon analyse est en accord, en désaccord et / ou trouve autre chose.
Ma première impression des données est la suivante: c'est grand. De quelle taille? Il y a 631 fichiers quotidiens, chacun faisant environ 4 Mo ou 9 Mo. Les nouveaux fichiers sont plus gros. La taille totale de tous les fichiers CSV est d'environ 3,5 Go. Chaque fichier CSV semble avoir le même format, ce qui est très bon. Ils ressemblent tous à ceci:
Au lieu de concaténer les fichiers dans SQLite, je le fais dans JMP. La table JMP résultante a plus de 17 millions de lignes. Les colonnes sont: "date", date à laquelle la ligne a été enregistrée; "Serial_number", qui est l'ID du disque dur; "Capacity_bytes" qui correspond à la taille du disque dur; «Échec» qui indique si ce disque dur est tombé en panne ce jour-là; 40 colonnes de brut INTELLIGENT statistiques sur le disque dur ce jour-là; et 40 colonnes de statistiques SMART normalisées.
Et la table JMP qui en résulte fait plus de 12 Go! Hmm, qu'est-ce qui vient de se passer? La description de la source de données indique que de nombreuses statistiques SMART dans les données sont manquantes. Les valeurs manquantes dans la table JMP sont des nombres flottants double précision, mais n'occupent aucun espace entre deux virgules dans un fichier CSV. Je suppose qu'il y a beaucoup de valeurs manquantes dans les fichiers CSV. Cela explique pourquoi le fichier de données binaire est beaucoup plus volumineux que le total de tous les fichiers CSV. Nous reviendrons plus tard sur le problème de la valeur manquante.
Je souhaite maintenant examiner la répartition de la durée de vie d’un disque dur sélectionné au hasard, disponible dans l’entrepôt de Backblaze, quels que soient son fabricant et son modèle. (Je suppose que les disques durs enregistrés forment un bon échantillon qui représente tous les disques durs qu’ils possèdent.)
À partir des données obtenues, nous pouvons collecter le nombre de jours d’échec ou de censure pour chaque disque dur. Si vous ne connaissez pas la terminologie «censure», cela signifie que le disque dur n'a pas échoué au moment de la sauvegarde de son dernier enregistrement. Nous disons généralement que l'échec et la censure sont des événements. Nous utilisons le terme "time-to-event" (événement) pour nous référer au temps passé à l'échec ou à la censure. Le calcul du délai avant événement est effectué en calculant la plage de dates par numéro de série. En utilisant les valeurs calculées du temps avant événement, nous pouvons calculer une estimation non paramétrique de la distribution des défaillances à partir de tous les disques durs utilisés.
La capture d'écran suivante montre l'estimation. Comment interprétons-nous l'intrigue? Chaque point du graphique a deux coordonnées, la coordonnée x est le temps en jours et la coordonnée y est la probabilité attendue qu'un disque dur choisi de manière aléatoire tombe en panne avant cette heure. Par exemple, un point autour de 300 jours a une probabilité d'environ 0,03. Donc, si 100 disques durs choisis au hasard commencent à fonctionner au premier jour, nous devrions nous attendre à ce que trois d’entre eux échouent au bout de 300 jours.
En tant que déclaration, nous disons que la probabilité d’échec (parfois aussi appelée taux d’échec) à 300 jours est de 0,03. Notez que la probabilité d'échec (taux d'échec) ici est différente du taux d'échec dont traite la page Web Données de test de disque dur Backblaze; voir leur meilleur disque dur Blog. Leur taux d'échec est lié, mais ne semble pas être exactement, au taux récurrent d'un processus de renouvellement dans notre terminologie. Je crois que je peux utiliser mon taux d'échec pour obtenir quelque chose de similaire à leur taux, mais pas l'inverse. Je regarderai de plus près plus tard.

Si la vie était toujours facile, nous pourrions probablement ajuster les données en utilisant une distribution paramétrique, par exemple, Weibull, Lognormal, etc. Si tel est le cas, l’estimation non paramétrique devrait suivre une courbe lisse et sans relief. Mais nous ne sommes pas aussi chanceux cette fois!
Cependant, il n’est pas surprenant de constater que l’estimation présente des hauts et des bas. Selon la page Wikipedia sur INTELLIGENT , les pannes de disque dur sont de deux types: les pannes prévisibles et les pannes imprévisibles. On dirait qu'ils parlent de modes de défaillance: usure et tous les autres. Nous pourrions supposer que chaque mode de défaillance peut être modélisé par une distribution unique, par exemple, Weibull, Lognormal. Ensuite, nous pouvons appliquer le célèbre taux d'échec de la baignoire .
Ce n'est pas si facile non plus. Il est surprenant de constater au moins deux points de retournement évidents dans l’estimation non paramétrique. L’un dure environ 150 jours et l’autre environ 550 jours. Si le dernier divise les prévisibles et les imprévisibles, le premier tournant nous indique-t-il que nous pouvons classer les défaillances imprévisibles en plusieurs modes?
En supposant que nous considérions le point tournant autour de 550 jours comme le lieu où les défaillances sont devenues plus prévisibles, il est surprenant que les défaillances se développent progressivement plus rapidement avant ce point. N'est-ce pas contre-intuitif? Je m'attendrais à ce que les défaillances inattendues ralentissent, conformément à ce que nous devrions attendre du phénomène du taux d'échec de la baignoire.
Avant d’approfondir, je souhaite jeter un coup d’œil sur les statistiques SMART des données. J'ai choisi de regarder la statistique SMART 187, car elle est mise en évidence dans un article de blog de Backblaze. Disque dur SMART Stats , une des variables les plus prometteuses pour décider si un disque dur doit être remplacé.
J'ai créé un simple diagramme de dispersion des valeurs brutes SMART 187 par rapport à l'âge des disques durs lorsque les valeurs SMART 187 correspondantes ont été enregistrées. Le panneau de gauche dessine un diagramme de dispersion pour les bons disques durs qui n'ont pas échoué lors de leurs derniers enregistrements. Le panneau de droite trace un diagramme de dispersion des disques durs en panne. Selon les explications sur Disque dur SMART Stats , les différences entre les deux graphiques sont attendues, c’est-à-dire que les valeurs de SMART 187 dans les panneaux de droite semblent être plus grandes que celles du panneau de gauche. Cela correspond à l'affirmation selon laquelle plus la valeur SMART 187 est élevée, plus le disque dur est susceptible de tomber en panne.
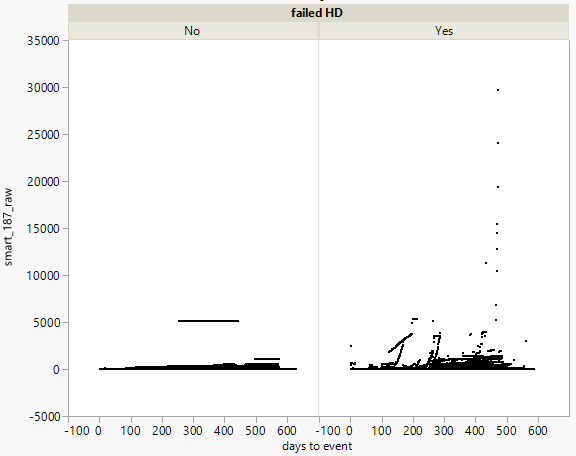
Pas de surprises difficiles à comprendre jusqu'à présent. Bien. Mais ce sont probablement des faits bien connus. Maintenant quoi? Nous ne pouvons pas avoir peur de nous salir les mains, je suppose.
À suivre…
