Die QbD-Säule: Robustheit mit stochastischen Emulatoren erreichenAnmerkung der Redaktion: Dieser Beitrag ist von @ronkenett , Anat Reiner-Benaim und @david_s des KPA-Gruppe . Es ist Teil einer Reihe von Blogbeiträgen mit dem Titel Die QbD-Spalte . Für weitere Informationen zu den Autoren klicken Sie oben auf die Community-Namen der Autoren.
 Ron KenettRon KenettRon KenettRon KenettRon Kenett
 David SteinbergDavid SteinbergDavid SteinbergDavid Steinberg David Steinberg
 Anat Reiner-BenaimAnat Reiner-BenaimAnat Reiner-BenaimAnat Reiner-Benaim Anat Reiner-Benaim
In einer früheren Folge von Die QbD-Spalte betitelt Ein QbD-Faktorexperiment haben wir eine Fallstudie beschrieben, in der der Schwerpunkt auf der Modellierung der Auswirkung von drei Prozessfaktoren auf eine Reaktion, die Viskosität, lag. Hier erweitern wir diese Fallstudie, um zu zeigen, wie Prozessparameter eines Produkts optimiert werden können, indem acht Antworten berücksichtigt und sowohl deren Zielwerte als auch die Variabilität bei der Erreichung dieser Ziele berücksichtigt werden. Wir wenden einen stochastischen Emulatoransatz an, der erstmals in vorgeschlagen wurde Bates et al., 2006 , um eine robuste Zielleistung zu erreichen. Dies bietet zusätzliche Einblicke in die Einrichtung von Produkt- und Prozessfaktoren innerhalb eines Designraums.
Eine Fallstudie mit acht Antworten und drei Prozessfaktoren
Die Fallstudie bezieht sich auf die Formulierung eines generischen Produkts, das mithilfe von In-vitro-Tests den Eigenschaften einer bestehenden Marke entsprechen soll. Die In-vitro-Freisetzung ist eine von mehreren Standardmethoden zur Charakterisierung der Leistung einer fertigen topischen Dosierungsform (Einzelheiten siehe SUPAC, 1977).
Das In-vitro-Freisetzungstestgerät verfügt über sechs Zellen, in denen das getestete Generikum mit dem Markenprodukt verglichen wird. Ein 90 %-Konfidenzintervall für das Verhältnis der mittleren In-vitro-Freisetzungsrate bei Generika und Markenprodukten wird berechnet und als Prozentsatz ausgedrückt. Liegt das Intervall innerhalb der Grenzen von 75 % bis 133,33 %, gelten Generikum und Markenprodukt als gleichwertig.
Die acht im SUPAC-Standard aufgeführten Antworten, die bei der Einrichtung des Designraums für Bioäquivalenzprozesse berücksichtigt werden, sind:
- Bestimmung des Wirkstoffs
- Untere Vertrauensgrenze der In-vitro-Freisetzungsrate
- Obere Vertrauensgrenze der In-vitro-Freisetzungsrate
- 90. Perzentil der Partikelgröße
- Analyse von Material A
- Analyse von Material B
- Viskosität
- pH-Werte
Dabei werden drei Prozessfaktoren berücksichtigt:
- Reaktionstemperatur
- Mischzeit
- Kühlzeit
Der Versuchsaufbau bestand aus einem 2 3 Faktorielles Experiment mit zwei Mittelpunkten. Die experimentelle Anordnung und die acht Antworten sind in Abbildung 1 dargestellt.
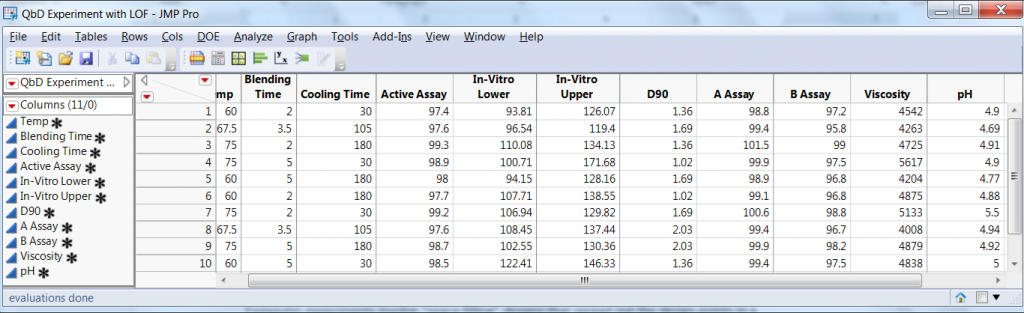
Abbildung 1: Experimentelle Anordnung und acht Reaktionen im QbD-Steroidlotion-Experiment
Anpassen eines Modells mit Haupteffekten und Wechselwirkungen an die drei Prozessfaktoren
Abbildung 2 zeigt das Modell, das wir an die Daten angepasst haben. Es umfasste Haupteffekte für jeden der drei Faktoren und alle Zwei-Faktor-Wechselwirkungen. Wir haben für alle Antworten das gleiche Modell verwendet.
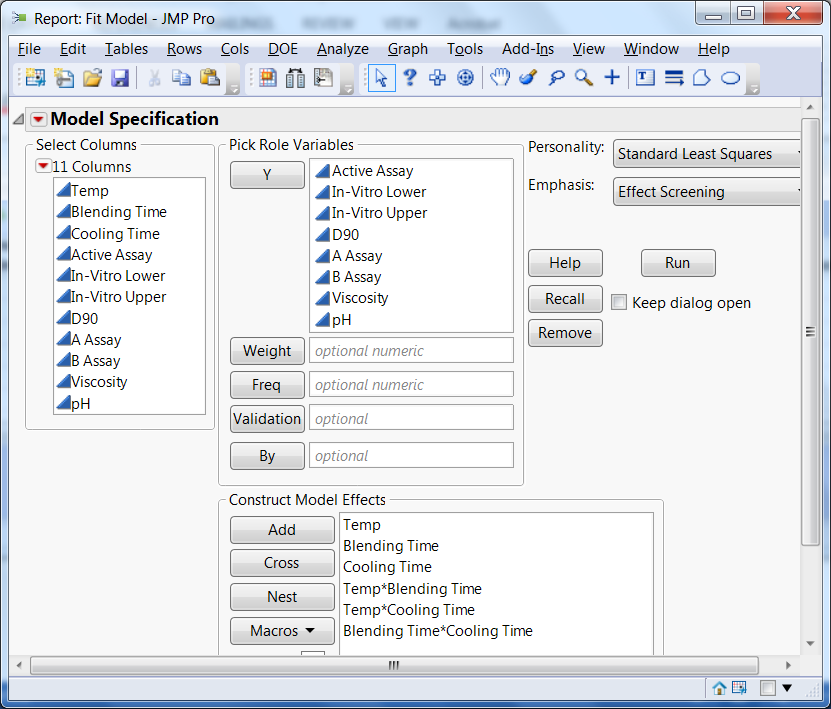
Abbildung 2: Modell, das zur Anpassung der experimentellen QbD-Daten aller acht Antworten verwendet wurde
Betriebsbedingungen mit dem Profiler beurteilen
Das Design orientierte sich an der aktuellen „besten Schätzung“ für die Betriebsbedingungen mit einer Temperatur von 67,5, einer Mischzeit von 3,5 und einer Abkühlzeit von 105. Die angepassten Modelle mit diesen Werten ergeben einen Gesamterwünschtheitsindex von 0,30 (eine Beschreibung der Erwünschtheitsfunktionen finden Sie im zweiten Blogbeitrag unserer QbD-Reihe mit dem Titel Ein QbD-Faktorexperiment ). Die resultierende Lösung erhöht die Temperatur auf 75, reduziert die Mischzeit auf 2 und stellt die Abkühlzeit auf 113,1 ein, mit einem wünschenswerten Wert von 0,54. Insgesamt ist es unser Ziel, die Fehlerquoten zu senken.
Wenn die Produktionskapazität es uns ermöglichen würde, die Faktorstufen mit hoher Präzision festzulegen, wäre die obige Lösung eine gute Lösung. Allerdings gibt es immer eine gewisse Unsicherheit in den Produktionsumgebungen, was zu entsprechenden Schwankungen bei den Prozessergebnissen führt. Wir untersuchen nun die Auswirkung dieser Unsicherheit, indem wir Computersimulationen verwenden, um die Variation der Designfaktoren widerzuspiegeln. Wir verwenden die Option „Simulator“, die im Profiler verfügbar ist JMP .
Der Simulator öffnet Eingabevorlagen für jeden experimentellen Faktor und für jede Antwort, in denen wir die Art der Variation beschreiben. Beispielsweise stellen wir die Temperatur so ein, dass sie mit einer Normalverteilung und einer Standardabweichung von 3 Grad um ihren Nominalwert schwankt. Durch die Beschreibung der Variation in den Ausgaben können wir die natürliche Variation der Ausgabewerte um den erwarteten Wert des Modells widerspiegeln. Die Standardabweichungen für die Ausgaben könnten die verbleibenden Standardabweichungen aus der Anpassung der Modelle sein. Durch Klicken auf die Schaltfläche „Simulieren“ werden für jede Ausgabe Daten generiert, die für typische Ergebnisse in der regulären Produktion charakteristisch sind.
Abbildung 3 (unten) zeigt simulierte Ergebnisse basierend auf unserem QbD-Experiment, wenn alle Faktoren auf ihre Mittelwerte eingestellt sind. Die Zusammenfassung zeigt auch, dass mehr als 80 % der simulierten Ergebnisse nicht den Prozessanforderungen entsprechen und dass diese „Out-of-Spec“-Probleme alle auf eine zu hohe In-vitro-Konfidenzgrenze zurückzuführen sind.
Die Ergebnisse in Abbildung 3 zeigen, dass der Mittelpunkt keinen guten Betriebszustand aufweist und ein hoher Anteil der Produktion außerhalb der Spezifikation liegt. Wenn Sie die Einstellungen verschieben, um die Erwünschtheit zu maximieren, wird der Prozentsatz außerhalb der Spezifikation auf 18 % reduziert.
Mit dem Simulator bessere Betriebsbedingungen finden
Wir gehen nun einen weiteren Schritt und zeigen, wie man mit dem Simulator robuste Betriebsbedingungen findet, die eine hohe Erwünschtheit aufrechterhalten und außerdem den Prozentsatz außerhalb der Spezifikation reduzieren. Dies kann direkt mit dem Profiler erfolgen, indem die Betriebsbedingungen mit den Schiebereglern verschoben und die Ergebnisse auf Erwünschtheit und Fehlerquote beobachtet werden. Wir stellen hier einen viel systematischeren Ansatz vor, der auf einem „Computerexperiment“ basiert, um die Fehlerrate über den Faktorraum zu modellieren.
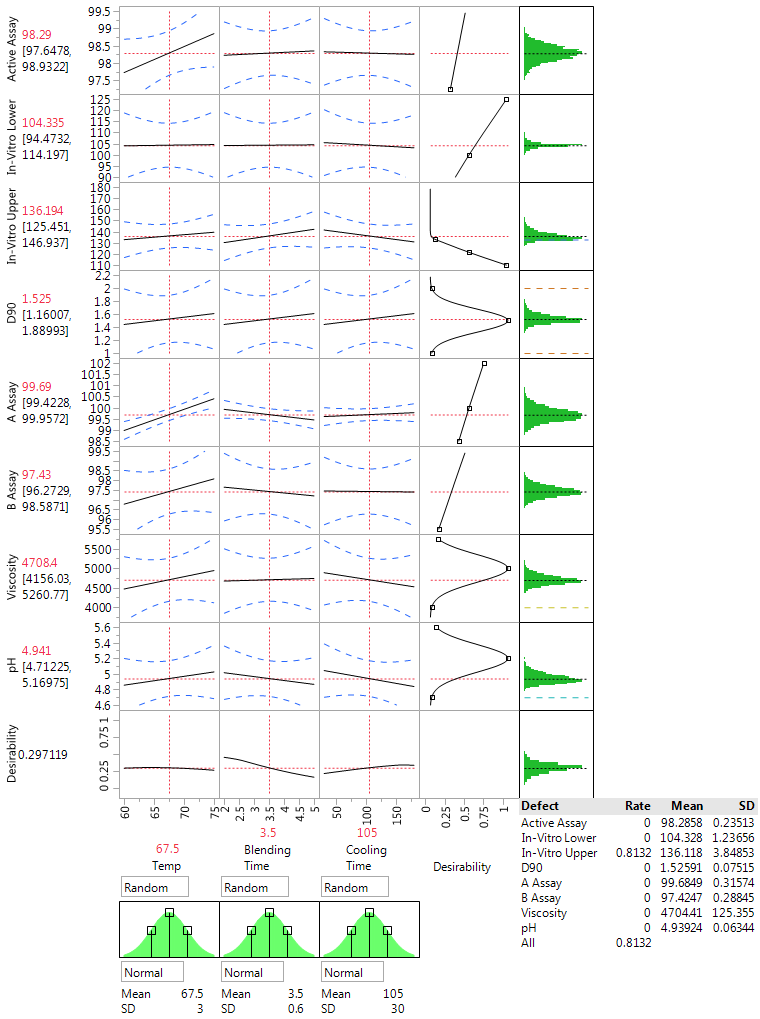
Abbildung 3: Bewertung der Produktion am Mittelpunkt des QbD-Steroidlotion-Experiments mit dem JMP Profiler und der Simulatoroption
Durchführung von Experimenten am Computer
Mit der Simulatoroption im JMP Profiler können wir Betriebsbedingungen anhand computergenerierter Werte vergleichen, die die natürliche Produktionsschwankung der Zieleinstellungen für die Designfaktoren darstellen. Wir setzen unsere Studie fort und untersuchen, wie sich die Faktoren auf die Produktion auswirken, indem wir eine Reihe von Punkten im Faktorraum auswählen, an denen diese Bewertungen vorgenommen werden sollen.
Solche Computerexperimente verwenden im Gegensatz zu physikalischen Experimenten typischerweise „raumfüllende“ Designs, die die Designpunkte mehr oder weniger gleichmäßig verteilen. Ein weiteres Merkmal solcher Experimente besteht darin, dass die Daten keine experimentellen Fehler beinhalten, da eine erneute Durchführung der Analyse am angepassten Modell an denselben Entwurfspunkten dieselben Ergebnisse reproduzieren wird.
Bei der Modellierung von Daten aus Computerexperimenten werden unterschiedliche Ansätze verwendet, wobei Gaußsche Prozessmodelle (auch Kriging-Modelle genannt) am beliebtesten sind. Eine wichtige Veröffentlichung auf diesem Gebiet ist Sacks et al. (1989), der den Begriff Design und Analyse von Computerexperimenten (DACE) prägte.
Bewertung der QbD-Studie durch ein Computerexperiment
Unser Computerexperiment für die Formulierungsexperimente verwendete ein raumfüllendes Design mit 128 Durchläufen in den drei experimentellen Faktoren (das von JMP vorgeschlagene Standarddesign). Bei jeder dieser Faktoreinstellungen wird die Produktionsvariabilität simuliert, was zu computergenerierten Antworten führt, wie in Abbildung 3 dargestellt. Schlüsselindikatoren werden verwendet, um die Antworten bei jeder Einstellung zusammenzufassen. Anschließend modellieren wir die Schlüsselindikatoren, um zu sehen, wie sie sich auf die Faktoreinstellungen auswirken, und um optimale Einstellungen vorzuschlagen. Hier konzentrieren wir unsere Analyse darauf, eine hohe Erwünschtheit und eine niedrige Fehlerrate zu erreichen.
Optimierung der Erwünschtheit von Leistung und Fehlerraten
Die Maximierung der Gesamterwünschtheit führt, wie zuvor gezeigt, zu einer neuen Konfiguration der Prozessfaktoren (Temp=75, Mischzeit=2, Abkühlzeit=113,1) mit einer Gesamterwünschtheit von 0,54 und einer Gesamtfehlerrate von 0,18. Ein raumfüllendes 128-Punkte-Experiment mit dem Modell ohne zusätzliche Fehler in den Antworten ergab die in Abbildung 4 gezeigten Daten.
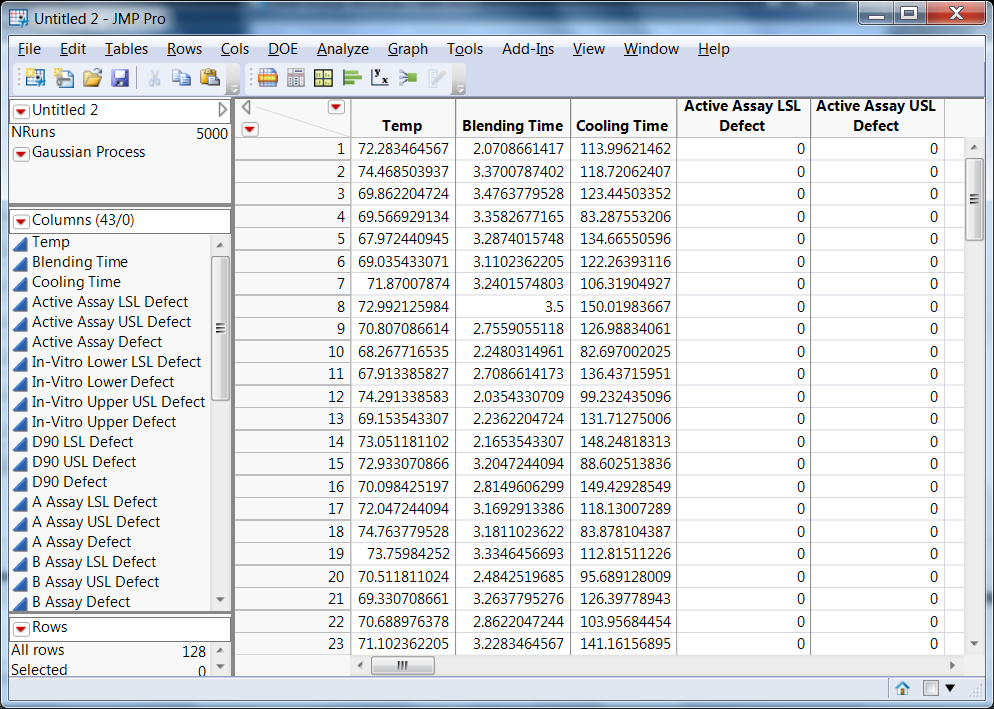
Abbildung 4: Ergebnisse von raumfüllenden simulierten Experimenten unter Verwendung eines Modells, das zur Anpassung der experimentellen Daten der QbD-Steroidlotion (der stochastischen Emulatordaten) verwendet wurde.
Das von JMP automatisch generierte Gaußsche Prozessmodell ist ein natürliches Werkzeug zur Datenanalyse und wird in der Datentabelle der Ergebnisse des Computerexperiments geöffnet. Das angepasste Modell stellt einen Emulator der Fehlerrate bereit, die sich aus der Hinzufügung von Produktionsrauschen zu den Faktoreinstellungen des ursprünglichen Modells ergibt, das an die Daten angepasst wurde. Da bei einer Fehlerrate „Minimum“ am besten ist, führt die Optimierung dieses Emulatormodells dazu, dass ein Profiler auf Werte eingestellt wird, die die Fehlerraten minimieren. Um diese vorgeschlagenen Werte auf den Profiler des in Abbildung 3 gezeigten Originalmodells anzuwenden, müssen die Profile in den Faktoreinstellungsoptionen verknüpft werden. In Abbildung 5 präsentieren wir den optimierten Profiler für die Fehlerrate unter Verwendung des Gaußschen Modells zur Anpassung des stochastischen Emulatormodells, das aus Daten abgeleitet wurde, die aus dem ursprünglichen QbD-Modell generiert wurden.

Abbildung 5: Optimierter Vorhersageprofiler (Minimierung der Fehlerrate) von stochastischen Emulatordaten.
Der stochastische Emulator
Die obige Optimierungs- und Robustheitsanalyse folgt dem von Bates et al. vorgeschlagenen „stochastischen Emulator“-Ansatz. (2006). Der Ansatz ist immer dann nützlich, wenn es ein Modell gibt, das Input-Output-Beziehungen beschreiben und Variabilitätsquellen charakterisieren kann. Die Analyse kann dann zur Optimierung einer Reaktion verwendet werden, indem sowohl ihre Zielwerte als auch ihre Variabilität berücksichtigt werden. Der stochastische Emulator wird zur Modellierung der Variabilität in den Daten verwendet und ermöglicht uns in Kombination mit der Optimierung einer Modellanpassung an die physikalischen Experimente, bestmöglich sowohl eine zielgerichtete Leistung als auch eine minimale Variabilität sicherzustellen. Die wichtigsten Schritte des stochastischen Emulatoransatzes sind wie folgt:
- Beginnen Sie mit einem Modell, das die Inputfaktoren mit den Systemoutputs in Beziehung setzt. Das Modell könnte aus den Ergebnissen eines ersten Laborexperiments abgeleitet werden, wie in unserem Beispiel hier, oder es könnte auf rein theoretischen Grundlagen aus der Grundlagenwissenschaft des Systems abgeleitet werden.
- Charakterisieren Sie die Unsicherheit im System. Beschreiben Sie, wie sich die Eingabefaktoren voraussichtlich von ihren nominalen Prozesseinstellungen unterscheiden. Die entsprechenden Verteilungen werden aufgerufen Lärmverteilungen für die Inputfaktoren. Beschreiben Sie das Ausmaß der Ausgabeschwankung der aus dem Modell berechneten Werte.
- Entwerfen Sie in den Eingabefaktoren einen Versuchsplan, der mögliche Nenneinstellungen beschreibt. Wie bereits erwähnt, sind raumfüllende Designs hier die beliebteste Wahl.
- Generieren Sie simulierte Daten aus den Geräuschverteilungen bei allen Nenneinstellungen im raumfüllenden Design.
- Fassen Sie die simulierten Daten bei jeder Nenneinstellung nach kritischen Antwortvariablen zusammen (wie Erwünschtheit und Fehlerrate in unserer Studie).
- Erstellen Sie mithilfe der Gaußschen Prozessmodelloption in JMP statistische Modelle, die kritische Antwortvariablen mit den Designfaktoreinstellungen in Beziehung setzen.
- Optimieren Sie die Auswahl der Faktoreinstellungen für alle kritischen Ergebnisse. Hier möchten wir, dass der Prozess sowohl die Zielleistung als auch die Robustheit erreicht (JMP ermöglicht uns dies durch die Verknüpfung und Optimierung von Profilern).
Einige abschließende Bemerkungen
Wenn wir die Simulation des Rauschens in den Designfaktoren (Abbildung 3) bei den in Abbildung 5 erreichten Sollwerten (Temp=75, Mischzeit=2, Abkühlzeit=150,6) durchführen, erreichen wir eine Gesamterwünschtheit von 0,53 und a Fehlerquote von 0,09. Dieses Setup ist etwas schlechter als das Setup, das nur auf die Leistung im Vergleich zum Ziel optimiert ist, aber im Hinblick auf die Robustheit deutlich besser.
Abbildung 5 zeigt die Möglichkeit einer weiteren Reduzierung der Fehlerrate, indem die Temperatur und die Abkühlzeit auf höhere Werte und die Mischzeit auf niedrigere Werte verschoben werden. Wir haben die Faktorbereiche in unserem Computerexperiment so eingestellt, dass sie mit denen im Experiment übereinstimmen (jedoch beschränkt auf Werte zwischen dem ursprünglichen Betriebsvorschlag und dem extremen experimentellen Niveau in der Richtung, die wir für die Robustheit am besten fanden). Wir wollten keine Vorhersagen außerhalb des experimentellen Bereichs treffen, wo unsere empirischen Modelle möglicherweise nicht mehr genau sind. Im Zusammenhang mit QbD-Arzneimittelanwendungen ist eine Extrapolation außerhalb des experimentellen Bereichs nicht akzeptabel.
In solchen Fällen ist es oft sinnvoll, weitere Experimente durchzuführen, um vielversprechende Regionen zu erkunden. Eine Erweiterung der Faktorbereiche in die oben genannten Richtungen würde es uns ermöglichen, die Reaktionen dort zu modellieren und die Auswirkungen weiterer Änderungen auf die Robustheit zu bewerten. Bei dieser Anwendung erzielte das Projektteam eine deutliche Verbesserung und entschied sich, das Experiment nicht fortzusetzen. In zukünftigen Blogbeiträgen werden wir die Vorteile der Einbeziehung mehrerer Phasen in das QbD-Experimentsprogramm veranschaulichen.
Stochastische Emulatoren sind ein primäres Quality-by-Design-Tool, das natürlich Simulationsexperimente in die Entwicklung von Arzneimittelprodukten, Analysemethoden und Scale-up-Prozessen einbezieht. (Weitere Informationen zu Computerexperimenten und stochastischen Emulatoren finden Sie bei Santner et al., 2004; Steinberg und Kenett, 2006; Levy und Steinberg, 2010; Kenett und Zacks, 2014.) Weitere Beispiele für solche Experimente im Kontext des generischen Produktdesigns finden Sie bei Arnon (2012, 2014).
In diesem Blogbeitrag haben wir gezeigt, wie eine Kombination aus physikalischen vollfaktoriellen Experimenten mit einem stochastischen Emulator zu einem robusten Aufbau innerhalb eines Designraums führt.
Kommende Attraktion
Der nächste Blogbeitrag widmet sich Mischungsexperimenten und Zusammensetzungsdaten, wobei das Hauptinteresse auf den relativen Werten einer Reihe von Komponenten liegt (die sich normalerweise zu 100 % addieren), sodass die Faktoren nicht unabhängig voneinander geändert werden können.
Verweise
- Arnon, M, (2012), Wesentliche Aspekte in den Fallstudien ACE und ANDA IR QbD,
- Die 4. Jerusalemer Konferenz über Quality by Design (QbD) und Pharmawissenschaften, Jerusalem, Israel, http://ce.pharmacy.wisc.edu/courseinfo/archive/2012Israel/
- Arnon, M. (2014). QbD in erweiterten Themen Perrigo Israel Pharmaceuticals, die 4. Jerusalemer Konferenz über Quality by Design (QbD) und Pharmawissenschaften, Jerusalem, Israel. https://medicine.ekmd.huji.ac.il/schools/pharmacy/En/home/news/Pages/QbD2014.aspx
- Bates, R., Kenett RS, Steinberg DM und Wynn, H. (2006). Erzielen eines robusten Designs durch Computersimulationen. Qualitätstechnologie und quantitatives Management, Bd. 3, Nr. 2, S. 161–177.
- Kenett, RS und Steinberg, DM (2006). Neue Grenzen in der Versuchsplanung, Quality Progress, S. 61-65, August.
- Kenett, RS und Zacks, S. (2014). Moderne Industriestatistik: mit Anwendungen in R, MINITAB und JMP, John Wiley and Sons.
- Levy, S. und Steinberg, DM (2010). Computerexperimente: eine Rezension. ASTA – Fortschritte in der statistischen Analyse, 94, 311-324.
- Sacks, J., Welch, WJ, Mitchell, TJ und Wynn, HP (1989). Design und Analyse von Computerexperimenten. Statistische Wissenschaft, 4, 409-435.
- Santner, TJ, Williams, BJ und Notz, WL (2004). Das Design und die Analyse von Computerexperimenten, Springer, New York, NY.
- SUPAC (1997) Food and Drug Administration, Center for Drug Evaluation and Research (CDER) Scale-up und Änderungen nach der Zulassung: Chemie, Herstellung und Kontrollen; In-vitro-Freisetzungstests und In-vivo-Bioäquivalenzdokumentation, Rockville, MD, USA.
Hier zeigen wir, wie man Prozessparameter eines Produkts optimieren kann.
Michael Clayton hat geschrieben: Danke. Ich freue mich auf die Mischung ...Michael Clayton schrieb:
Danke. Ich freue mich auf den Mischungsartikel....
Ich habe diesen Profiler in der Halbleiterindustrie verwendet, um ihn vor einem gemischten Publikum von Managern zu präsentieren, und er maximiert die „Aha“-Effekte, wenn versucht wird zu zeigen, warum OFATs böse sind.
