La recreación de gráficos es un pasatiempo mío. Me ayuda a probar los límites de JMP y agudiza mis propias habilidades de manejo y visualización de datos. Esta vez, hubo un tercer beneficio: encontrar un error de datos significativo en el gráfico publicado.
Hace poco vi este interesante cuadro de tendencias de mosquitos como parte de un artículo, " Cuando los mosquitos estarán picando en tu estado. ", En el blog Wonk del Washington Post. Muestra las tendencias de búsqueda de Google para la palabra "mosquito" por estado, con cada estado en una escala diferente.
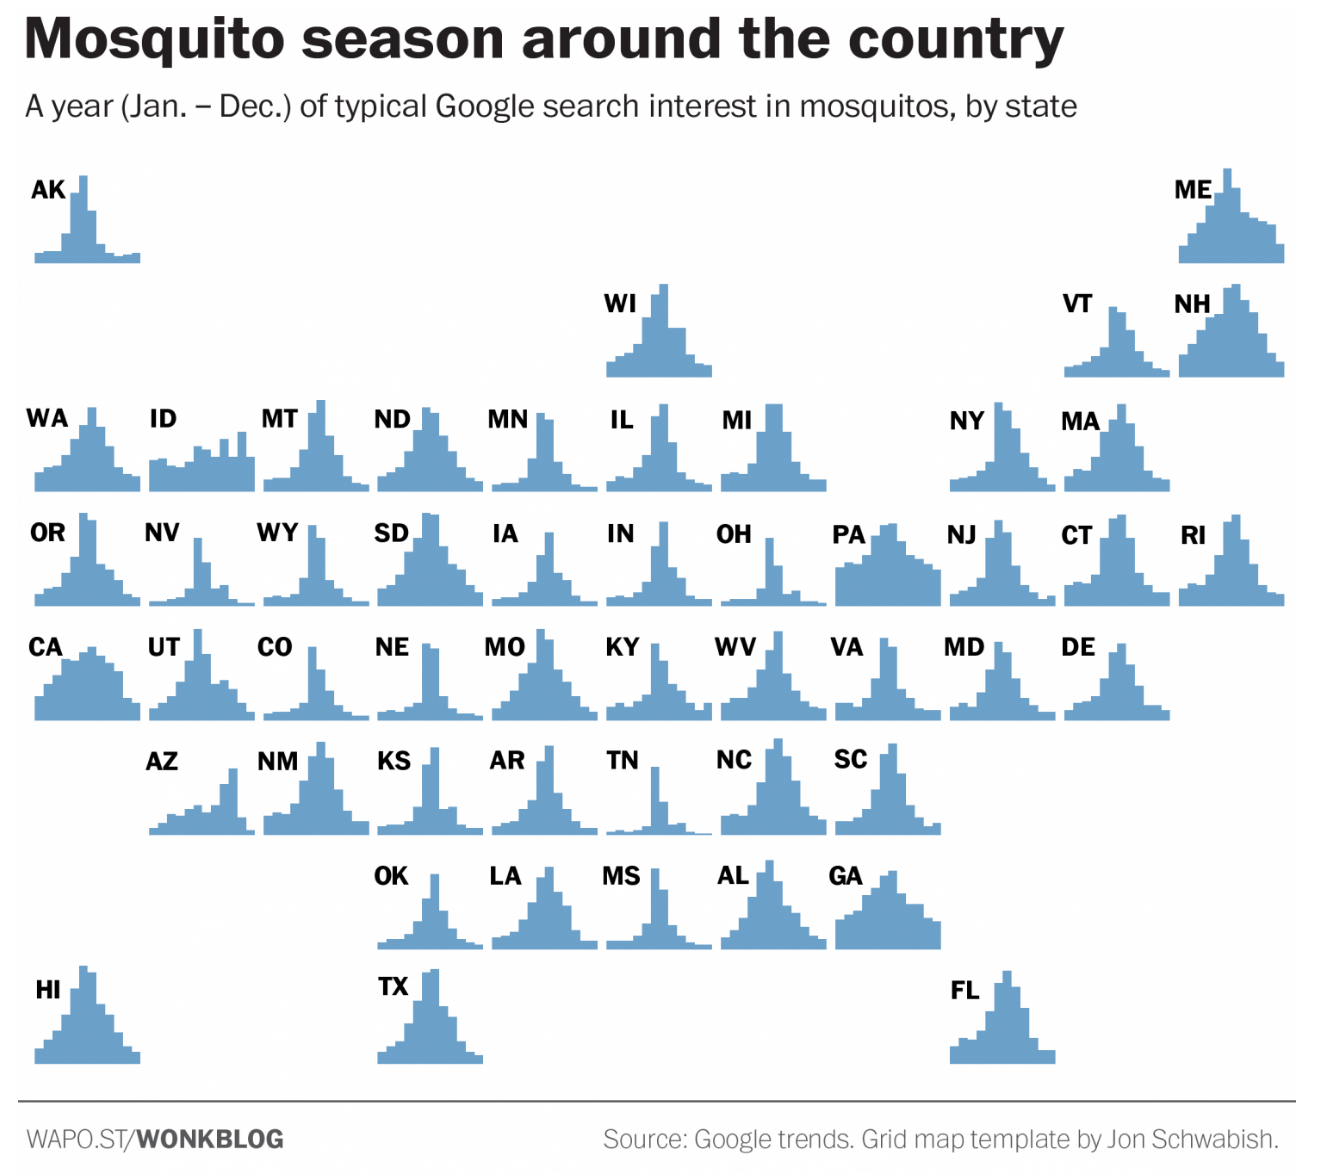
No es un gráfico analítico típico, pero pensé que el diseño sería una buena prueba de la agrupación de múltiplos pequeños de Graph Builder, y me intrigó la falta general de patrón geográfico. Por ejemplo, el artículo mencionó que Tennessee es tan diferente a sus vecinos, y lo mismo puede decirse de otros estados. El punto principal de usar un mapa es mostrar patrones geográficos, pero las conexiones son bastante débiles aquí.
Obteniendo los datos
El artículo incluye un enlace a la página de Google Trends para tendencias de los mosquitos para todo Estados Unidos, y esa página tiene un bonito Descargar como CSV opción del menú.
Sin embargo, ahí es donde termina la amabilidad para obtener los datos. Cada tendencia de estado se encuentra en una página separada, no hay una URL separada para la descarga y el archivo CSV no es realmente un archivo CSV puro. Al menos las URL del estado seguían un patrón, por lo que escribí un script para abrir cada estado en una pestaña separada en un navegador web. Entonces tuve que hacer clic manualmente en el Descargar como CSV Elemento de menú para cada pestaña. Cada "CSV" siguió un patrón regular que incluía texto descriptivo y varias tablas incrustadas. Un fragmento de ejemplo:
Web Search interest: Mosquito

Wisconsin (United States) 2014-2015
Interest over time
Week,Mosquito
2014-01-05 - 2014-01-11,4
2014-01-12 - 2014-01-18,3
2014-01-19 - 2014-01-25,4
...
2015-12-27 - 2016-01-02,4

Top metros for Mosquito
Metro,Mosquito
Duluth MN-Superior WI,100
Wausau-Rhinelander WI,85
Afortunadamente, el asistente de importación de texto de JMP me permite decirle cuántas líneas omitir y cuántas leer. Después de hacerlo una vez en el asistente, miré el script generado y pude ponerlo en un bucle para leer los otros archivos de la misma manera:
Open( "report (" || Char(i) || ").csv",
   Columns( Column( "Week", Character), Column( "Mosquito") ),
   Import Settings( Column Names Start( 5 ),
      Data Starts( 6 ), Lines To Read( 104 ) )
);
Después de hacer todo eso y dividir el primer campo en fechas de inicio y finalización separadas, pude concatenar toda la tabla en una tabla grande que contiene todos los datos del estado, que son dos años de datos semanales.
Primer vistazo a los datos
Podemos ver todos los datos bastante bien en este pequeño gráfico de líneas de múltiplos superpuestos por año.

No tenemos la disposición geográfica, pero ya podemos ver lo suficiente como para comparar con el original, y dos características destacaron para mí:
- A veces los años eran bastante diferentes dentro de un estado (especialmente Arizona y Hawai).
- Tennessee no tiene el pincho del original.
La primera observación sugiere que probablemente necesitemos más años de datos para establecer lo que el artículo denomina un año "típico", y aún no lo he logrado. El segundo artículo fue más de un misterio. Inicialmente pensé que era un artefacto del compartimiento, ya que el gráfico original muestra los datos por mes en lugar de por semana, pero eso no se mantuvo al mirar los datos más de cerca. Revisé dos veces mi gráfico con la página de Tendencias de Google para Tennessee, y aceptaron. Continué, esperando descubrir el origen de la discrepancia.
Organizando los estados
El gráfico anterior utiliza la función de ajuste de grupo en Graph Builder para diseñar los estados en una cuadrícula alfabéticamente. Para un control completo, asigné a cada estado un valor de fila y columna y utilicé esos valores en los roles Grupo Y y Grupo X.

En un esfuerzo por aproximar el gráfico original, cambié de las líneas superpuestas a los gráficos de área suavizados. (No hice barras porque todavía no he intentado convertir semanas a meses, o tal vez haya una manera de obtener datos mensuales de Google Trends). Fue suficiente para notar que algunos de mis estados se parecían a otros estados en el original. El Tennessee y Ohio originales se parecen mucho a mis Dakota del Sur y Dakota del Norte; El Pennsylvania original se parece mucho a mi Oregon. Por suerte, se me ocurrió un patrón. ¡Los estados del gráfico original están desactivados por uno alfabéticamente!
Casi, de todos modos. Después de estudiar más, me di cuenta sólo de los estados después Distrito de Columbia estaban fuera por uno. Nuestras cartas acordaron en los otros estados. Casualmente, también tuve un error similar en mis datos donde había descargado los datos de DC dos veces, y mis gráficos iniciales estaban desactivados en uno antes de CORRIENTE CONTINUA. Extraño. Despues de algunos Mensajes de Twitter , el autor confirmó mis hallazgos y actualizó rápidamente el gráfico y el comentario de la publicación de Wonk Blog.
Escalando los datos
En los datos de Google Trends, los niveles de interés de cada estado se escalan, por lo que el valor máximo es 100. Eso significa que las magnitudes no son comparables de un estado a otro como se esperaría con un pequeño cuadro de múltiplos. En este caso, solo se pueden comparar los patrones (p. Ej., Pinchos).
¿Cómo podría convertir los datos de estado para que estén en la misma escala? La página de Tendencias de Google para todo Estados Unidos incluye una lista de niveles de resumen para cada estado. Si esos resúmenes representan el valor promedio de cada estado, podemos hacer el ajuste con un factor de escala. Aquí está el resultado con todos los estados en una escala común.

Note que también usé un diseño de estado diferente de mi propio diseño, tratando de darle a mi estado natal de Carolina del Norte un posicionamiento más verdadero. Dentro de las restricciones de los rectángulos de igual tamaño, es imposible preservar todas las propiedades geográficas. El diseño en la tabla original es de Jon Schwabish en PolicyViz y tiene la bonita propiedad de que la forma general se asemeja a la forma general del país.
Dada la delgadez de muchas de las curvas, agregué un color de fondo basado en el valor promedio del estado, que además de permitir una visión general del patrón anual, ayuda a anclar las áreas en sus celdas y hacer que el etiquetado sea claro.

Perspectivas obtenidas
Aunque el artículo del Blog de Wonk deja en claro que los datos de Google Trends pueden no ser representativos de las tendencias del mundo real, al rehacer el análisis obtuve algunas ideas que no pude obtener del artículo y el gráfico original:
- Algunos estados tienen una variación significativa de año a año.
- La agregación mensual frente a la semanal puede ser un problema.
- Los datos de estado se normalizaron por el valor máximo.
- Los picos de Dakota son realmente altos (si mi escalado es correcto)
Me doy cuenta de que no siempre es práctico hacer nuestros propios remakes de gráficos y análisis, pero es una excelente manera de entender realmente los matices de los datos.
