Ricreare i grafici è un mio hobby. Entrambi mi aiutano a testare i limiti di JMP e affina le mie capacità di gestione e visualizzazione dei dati. Questa volta, c'è stato un terzo vantaggio: trovare un errore significativo nel grafico pubblicato.
Di recente ho visto questo interessante grafico delle tendenze alle zanzare come parte di un articolo " Quando le zanzare si morderanno nel tuo stato , "Sul blog Wonk del Washington Post. Mostra le tendenze di ricerca di Google per la parola "zanzara" per stato, con ciascuno stato su una scala diversa.
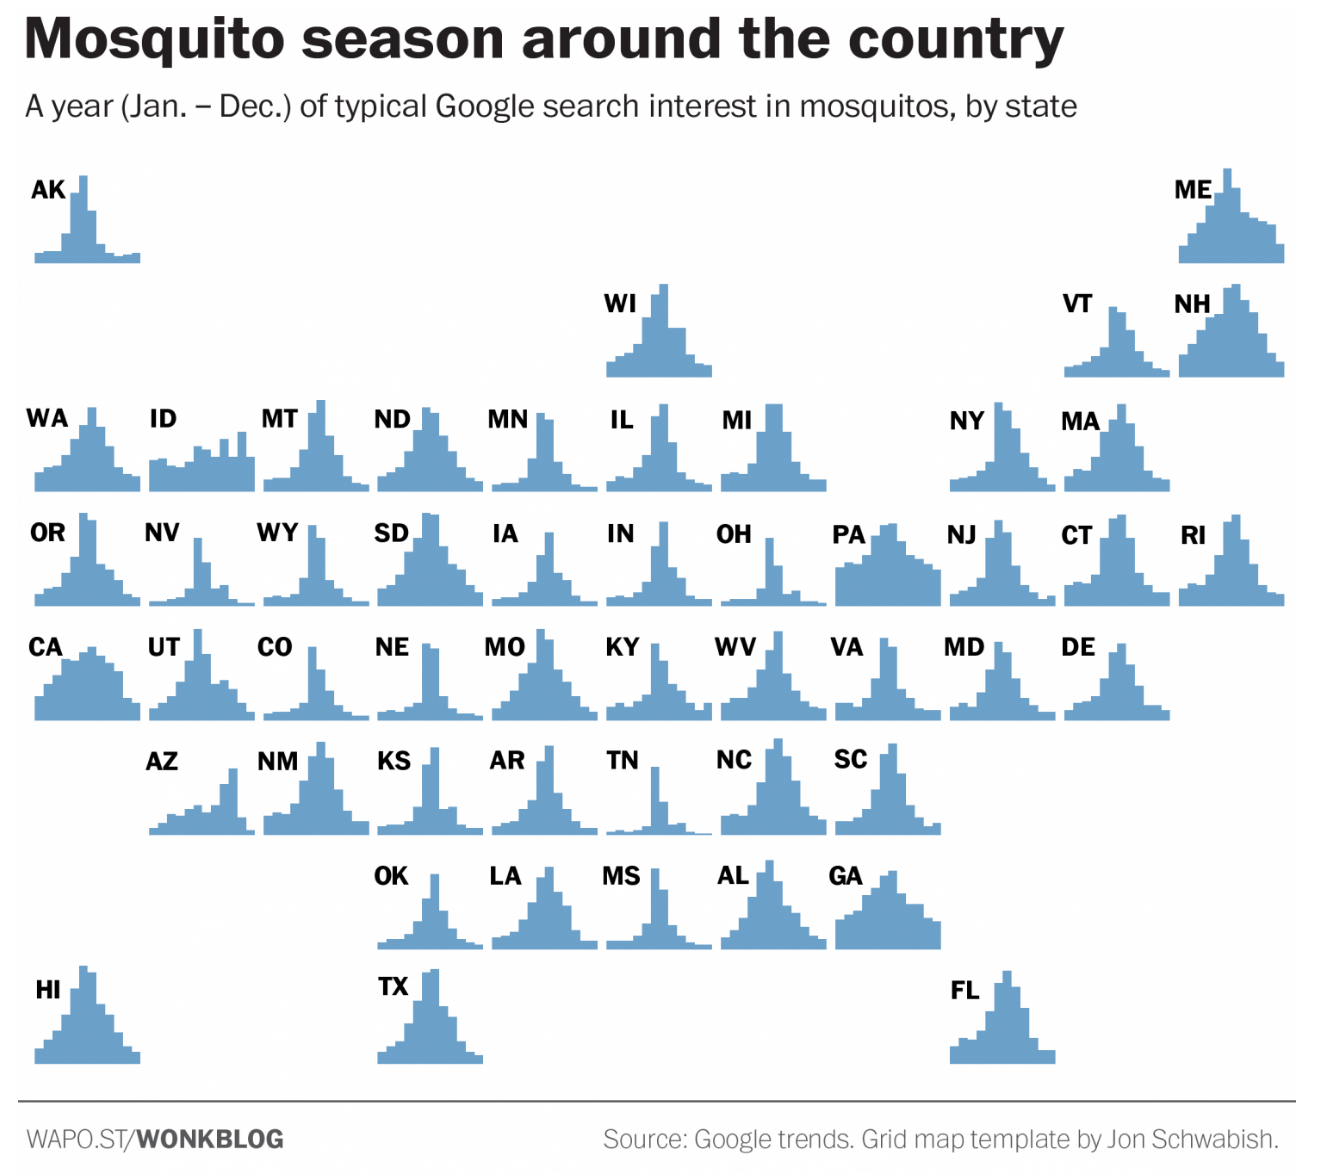
Non è un tipico grafico analitico, ma ho pensato che il layout sarebbe stato un buon test del piccolo raggruppamento di multipli di Graph Builder, e sono rimasto affascinato dalla mancanza generale di pattern geografici. Ad esempio, l'articolo menziona che il Tennessee è così diverso dai suoi vicini, e lo stesso si può dire per gli altri stati. Il punto principale dell'utilizzo di una mappa è rappresentato da modelli geografici, ma le connessioni sono piuttosto deboli.
Ottenere i dati
L'articolo include un link alla pagina di Google Trends per tendenze delle zanzare per tutti gli Stati Uniti, e quella pagina ha benissimo un Scarica come CSV elemento del menu.
Tuttavia, è qui che finisce la bellezza per ottenere i dati. Ogni trend di stato è in una pagina separata, non c'è un URL separato per il download e il file CSV non è in realtà un puro file CSV. Almeno gli URL di stato seguivano uno schema, quindi ho scritto uno script per aprire ciascuno stato in una scheda separata in un browser web. Quindi ho dovuto fare clic manualmente sul Scarica come CSV voce di menu per ogni scheda. Ogni "CSV" seguiva uno schema regolare che includeva alcuni testi descrittivi e più tabelle incorporate. Un esempio di snippet:
Web Search interest: Mosquito

Wisconsin (United States) 2014-2015
Interest over time
Week,Mosquito
2014-01-05 - 2014-01-11,4
2014-01-12 - 2014-01-18,3
2014-01-19 - 2014-01-25,4
...
2015-12-27 - 2016-01-02,4

Top metros for Mosquito
Metro,Mosquito
Duluth MN-Superior WI,100
Wausau-Rhinelander WI,85
Fortunatamente, la procedura guidata per l'importazione di testo di JMP mi ha permesso di dire quante linee saltare e quante leggere. Dopo averlo fatto una volta nella procedura guidata, ho guardato lo script generato ed è stato in grado di metterlo in un loop per leggere gli altri file allo stesso modo:
Open( "report (" || Char(i) || ").csv",
   Columns( Column( "Week", Character), Column( "Mosquito") ),
   Import Settings( Column Names Start( 5 ),
      Data Starts( 6 ), Lines To Read( 104 ) )
);
Dopo aver fatto tutto ciò e diviso il primo campo in date di inizio e fine separate, ho potuto concatenare tutta la tabella in un'unica grande tabella contenente tutti i dati dello stato, ovvero due anni di dati settimanali.
Primo sguardo ai dati
Possiamo vedere tutti i dati abbastanza bene in questo piccolo grafico a linee multiple sovrapposto all'anno.

Non abbiamo la disposizione geografica, ma possiamo già vedere abbastanza da confrontare con l'originale, e due caratteristiche mi hanno colpito:
- A volte gli anni erano abbastanza diversi all'interno di uno stato (specialmente in Arizona e Hawaii).
- Il Tennessee non ha la spigolosità dell'originale.
La prima osservazione suggerisce che probabilmente abbiamo bisogno di più anni di dati per stabilire ciò che l'articolo definisce un anno "tipico", e non l'ho ancora perseguito. Il secondo oggetto era più di un mistero. Inizialmente pensavo che fosse un artefatto del binning dal momento che il grafico originale mostrava i dati per mese invece che per settimana, ma ciò non reggeva mentre guardavo i dati più da vicino. Ho ricontrollato il mio grafico sulla pagina di Google Trends per Tennessee e hanno concordato. Continuai, sperando di scoprire la fonte della discrepanza.
Organizzare gli Stati
Il grafico sopra utilizza il ruolo Group Wrap in Graph Builder per disporre gli stati in una griglia alfabeticamente. Per il controllo completo, ho assegnato a ciascuno stato un valore di riga e di colonna e ho utilizzato tali valori nei ruoli Gruppo Y e Gruppo X.

Nel tentativo di approssimare il grafico originale, sono passato dalle linee sovrapposte a grafici ad area uniformi. (Non ho fatto le barre perché non ho ancora provato a convertire da settimane a mesi - o forse c'è un modo per ottenere dati mensili da Google Trends.) È stato sufficiente notare che alcuni dei miei stati sembravano altri stati nell'originale. Il Tennessee e l'Ohio originali assomigliano molto al mio South Dakota e al North Dakota; la Pennsylvania originale assomiglia molto alla mia Oregon. Fortunatamente, mi è venuto in mente un modello. Gli stati del grafico originale sono disattivati di un ordine alfabetico!
Almeno, comunque. Dopo ulteriori studi, ho realizzato solo gli stati dopo Il distretto di Columbia era fuori di uno. Le nostre carte concordavano sugli altri stati. Per coincidenza, ho avuto anche un errore simile nei miei dati in cui avevo scaricato i dati DC due volte, e i miei grafici iniziali erano fuori da uno prima DC. Strano. Dopo alcuni Messaggi di Twitter , l'autore ha confermato le mie scoperte e ha aggiornato rapidamente il grafico e i commenti del post sul blog di Wonk.
Ridimensionamento dei dati
Nei dati di Google Trends, i livelli di interesse di ogni stato vengono ridimensionati in modo che il valore massimo sia 100. Ciò significa che le grandezze non sono paragonabili da stato a stato, come ci si aspetterebbe da un grafico a piccoli multipli. In questo caso, è possibile confrontare solo gli schemi (ad es. Spikiness).
Come posso convertire i dati di stato nella stessa scala? La pagina Google Trends per gli Stati Uniti comprende un elenco di livelli di riepilogo per ogni stato. Se tali sommari rappresentano il valore medio di ogni stato, possiamo effettuare la regolazione con un fattore di scala. Ecco il risultato con tutti gli stati su una scala comune.

Notate che ho anche usato un diverso layout di stato del mio progetto, cercando di dare al mio stato di residenza della Carolina del Nord un posizionamento più vero. All'interno dei vincoli di rettangoli di uguali dimensioni, è impossibile conservare tutte le proprietà geografiche. Il layout nel grafico originale è di Jon Schwabish a PolicyViz e ha la bella proprietà che la forma complessiva assomiglia alla forma generale del paese.
Data la magrezza di molte delle curve, ho aggiunto un colore di sfondo basato sul valore medio dello stato, che oltre a consentire una visualizzazione di grandi dimensioni del modello annuale, aiuta ad ancorare le aree nelle loro celle e rende chiara l'etichettatura.

Approfondimenti ottenuti
Sebbene l'articolo del blog di Wonk chiarisca che i dati di Google Trends potrebbero non essere rappresentativi di tutte le tendenze del mondo reale, rifacendo l'analisi ho ottenuto alcune informazioni che non ho potuto ottenere dall'articolo e dal grafico originale:
- Alcuni stati hanno variazioni significative anno dopo anno.
- L'aggregazione mensile rispetto a quella settimanale potrebbe essere un problema.
- I dati di stato sono stati normalizzati dal valore massimo.
- I picchi del Dakota sono davvero alti (se il mio ridimensionamento è giusto)
Mi rendo conto che non è sempre pratico fare i nostri rifacimenti di grafici e analisi, ma è un ottimo modo per capire davvero le sfumature dei dati.
