그래프를 재현하는 것은 제 취미입니다. 이 둘은 내가 JMP 내 자신의 데이터 처리 및 시각화 기술을 선명하게합니다. 이번에는 세 번째 이점이 있습니다. 게시 된 차트에서 중요한 데이터 오류를 찾는 것입니다.
나는 최근에 흥미로운 모기 경향 차트를 기사의 일부로 보았습니다. " 모기가 당신의 상태에서 물어 뜯을 때 , "워싱톤 포스트의 Wonk Blog에. 그것은 Google 검색 단어 "모기"에 대한 동향을 보여 주며 각 주마다 규모가 다릅니다.
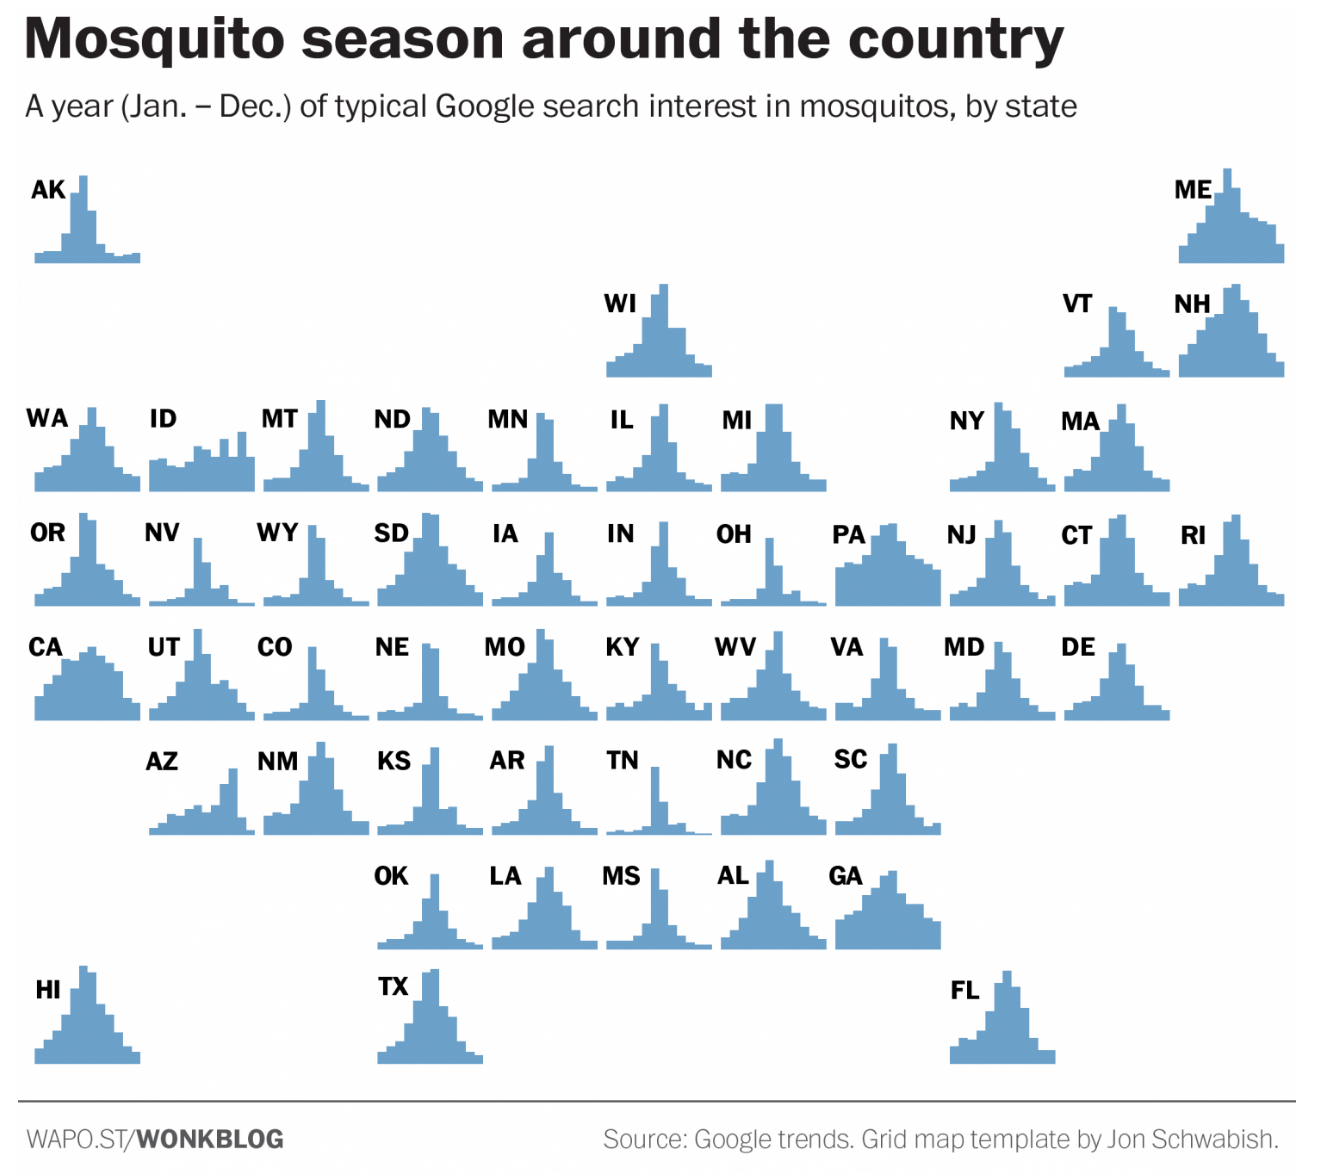
일반적인 분석 그래프는 아니지만 레이아웃이 그래프 빌더의 작은 배수 그룹화에 대한 좋은 테스트 일 것이라고 생각했습니다. 전반적으로 지형 패턴이 부족하여 흥미가있었습니다. 예를 들면, 기사는 테네시가 그 이웃 사람과 그렇게 다르지 않다라고 언급했다. 그리고 같은 것은 다른 주가 말할 수있다. 지도를 사용하는 주된 요점은 지형 패턴을 보여 주지만 연결은 꽤 약합니다.
데이터 가져 오기
기사에는 Google 트렌드 페이지에 대한 링크가 포함되어 있습니다. 모기 동향 미국 전체를 위해, 그리고 그 페이지는 멋지게 CSV로 다운로드 메뉴 아이템.
그러나 이것이 바로 데이터를 가져 오기위한 niceness가 끝나는 곳입니다. 각 주 트렌드는 별도의 페이지에 있으며 다운로드 URL은 별도로 없으며 CSV 파일은 실제로 순수한 CSV 파일이 아닙니다. 최소한 상태 URL은 패턴을 따랐으므로 각 상태를 웹 브라우저의 별도 탭에 열어주는 스크립트를 작성했습니다. 그런 다음 수동으로 CSV로 다운로드 각 탭의 메뉴 항목. 각 "CSV"는 몇 가지 설명 텍스트와 여러 개의 내장 테이블을 포함하는 규칙적인 패턴을 따랐습니다. 예제 스 니펫 :
Web Search interest: Mosquito

Wisconsin (United States) 2014-2015
Interest over time
Week,Mosquito
2014-01-05 - 2014-01-11,4
2014-01-12 - 2014-01-18,3
2014-01-19 - 2014-01-25,4
...
2015-12-27 - 2016-01-02,4

Top metros for Mosquito
Metro,Mosquito
Duluth MN-Superior WI,100
Wausau-Rhinelander WI,85
다행스럽게도 JMP의 텍스트 가져 오기 마법사는 건너 뛸 줄 수와 읽어야 할 줄 수를 알려줍니다. 마법사에서 한 번 수행 한 후, 생성 된 스크립트를보고 루프 내에서 다른 파일을 같은 방식으로 읽을 수있었습니다.
Open( "report (" || Char(i) || ").csv",
   Columns( Column( "Week", Character), Column( "Mosquito") ),
   Import Settings( Column Names Start( 5 ),
      Data Starts( 6 ), Lines To Read( 104 ) )
);
모든 작업을 수행하고 첫 번째 필드를 별도의 시작 날짜와 종료 날짜로 분리 한 후 모든 테이블을 연결하여 주 데이터의 2 년인 모든 주 데이터를 포함하는 하나의 큰 테이블로 연결할 수있었습니다.
데이터를 먼저 살펴보십시오.
우리는이 작은 배수 꺾은 선형 차트에서 모든 데이터를 상당히 잘 볼 수 있습니다.

우리는 지리적 배치가 없지만 원본과 비교할만큼 이미 충분히 볼 수 있으며 두 가지 특징이 두드러졌습니다.
- 때로는 주 (특히 애리조나와 하와이) 내에서 그시기가 상당히 달랐습니다.
- 테네시는 원본의 뾰족 함이 없습니다.
첫 번째 관찰은 문서가 "전형적인"해라고 부르는 것을 확립하기 위해 더 많은 데이터를 필요로한다는 것을 암시하며, 아직 그것을 추구하지는 않았습니다. 두 번째 항목은 더 많은 미스테리였다. 처음에는 원래의 차트가 주 대신에 월별 데이터를 보여주고 있었기 때문에 비닝의 인공물이라고 생각했지만 데이터를 가까이에서 보았을 때 보류되지 않았습니다. 테네시의 Google 트렌드 페이지에서 내 그래프를 두 번 확인했는데 동의했습니다. 불일치의 원인을 발견하기를 바랬다.
주정부 정렬
위의 차트는 Graph Builder에서 Group Wrap 역할을 사용하여 상태를 알파벳순으로 그리드에 배치합니다. 완전한 제어를 위해 각 상태에 행과 열 값을 할당하고 그 값을 그룹 Y 및 그룹 X 역할에 사용했습니다.

원본 차트를 근사치로 만들기 위해 오버레이 된 선에서 부드럽게 처리 된 영역 차트로 전환했습니다. (나는 아직도 몇 주에서 몇 달로 변환하지 않았기 때문에 바를 만들지 않았다. 또는 Google 트렌드에서 월간 데이터를 얻을 수있는 방법이있을 수있다.) 내 주 중 일부가 원래 주에있는 다른 주처럼 보일 정도로 충분했다. 원래의 테네시와 오하이오는 제 사우스 다코타와 노스 다코타처럼 보입니다. 오리지널 펜실베니아는 오레곤과 흡사합니다. 다행히도, 나에게 어떤 패턴이 생겼습니다. 원래 차트의 상태는 알파벳순으로 하나씩 사라졌습니다.
어쨌든. 더 깊은 연구 끝에, 나는 오직 국가 후 컬럼비아 특별구는 하나씩 떨어져있었습니다. 우리의 차트는 다른 주들에 동의했습니다. 우연히도 DC 데이터를 두 번 다운로드 한 데이터에서 비슷한 오류가 발생했으며 초기 차트는 전에 DC. 기묘한. 약간 후에 트위터 메시지 , 저자는 나의 발견을 확인하고 Wonk Blog 포스트 그래프와 해설을 신속하게 업데이트했다.
데이터 크기 조정
Google 트렌드의 데이터에서 각 주가의 관심도는 최대 값이 100이되도록 조정됩니다. 즉, 작은 배수 차트로 기대할 수있는 것처럼 규모가 국가마다 다를 수 있음을 의미합니다. 이 경우에는 단지 패턴 (예 : 뾰족 함) 만 비교할 수 있습니다.
어떻게 국가 데이터를 동일한 규모로 변환 할 수 있습니까? 미국 전체에 대한 Google 트렌드 페이지에는 각 주에 대한 요약 수준 목록이 포함되어 있습니다. 이러한 요약이 각 주 평균 값을 나타내면 축척 계수를 사용하여 조정할 수 있습니다. 다음은 모든 주를 공통 척도로 한 결과입니다.

주의 사항 노스 캐롤라이나의 고향 상태를 더 진실 된 포지셔닝으로 만들려고 내 디자인의 다른 상태 레이아웃을 사용했습니다. 크기가 동일한 직사각형의 제약 조건 내에서 모든 지리적 특성을 보존하는 것은 불가능합니다. 원본 차트의 레이아웃은 Jon Schwabish의 PolicyViz 전체적인 모양이 나라의 전체 모양과 닮았다는 좋은 성질을 가지고 있습니다.
많은 곡선의 두께를 감안할 때, 주 패턴의 큰 그림보기를 허용하는 것 외에도 셀의 영역을 앵커링하고 레이블을 명확하게 만드는 데 도움이되는 주 평균 값을 기반으로 배경색을 추가했습니다.

통찰력 확보
원크 블로그 기사를 통해 Google 트렌드 데이터가 실제 추세를 대표하지 않을 수도 있음을 알았지 만 분석을 다시 실행하여 원래 기사와 그래프에서 얻을 수 없었던 몇 가지 통찰력을 얻었습니다.
- 일부 주에서는 상당한 해마다 변동이 있습니다.
- 매월 대 주간 집계가 문제가 될 수 있습니다.
- 다코타 스파이크는 정말 높습니다 (내 스케일링이 올바르다면)
그래프와 분석을 자체적으로 재 작성하는 것이 항상 실용적인 것은 아니지만 실제로 데이터의 미묘한 차이를 이해하는 가장 좋은 방법입니다.
알렉산더 무 쓴 :
그레이트 포스트! 배경을 색칠하기 위해 평균을 사용하면 재미있을 것 같습니다!
데이터 세트를 공유 하시겠습니까?
잔 그레그 쓴 :
과연. 그들은 텍스트에 대한 사본 편집기와 사실 검사기를 가지고 있지만, 데이터와 그래프는 더 심각한 품질 문제를 나타냅니다.
로버트 앨리슨 쓴 :
이것은 좋은 물건이다, Xan! 킨다 (Kinda)는 전국 뉴스 소스의 다른 많은 그래프에 데이터 무결성 오류가 있는지 궁금하게 생각합니다.
