グラフを再作成することは私の趣味です。それは両方とも私がの限界をテストするのを助けます JMP そして私自身のデータ処理と視覚化のスキルを磨きます。今回は、3番目の利点がありました。それは、公開されているチャートで重大なデータエラーを見つけることです。
私は最近、この興味深い蚊の傾向チャートを記事の一部として見ました。蚊があなたの状態に噛み付くようになるときワシントンポストのワンクブログで。その州ごとの単語「蚊」のグーグル検索の傾向を、それぞれの州は異なる縮尺で示しています。
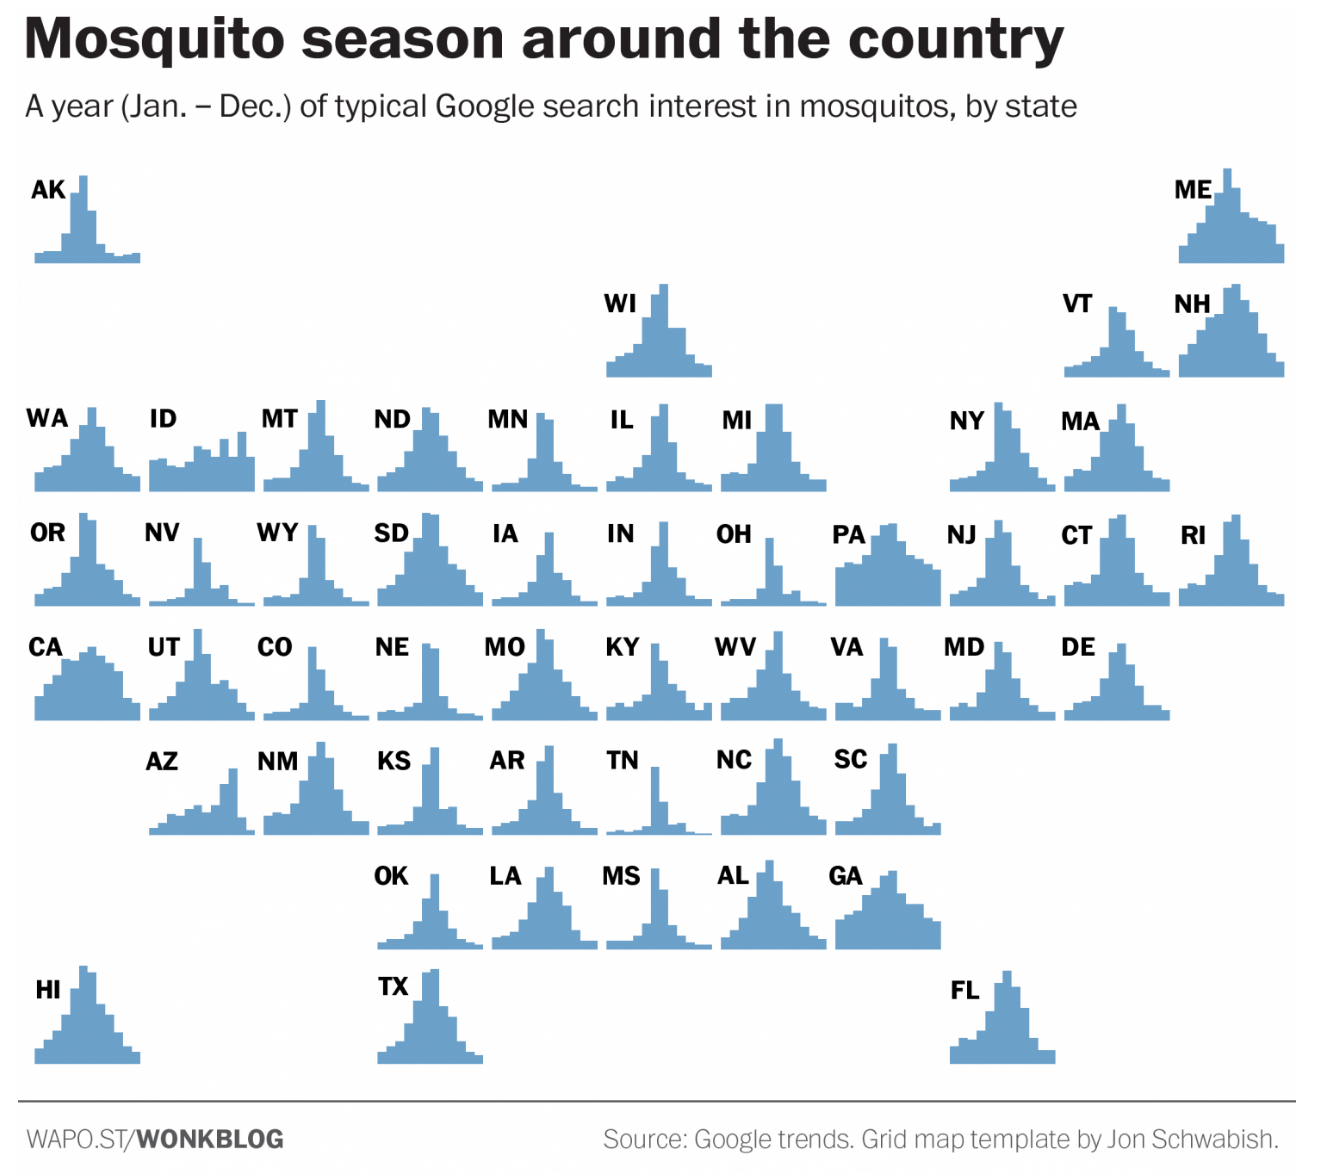
これは典型的な分析グラフではありませんが、レイアウトはGraph Builderの小さい倍数のグループ化の良いテストになると思いました。そして、私は地理的パターンの全体的な欠如に興味をそそられました。例えば、この記事では、テネシー州は近隣諸国と非常に違っていると述べており、他の州についても同じことが言えます。地図を使用する主なポイントは地理的パターンを表示することですが、ここでは接続がかなり弱いです。
データを取得する
この記事には、Google Trendsのページへのリンクが含まれています。蚊の傾向そのページは、米国全体の CSVとしてダウンロードメニュー項目。
しかし、データを取得することで得意とするところがそこにあります。それぞれの州の傾向は別々のページにあります、ダウンロードのための別々のURLはありません、そしてCSVファイルは本当に純粋なCSVファイルではありません。少なくとも州のURLはパターンに従っていたので、私はWebブラウザの別々のタブで各州を開くためのスクリプトを書きました。それから私は手動でクリックしなければなりませんでした CSVとしてダウンロード各タブのメニュー項目。各「CSV」は、説明文と複数の埋め込みテーブルを含む規則的なパターンに従っていました。スニペットの例
Web Search interest: Mosquito

Wisconsin (United States) 2014-2015
Interest over time
Week,Mosquito
2014-01-05 - 2014-01-11,4
2014-01-12 - 2014-01-18,3
2014-01-19 - 2014-01-25,4
...
2015-12-27 - 2016-01-02,4

Top metros for Mosquito
Metro,Mosquito
Duluth MN-Superior WI,100
Wausau-Rhinelander WI,85
幸いなことに、JMPのテキストインポートウィザードで、何行スキップし何行読むかを教えてください。ウィザードで一度やった後、私は生成されたスクリプトを見て、同じ方法で他のファイルを読むためにそれをループに入れることができました:
Open( "report (" || Char(i) || ").csv",
   Columns( Column( "Week", Character), Column( "Mosquito") ),
   Import Settings( Column Names Start( 5 ),
      Data Starts( 6 ), Lines To Read( 104 ) )
);
これらすべてを実行し、最初のフィールドを別々の開始日と終了日に分割した後、すべてのテーブルを、州データをすべて含む1つの大きなテーブルに連結することができます。
データを最初に見て
この小さな倍数の折れ線グラフには、すべてのデータが年ごとに重ねて表示されています。

地理的な配置はありませんが、元のものと比較するのに十分な数がすでに見られるので、2つの機能が際立っていました。
- 時々年は州(特にアリゾナとハワイ)の中でかなり異なっていました。
- テネシー州は、オリジナルのとがった癖がありません。
最初の観察結果は、この記事が「典型的な」年と呼ぶものを確立するために、おそらくさらに何年ものデータが必要であることを示唆しています、そして私はまだそれを追求していません。2番目の項目はもっと謎でした。元のグラフでは週ごとではなく月ごとにデータが表示されていたため、最初はビンニングの成果物だと思っていましたが、データを詳しく見ていくうちにそれは保持できませんでした。私のグラフをTennesseeのGoogle Trendsページと二重チェックしたところ、彼らは同意しました。矛盾の原因を発見することを望みながら、私は続けました。
状態を整える
上のチャートはGraph BuilderのGroup Wrapロールを使用して、グリッド内の状態をアルファベット順にレイアウトしています。完全に制御するために、各状態に行と列の値を割り当て、それらの値をグループYとグループXの役割で使用しました。

元のチャートに近づけるために、オーバーレイラインからスムーズエリアチャートに切り替えました。(週を月に変換していないのでバーを使用しませんでした - またはGoogle Trendsから月ごとのデータを取得する方法があるかもしれません)。オリジナルのテネシーとオハイオは私のサウスダコタとノースダコタによく似ています。オリジナルのペンシルベニアは私のオレゴンとよく似ています。幸いなことに、パターンが私に起こりました。元のチャートの状態はアルファベット順に1つずれています。
とにかく、ほとんど。さらなる研究の後、私は州だけに気づきました後にコロンビア特別区は1つずつずれていた。私達の図表は他の州に同意した。偶然にも、DCデータを2回ダウンロードしたときに私のデータにも同様のエラーがあり、最初のチャートが1つずれていました前 DC 変です。いくつかの後 Twitterのメッセージ 、著者は私の調査結果を確認し、すぐにWonk Blogの投稿グラフと解説を更新した。
データのスケーリング
Google Trendsのデータでは、各州の関心度は最大値が100になるように調整されています。それはあなたが小さい倍数グラフで期待するように大きさが州から州へと匹敵しないことを意味します。この場合、まさにパターン(例えば、スパイク)を比較することができる。
状態データを同じスケールに変換するにはどうすればよいですか。米国全体のGoogleトレンドページには、各州の概要レベルのリストが含まれています。これらの要約が各州の平均値を表す場合は、スケールファクタを使用して調整できます。これはすべての州で共通の規模での結果です。

また、ノースカロライナ州の自宅の状態をより正確なものにしようとして、自分の設計とは異なる州のレイアウトを使用しています。等しいサイズの長方形の制約内で、すべての地理的特性を保持することは不可能です。元のチャートのレイアウトはJon Schwabish氏によるものです。 PolicyViz そして全体的な形が国の全体的な形に似ているという素晴らしい性質を持っています。
多くの曲線が細いため、州の平均値に基づいた背景色を追加しました。これは、年間パターンの全体像を可能にするだけでなく、セル内の領域を固定し、ラベルを明確にするのに役立ちます。

得られた洞察
Wonk Blogの記事では、Google Trendsのデータは現実のトレンドを表すものではないことが明らかになっていますが、分析をやり直すと、元の記事とグラフから得られなかったいくつかの洞察が得られます。
- 月ごとの集計と週ごとの集計が問題になる可能性があります。
- Dakotaのスパイクは非常に高い(私のリスケーリングが正しい場合)
私たちがグラフや分析を自分で作り直すことは必ずしも現実的ではないことを私は認識していますが、それは本当にデータのニュアンスを理解するための素晴らしい方法です。
アレクサンダーモウ書きました:
素晴らしい投稿!平均を使って背景を着色するのは面白いですね。
データセットを共有してもいいですか?
Xan Gregg 書きました:
確かに。彼らはコピーエディタとテキストのファクトチェッカを持っています(そうではありません)が、データとグラフはより難しい品質の問題を提示します。
ロバートアリソン書きました:
これはいいことです、Xan!- Kindaは、全国のニュースソースの他のグラフにデータ整合性エラーがあることを不思議に思います。
