Grafiken neu zu erstellen, ist ein Hobby von mir. Beides hilft mir, die Grenzen von zu testen JMP und schärft meine eigenen Datenhandhabungs- und Visualisierungsfähigkeiten. Diesmal gab es einen dritten Vorteil: das Auffinden eines erheblichen Datenfehlers im veröffentlichten Diagramm.
Ich habe kürzlich diese interessante Mückentrends-Chart als Teil eines Artikels gesehen. “ Wenn die Mücken in Ihrem Staat beißen “Im Wonk-Blog der Washington Post. Es zeigt die Google-Suchtrends für das Wort "Moskito" nach Bundesstaat, wobei jeder Bundesstaat in einem anderen Maßstab liegt.
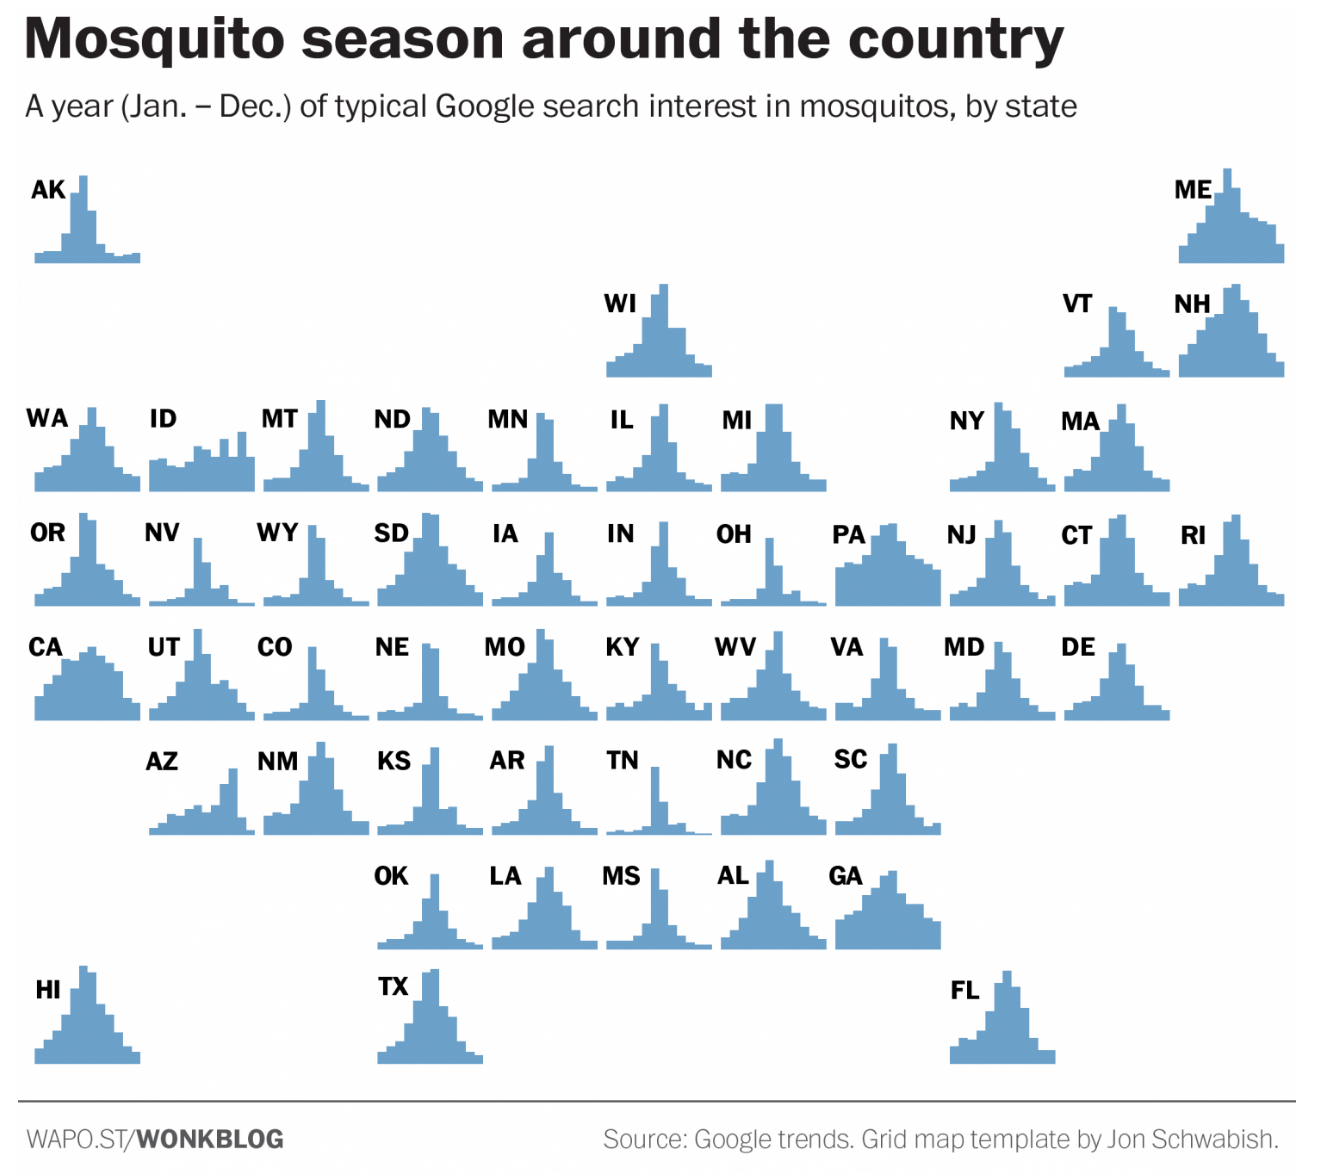
Es ist kein typisches analytisches Diagramm, aber ich dachte, das Layout wäre ein guter Test für die kleine Multiples-Gruppierung von Graph Builder, und ich war fasziniert vom generellen Mangel an geographischen Mustern. In dem Artikel wurde beispielsweise erwähnt, dass Tennessee so anders ist als seine Nachbarn, und dasselbe gilt für andere Staaten. Bei der Verwendung einer Karte werden hauptsächlich geografische Muster verwendet. Die Verbindungen sind hier jedoch recht schwach.
Daten abrufen
Der Artikel enthält einen Link zur Google Trends-Seite für Mückentrends für die ganzen Vereinigten Staaten, und diese Seite hat schön eine Als CSV herunterladen Menüpunkt.
Hier endet jedoch die Freundlichkeit, um die Daten zu erhalten. Jeder Zustandstrend befindet sich auf einer separaten Seite, es gibt keine separate URL für den Download und die CSV-Datei ist nicht wirklich eine reine CSV-Datei. Zumindest die Status-URLs folgten einem Muster. Daher schrieb ich ein Skript, um jeden Status in einem separaten Tab in einem Webbrowser zu öffnen. Dann musste ich manuell klicken Als CSV herunterladen Menüpunkt für jede Registerkarte. Jede „CSV“ folgte einem regulären Muster, das beschreibenden Text und mehrere eingebettete Tabellen enthielt. Ein Beispielausschnitt:
Web Search interest: Mosquito

Wisconsin (United States) 2014-2015
Interest over time
Week,Mosquito
2014-01-05 - 2014-01-11,4
2014-01-12 - 2014-01-18,3
2014-01-19 - 2014-01-25,4
...
2015-12-27 - 2016-01-02,4

Top metros for Mosquito
Metro,Mosquito
Duluth MN-Superior WI,100
Wausau-Rhinelander WI,85
Glücklicherweise ließ mich der Textimport-Assistent von JMP sagen, wie viele Zeilen zu überspringen und wie viele zu lesen sind. Nachdem ich es einmal im Assistenten gemacht hatte, sah ich mir das generierte Skript an und konnte es in eine Schleife schreiben, um die anderen Dateien auf dieselbe Weise zu lesen:
Open( "report (" || Char(i) || ").csv",
   Columns( Column( "Week", Character), Column( "Mosquito") ),
   Import Settings( Column Names Start( 5 ),
      Data Starts( 6 ), Lines To Read( 104 ) )
);
Nachdem ich all das getan und das erste Feld in separate Start- und Enddaten aufgeteilt hatte, konnte ich die gesamte Tabelle zu einer großen Tabelle zusammenfassen, die alle Statusdaten enthielt, dh zwei Jahre wöchentliche Daten.
Sehen Sie sich zuerst die Daten an
Wir können alle Daten in diesem kleinen Multi-Line-Diagramm, das pro Jahr überlagert ist, ziemlich gut sehen.

Wir haben nicht die geographische Anordnung, aber wir können schon genug sehen, um es mit dem Original zu vergleichen, und zwei Merkmale fielen mir auf:
- Manchmal waren die Jahre innerhalb eines Staates (insbesondere in Arizona und Hawaii) sehr unterschiedlich.
- Tennessee hat nicht die Schärfe des Originals.
Die erste Beobachtung legt nahe, dass wir wahrscheinlich mehr Daten benötigen, um festzustellen, was der Artikel als "typisches" Jahr bezeichnet, und ich habe das noch nicht verfolgt. Der zweite Punkt war eher ein Rätsel. Anfangs dachte ich, es sei ein Artefakt des Binning, da der ursprüngliche Chart nicht Monat für Monat Daten anzeigt, aber das hielt nicht an, als ich mir die Daten näher ansah. Ich habe mein Diagramm mit der Google Trends-Seite für Tennessee verglichen und sie waren einverstanden. Ich fuhr fort und hoffte, die Ursache der Diskrepanz zu entdecken.
Arrangieren der Staaten
Im obigen Diagramm wird die Gruppenumbruch-Rolle in Graph Builder verwendet, um die Zustände in einem Raster alphabetisch anzuordnen. Zur vollständigen Kontrolle habe ich jedem Zustand einen Zeilen- und Spaltenwert zugewiesen und diese Werte in den Rollen der Gruppe Y und Gruppe X verwendet.

Um mich dem ursprünglichen Diagramm anzunähern, wechselte ich von den überlagerten Linien zu geglätteten Flächendiagrammen. (Ich habe keine Bars gemacht, weil ich immer noch nicht versucht habe, Wochen in Monate zu konvertieren - oder vielleicht gibt es eine Möglichkeit, monatliche Daten von Google Trends zu erhalten.) Es war genug zu bemerken, dass einige meiner Bundesstaaten im Original wie andere Bundesstaaten aussahen. Das ursprüngliche Tennessee und Ohio ähneln meinem South Dakota und North Dakota sehr; das ursprüngliche Pennsylvania sieht meinem Oregon sehr ähnlich. Zum Glück fiel mir ein Muster ein. Die Zustände der ursprünglichen Karte sind alphabetisch nicht angegeben!
Fast sowieso. Nach weiterem Studium realisierte ich nur die Zustände nach dem District of Columbia war um eins weg. Unsere Charts stimmten in den anderen Staaten überein. Zufällig hatte ich auch einen ähnlichen Fehler in meinen Daten, wo ich die DC-Daten zweimal heruntergeladen hatte, und meine ursprünglichen Diagramme waren um eins versetzt Vor DC. Seltsam. Nach ein paar Twitter-Nachrichten , bestätigte der Autor meine Ergebnisse und aktualisiert schnell die Grafiken und Kommentare des Wonk Blog-Posts.
Daten skalieren
In den Daten von Google Trends wird das Zinsniveau jedes Staates so skaliert, dass der Maximalwert 100 beträgt. Dies bedeutet, dass die Größen nicht von Staat zu Staat vergleichbar sind, wie Sie es von einem kleinen Mehrfachchart erwarten würden. In diesem Fall können nur die Muster (z. B. Stacheligkeit) verglichen werden.
Wie kann ich die Zustandsdaten auf dieselbe Skala konvertieren? Die Google Trends-Seite für die gesamten USA enthält eine Liste mit Zusammenfassungsebenen für jeden Bundesstaat. Wenn diese Zusammenfassungen den Durchschnittswert jedes Staates darstellen, können wir die Anpassung mit einem Skalierungsfaktor vornehmen. Hier ist das Ergebnis mit allen Zuständen auf einer gemeinsamen Skala.

Ich habe auch ein anderes State-Layout meines eigenen Designs verwendet und versucht, meinem Heimatstaat North Carolina eine wahrhaftere Positionierung zu geben. Innerhalb der Einschränkungen von gleich großen Rechtecken können nicht alle geografischen Eigenschaften beibehalten werden. Das Layout in der Originalkarte ist von Jon Schwabish bei PolicyViz und hat die schöne Eigenschaft, dass die Gesamtform der Gesamtform des Landes ähnelt.
Angesichts der Dünnheit vieler Kurven habe ich eine Hintergrundfarbe basierend auf dem Durchschnittswert des Bundesstaates hinzugefügt, die nicht nur einen Überblick über das Jahresmuster ermöglicht, sondern auch die Bereiche in ihren Zellen verankert und die Kennzeichnung klarer macht.

Erkenntnisse gewonnen
Obwohl im Wonk Blog-Artikel deutlich gemacht wird, dass die Google-Trends-Daten möglicherweise keine realen Trends darstellen, habe ich durch ein erneutes Analysieren der Analyse ein paar Erkenntnisse gewonnen, die ich aus dem ursprünglichen Artikel und der Grafik nicht erhalten konnte:
- In einigen Bundesländern gibt es erhebliche Abweichungen von Jahr zu Jahr.
- Monatliche versus wöchentliche Aggregation kann ein Problem darstellen.
- Die Zustandsdaten wurden um den Maximalwert normalisiert.
- Die Dakota-Spikes sind wirklich hoch (wenn meine Skalierung richtig ist)
Ich weiß, dass es nicht immer praktisch ist, eigene Remakes von Graphen und Analysen durchzuführen, aber es ist eine großartige Möglichkeit, die Nuancen der Daten wirklich zu verstehen.
