Recréer des graphiques est un de mes passe-temps. Cela m'aide à tester les limites de JMP et affine mes propres compétences en matière de traitement et de visualisation des données. Cette fois, il y avait un troisième avantage: trouver une erreur de données significative dans le graphique publié.
J'ai récemment vu ce tableau de tendances intéressant sur les moustiques dans le cadre d'un article intitulé « Quand les moustiques vont mordre dans votre état , ”Sur le blog Wonk du Washington Post. Il montre les tendances de recherche Google pour le mot «moustique» par État, chaque État étant à une échelle différente.
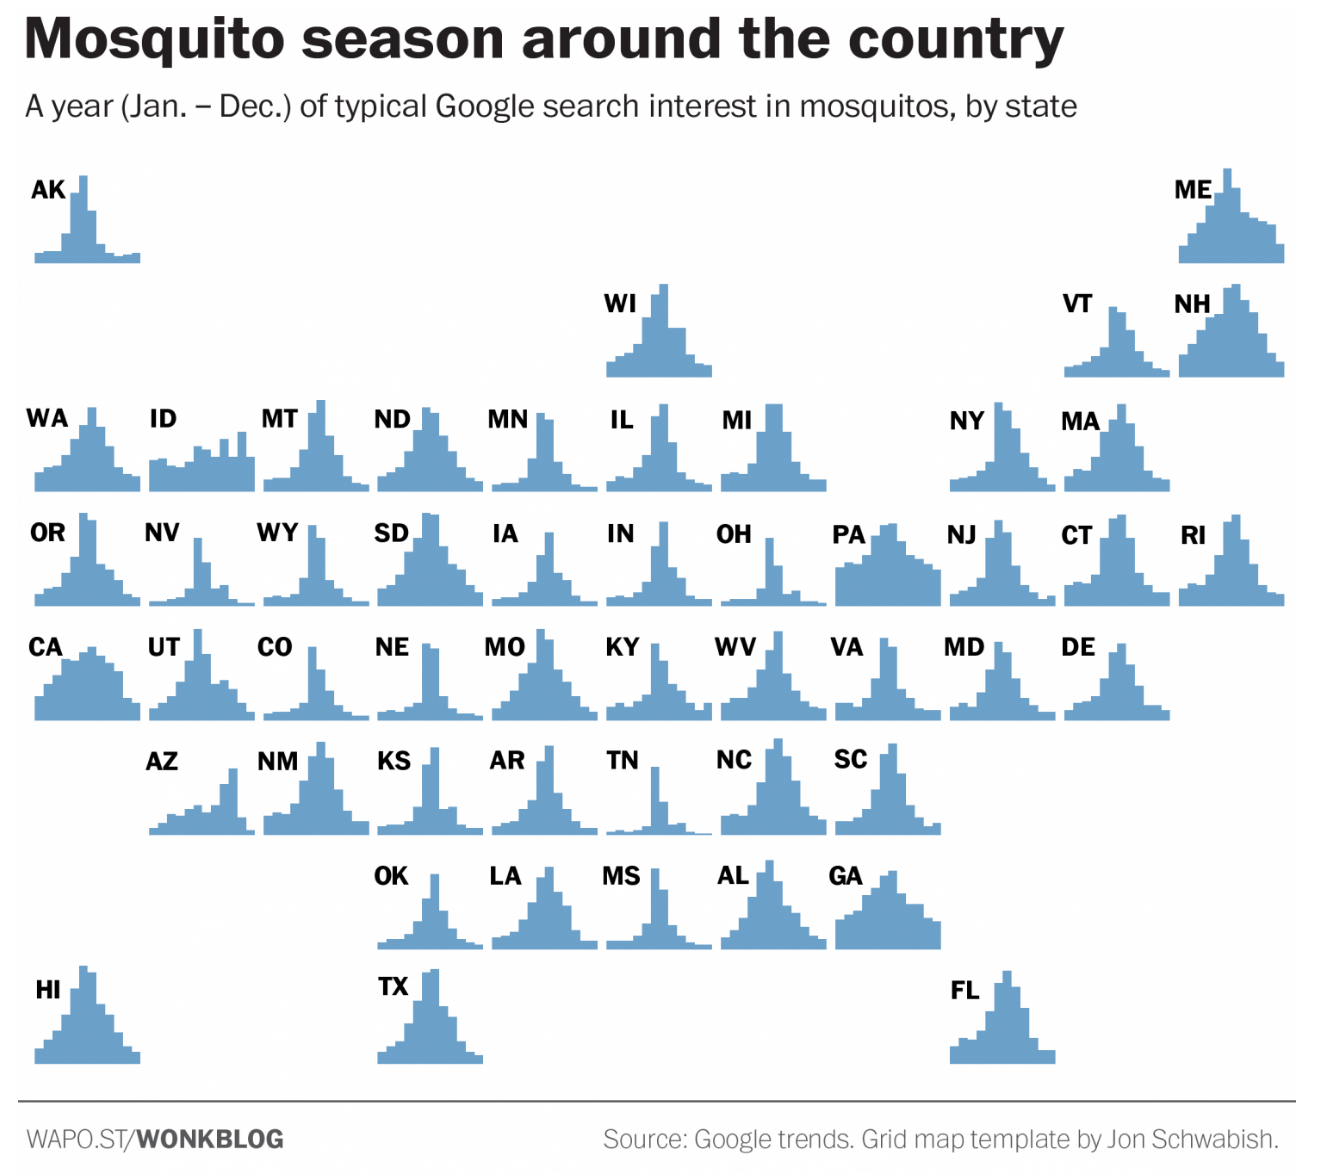
Ce n'est pas un graphique analytique typique, mais je pensais que la présentation constituerait un bon test du groupe de petits multiples de Graph Builder, et le manque général de motif géographique m'a intrigué. Par exemple, l'article mentionnait que le Tennessee était si différent de ses voisins et on pouvait en dire autant des autres États. Le point principal de l'utilisation d'une carte est de montrer les schémas géographiques, mais les connexions sont assez faibles ici.
Obtenir les données
L’article inclut joliment un lien vers la page Google Trends pour les tendances des moustiques pour l'ensemble des États-Unis, et cette page a bien une Télécharger en format CSV élément du menu.
Cependant, c'est là que se termine la gentillesse pour obtenir les données. Chaque tendance d'état est sur une page distincte, il n'y a pas d'URL distincte pour le téléchargement, et le fichier CSV n'est pas vraiment un fichier CSV pur. Au moins, les URL d'état suivaient un modèle, alors j'ai écrit un script pour ouvrir chaque état dans un onglet distinct d'un navigateur Web. Ensuite, j'ai dû cliquer manuellement sur le Télécharger en format CSV élément de menu pour chaque onglet. Chaque “CSV” suivait un modèle régulier comprenant du texte descriptif et plusieurs tableaux incorporés. Un exemple d'extrait de code:
Web Search interest: Mosquito

Wisconsin (United States) 2014-2015
Interest over time
Week,Mosquito
2014-01-05 - 2014-01-11,4
2014-01-12 - 2014-01-18,3
2014-01-19 - 2014-01-25,4
...
2015-12-27 - 2016-01-02,4

Top metros for Mosquito
Metro,Mosquito
Duluth MN-Superior WI,100
Wausau-Rhinelander WI,85
Heureusement, l'assistant d'importation de texte de JMP m'a permis d'indiquer le nombre de lignes à ignorer et le nombre de lignes à lire. Après l'avoir fait une fois dans l'assistant, j'ai regardé le script généré et j'ai pu le mettre en boucle pour lire les autres fichiers de la même manière:
Open( "report (" || Char(i) || ").csv",
   Columns( Column( "Week", Character), Column( "Mosquito") ),
   Import Settings( Column Names Start( 5 ),
      Data Starts( 6 ), Lines To Read( 104 ) )
);
Après avoir fait tout cela et divisé le premier champ en dates de début et de fin distinctes, je pouvais concaténer toute la table en une grande table contenant toutes les données d'état, soit deux années de données hebdomadaires.
Premier regard sur les données
Nous pouvons voir assez bien toutes les données dans ce graphique à courbes à multiples multiples superposé par année.

Nous n'avons pas l'arrangement géographique, mais nous pouvons déjà en voir assez pour pouvoir comparer avec l'original, et deux caractéristiques m'ont été révélées:
- Parfois, les années étaient très différentes dans un État (surtout en Arizona et à Hawaii).
- Le Tennessee n'a pas le piquant de l'original.
La première observation suggère que nous avons probablement besoin de plus de données d'années pour établir ce que l'article appelle une année «typique», ce que je n'ai pas encore fait. Le deuxième élément était plus un mystère. Au départ, je pensais que c’était un artefact de la catégorisation puisque le graphique original montrait des données par mois plutôt que par semaine, mais cela n’a pas résisté lorsque j’ai regardé les données de plus près. J'ai vérifié deux fois mon graphique par rapport à la page Google Trends du Tennessee et ils ont accepté. J'ai continué en espérant découvrir la source de la différence.
Arranger les États
Le graphique ci-dessus utilise le rôle Group Wrap de Graph Builder pour organiser les états dans une grille par ordre alphabétique. Pour un contrôle total, j'ai affecté à chaque état une valeur de ligne et de colonne et utilisé ces valeurs dans les rôles des groupes Y et X.

Pour tenter de rapprocher le graphique d'origine, je suis passé des lignes superposées aux graphiques en zones lissées. (Je n'ai pas fait de barres parce que je n'ai toujours pas essayé de convertir des mois en mois - ou peut-être qu'il existe un moyen d'obtenir des données mensuelles de Google Trends.) C'était suffisant pour remarquer que certains de mes états ressemblaient à d'autres états dans l'original. Le Tennessee et l’Ohio d’origine ressemblent beaucoup à mon Dakota du Sud et du Dakota du Nord; la Pennsylvanie originale ressemble beaucoup à mon Oregon. Heureusement, un motif m'a traversé l'esprit. Les états du graphique d'origine sont décalés d'un ordre alphabétique!
Presque, en tout cas. Après une étude plus approfondie, je me suis rendu compte que les États après District de Columbia ont été désactivés par un. Nos cartes ont convenu sur les autres états. Par coïncidence, j'ai également eu une erreur similaire dans mes données où j'avais téléchargé les données DC deux fois, et mes cartes initiales étaient décalées d'un point. avant DC Bizarre. Après quelques Messages Twitter , l’auteur a confirmé mes conclusions et a rapidement mis à jour le graphique et le commentaire du blog de Wonk.
Mise à l'échelle des données
Dans les données de Google Trends, les niveaux d’intérêt de chaque État sont mis à l’échelle, de sorte que la valeur maximale est de 100. Cela signifie que les grandeurs ne sont pas comparables d’un État à l’autre comme on peut s’y attendre avec un petit graphique multiple. Seuls les motifs (par exemple, les pointes) peuvent être comparés dans ce cas.
Comment puis-je convertir les données d'état sur la même échelle? La page Google Trends pour l’ensemble des États-Unis comprend une liste de niveaux de synthèse pour chaque État. Si ces résumés représentent la valeur moyenne de chaque État, nous pouvons effectuer l'ajustement avec un facteur d'échelle. Voici le résultat avec tous les états sur une échelle commune.

Remarquez que j’ai également utilisé une mise en page différente de celle de mon propre dessin, en essayant de donner à mon État de Caroline du Nord un positionnement plus vrai. Dans les limites imposées par les rectangles de taille égale, il est impossible de conserver toutes les propriétés géographiques. La mise en page dans le tableau original est de Jon Schwabish à PolicyViz et a la belle propriété que la forme globale ressemble à la forme globale du pays.
Compte tenu de la finesse de nombreuses courbes, j'ai ajouté une couleur de fond basée sur la valeur moyenne de l'état, ce qui permet non seulement de donner une vue d'ensemble du motif annuel, mais aussi d'ancrer les zones dans leurs cellules et de rendre le libellé plus clair.

Insights Gain
L'article de Wonk Blog indique clairement que les données de Google Trends ne sont peut-être pas représentatives des tendances du monde réel. En reprenant l'analyse, j'ai acquis quelques informations que l'article et le graphique d'origine ne m'avaient pas permis d'obtenir:
- Certains États ont une variation significative d'une année à l'autre.
- L'agrégation mensuelle ou hebdomadaire peut être un problème.
- Les données d'état ont été normalisées par la valeur maximale.
- Les pointes Dakota sont vraiment élevées (si ma remise à l'échelle est correcte)
Je me rends compte que ce n’est pas toujours pratique de faire nos propres remakes de graphiques et d’analyses, mais c’est un excellent moyen de vraiment comprendre les nuances des données.
