當我在中西部(準確地說是密蘇里州哥倫比亞)長大時,調味薯片是我的最愛。 雖然我更喜歡酸奶油和洋蔥,但燒烤會在緊要關頭做。 想像一下,當我的同事 Ryan Lekivetz 告訴我我們北方的鄰居有一系列全新的薯片口味可供嘗試時,我會很高興!
想像一下,當我發現兩種最受歡迎的口味是番茄醬和蒔蘿泡菜時,我的失望。
“Blech,”我告訴瑞恩。
“你這麼說只是因為名字,”他回答道。
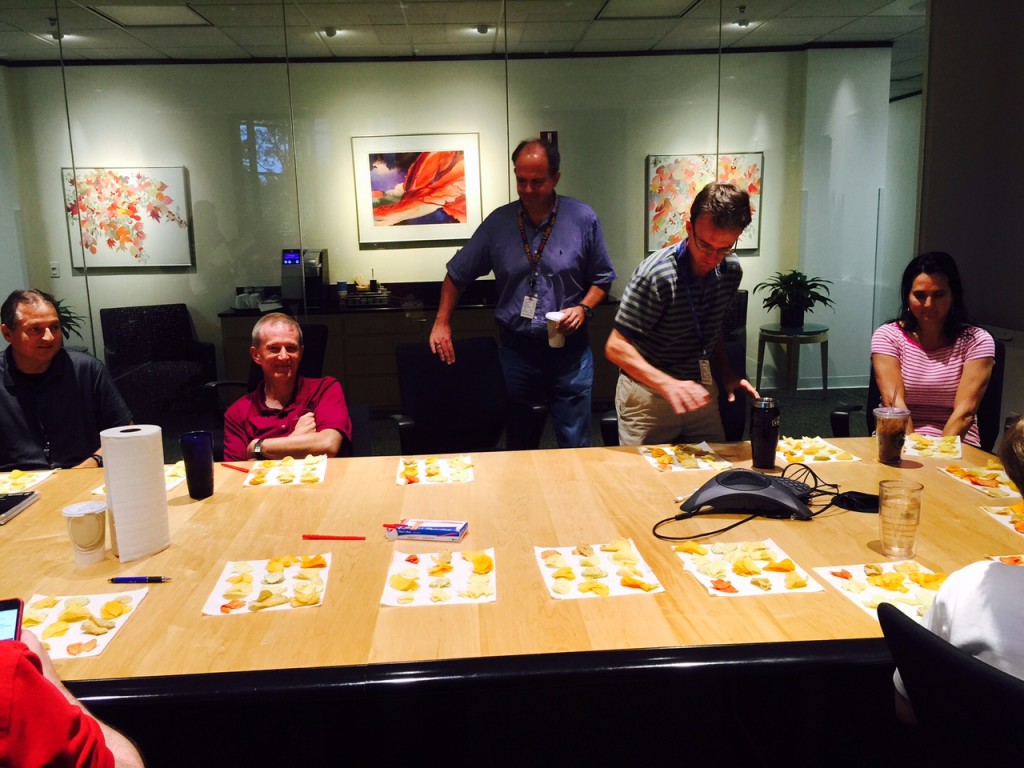
在我們的選擇實驗中,JMP 工作人員自願品嚐了 10 種不同口味的薯片。
因此,正如統計學家所說,我們同意根據設計實驗.
我們選擇了 10 種薯片口味,包括加拿大蒔蘿泡菜和加拿大番茄醬,並請人們進行比較。 因為我們與來自美國的志願者一起工作,所以我們決定混合一些美國的最愛,比如燒烤和我心愛的酸奶油和洋蔥,但我們也會使用樂事給我們調味薯條,看看加拿大薯條如何與其他不熟悉的口味相抗衡。 最後,我們為志願者品嚐了 10 種不同類型的薯片:
紐約魯本南方餅乾和肉汁西海岸松露薯條希臘城陀螺番茄醬全部穿著蒔蘿泡菜南方熱火燒烤燒烤酸奶油和洋蔥就像與巧克力大減價,我們覺得讓人們品嚐 10 塊薯片並按最佳到最差排序太難了。 相反,我們需要一個設計好的實驗,將 10 個芯片分成可管理的組。 這裡的轉折是,我們不僅會要求每個組中的“最佳”或“最喜歡”,而且還會要求每個組中的“最差”或“最不喜歡”。 這將允許我們執行最大差異(或最大差異分析),另一種類型選擇分析這將使我們能夠從每個選擇任務中獲得更多信息。
Ryan 在他的博客文章中解釋了他是如何開發實驗設計的:薯片重擊:美國與加拿大. Ryan 的設計給了我們四組薯片,每組有三片薯片可供品嚐。 和以前一樣,有三個不同的調查,給了我們更多的比較總數。 我們召集了 30 名志願者來進行品嚐(這比我們上次的實驗要花更多的時間,我們讓我們的志願者品嚐巧克力)。 然後,是時候分析了。
分析
可以分析 MaxDiff 模型,就好像受訪者做出兩個選擇一樣。 首先,他們選擇提供的最佳選擇。 其次,他們選擇最差的。 每一個都被視為一個單獨的選擇。 然後,每個受訪者為他或她展示的每組籌碼做出兩個選擇。 在數據中,我們用每個選擇集的兩組條目來表示這一點:
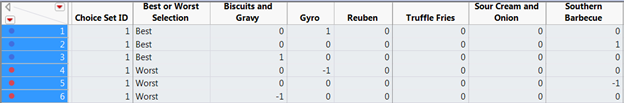
如果我們關注選擇集 ID 1,我們會看到三行是最佳選擇,三行是最差選擇。 我們用指標變量來告訴JMP哪些籌碼在集合中。 對於代表最佳選擇的行,指標用 1 編碼。 對於代表最差選擇的行,指標用 -1 編碼。 每個指標列在選擇模型中作為連續變量輸入,因此 JMP 被迫使與“最差選擇”行關聯的參數等於與“最佳選擇”行關聯的參數的負值。
在模型對話框中,我們確保將“Best or Worst Selection”列(告知行是與最佳選擇還是最差選擇相關聯的列)添加到分組列中:
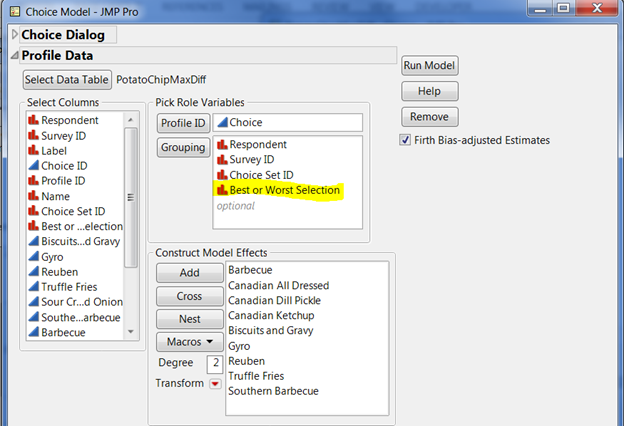
我們還必須選擇一種風格作為比較風格,並將其指標排除在模型之外(就像使用任何一組虛擬編碼列一樣)。 在這種情況下,我比較了酸奶油和洋蔥。
為了獲得從最佳風味到最差風味的排名,我對生成的報告進行了排序(右鍵單擊並選擇“按列排序”)。 燒烤和南方燒烤接近頂部。 似然比檢驗是測試參數是否與 0 顯著不同,因此在這種情況下,風味是否與酸奶油和洋蔥顯著不同。 看起來這兩種熟悉的燒烤口味是最受歡迎的,而 Gyro 絕對落後於其他口味。
可視化結果
我還創建了一個結果圖(右鍵單擊估計表並選擇“製作成數據表”。 然後我打開 Graph Builder 並按照步驟操作在這篇博文中描述.

如果我們僅使用圖表,松露薯條是僅次於燒烤口味的下一個最受歡迎的口味,其次是餅乾和肉汁。 加拿大風味接近底部,但統計測試告訴我們,如果我們對不同的人(或同一個人在不同的一天)進行抽樣,這些風味可能會排序更高。
那麼,誰是對的?
也許我們倆都是對的。 也許我只是對“番茄醬片”這個名字做出反應。也許如果我在盲測中品嚐其中一種,我會像酸奶油和洋蔥一樣喜歡它們。 也許如果我在加拿大長大,我會比燒烤更喜歡它們。
不過,如果 Gyro 贏得了“做我們的味道“ 挑戰。
