 Muchos JMP los usuarios obtienen sus datos de las bases de datos.
Hace algunos lanzamientos, introdujimos un diálogo de importación de asistente interactivo para facilitar la importación desde archivos de texto. En una versión posterior, creamos una función que le permite importar tablas de páginas web en tablas de datos JMP. En JMP 11, introdujimos un asistente interactivo para simplificar la importación de datos de hojas de cálculo de Excel, cubriendo funcionalidades como ir a través de pestañas y apilar grupos de columnas. Pero había un área que aún no habíamos mejorado: facilitar la importación de datos desde bases de datos, hasta ahora.
Entonces, ¿cuáles son los problemas a resolver? Los datos de las bases de datos generalmente significan una gran cantidad de datos de muchas tablas diferentes. Para obtener los datos que desea, debe unirse y filtrar, algo que requiere demasiado conocimiento sobre los datos y demasiada experiencia con el lenguaje SQL.
Lo sorprendente de cómo una base de datos almacena los datos es su regularización, de modo que los mismos datos no se dupliquen en varias tablas. Hay tres grandes ventajas para esto:
1. Dado que los datos no se duplican, hay menos espacio de almacenamiento desperdiciado.
2. Actualizar un campo es una cuestión de actualizar un lugar en lugar de muchos.
3. Los datos son naturalmente más consistentes.
Las bases de datos están organizadas para un almacenamiento eficiente y transacciones eficientes, pero no generalmente para un acceso de análisis eficiente.
A menudo, los datos que necesita analizar se encuentran dispersos en varias tablas. Debe unirse a ellos para obtener lo que necesita, lo que puede hacer un trabajo significativo.
Puede importar todos los datos de cada tabla y luego unirlos dentro de JMP, pero hay dos razones por las que este no es el mejor método. Primero, generalmente no necesita todos los datos de cada tabla, por lo que pierde tiempo y espacio cuando importa más de lo que necesita. En segundo lugar, es una carga especificar cómo unir las tablas.
Alternativamente, puede usar SQL para especificar una unión y luego seleccionar las filas y columnas para importar. Si bien esto facilita un uso más eficiente del hardware, no siempre es fácil, ya que tiene que aprender SQL, familiarizarse con los detalles de cada tabla y escribir y depurar el código SQL para enviar a la base de datos.
Pero JMP puede ayudarte a hacer todas estas cosas con facilidad.
Las bases de datos están organizadas para ayudar con el acceso. Cada tabla generalmente tiene una clave principal para identificar de forma única cada fila de la tabla. La tabla también tiene "claves externas", que son columnas creadas para que coincidan con las claves primarias de otras tablas; esto relaciona esa tabla con otras tablas. La unión típica es entonces una "unión externa", que hace coincidir la clave externa en una tabla con la clave primaria en otra tabla. Esta es una combinación de uno a muchos (externa), ya que una clave externa puede no ser única, pero una clave primaria es exclusiva de su tabla.
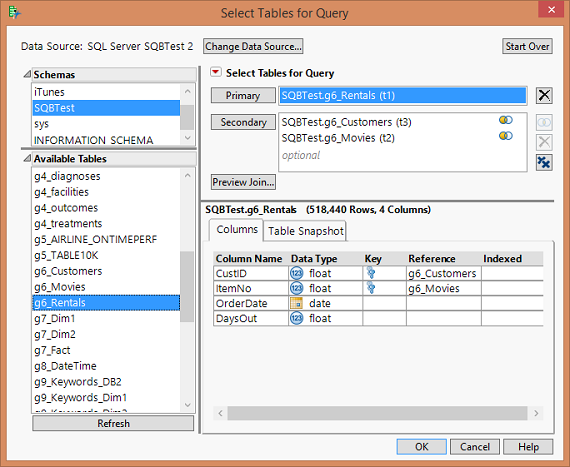
En JMP, el nuevo cuadro de diálogo Generador de consultas está organizado para facilitar este proceso. Primero, especifique la tabla principal, aquella cuyas filas forman la unidad de análisis. Esta tabla primaria usualmente tendrá columnas designadas como claves externas. Simplemente especifique algunas tablas secundarias, y de repente, la unión se vuelve obvia y automática.
A continuación, debe seleccionar las variables y las filas para mantener. La selección de las variables es fácil en el Generador de consultas: selecciónelas de una lista que muestra la tabla de la que proviene cada variable, junto con el tipo de datos. La selección de filas implica especificar filtros, pero esto también es fácil. Query Builder recupera todas las categorías para las variables categóricas y los rangos para las variables continuas, y luego presenta los controles para que pueda elegir solo las categorías y los rangos que desee.
Pero se pone aún mejor, ya que Query Builder va varios pasos más allá. Puede previsualizar cualquier tabla o salida de combinación prospectiva directamente en la ventana de diálogo. También puede examinar el código SQL resultante, además de guardar la consulta en un archivo para poder usarla nuevamente para obtener los datos. Cuando guarda la consulta, puede especificar que algunas de las condiciones de filtrado se configuren para solicitarle, de modo que la próxima vez que ejecute la consulta, pueda cambiar las categorías o rangos que especifique para filtrar los datos.
Puedes leer sobre Query Builder en esta entrada de blog de Eric Hill, el desarrollador principal de la instalación.
Vivimos en la era del big data, y la mayoría de estos datos se almacenan en bases de datos. Facilitar la obtención de estos datos en un análisis ayuda a convertir "big data" en "grandes estadísticas".
Nota: Esto es parte de un Grandes estadisticas Serie de publicaciones del blog de John Sall. Leer todo su Grandes publicaciones de estadísticas .
