 たくさんの JMP ユーザーはデータベースからデータを取得します。
数リリース前に、テキストファイルからのインポートを簡単にするための対話型のウィザードインポートダイアログを導入しました。その後のリリースでは、WebページテーブルをJMPデータテーブルにインポートできる機能を作成しました。JMP 11では、Excelスプレッドシートからのデータのインポートを簡単にするための対話型ウィザードを導入しました。タブ間の移動や列の積み重ねなどの機能について説明しました。しかし、まだ改善すべきことが1つありました。データベースからデータをインポートすることをより簡単にすることです。
それでは解決すべき問題は何ですか?データベースからのデータは通常、さまざまなテーブルからの豊富なデータを意味します。必要なデータを取得するには、結合してフィルタリングする必要があります。データについての知識が多すぎ、SQL言語に関する専門知識が多すぎる必要があります。
データベースがデータをどのように格納するかについての驚くべきことは、それがいかに正規化されているかであるので、同じデータが複数のテーブルにわたって重複することはありません。これには3つの大きな利点があります。
1。データが重複していないため、無駄になるストレージスペースが少なくなります。
2。フィールドを更新することは、多くの場所ではなく1箇所を更新することです。
3。データは当然より一貫性があります。
データベースは効率的なストレージと効率的なトランザクションのために編成されていますが、通常は効率的な分析アクセスのためには編成されていません。
多くの場合、分析する必要があるデータは複数のテーブルに分散しています。あなたは必要なものを得るために彼らを参加させなければなりません、そしてそれは重要な仕事のために作ることができます。
各テーブルからすべてのデータをインポートしてJMP内で結合することもできますが、これが最善の方法ではない理由は2つあります。まず、各テーブルからすべてのデータが必要なわけではないため、必要以上にインポートすると時間とスペースが無駄になります。第二に、テーブルをどのように結合するかを指定することは負担です。
あるいは、SQLを使用して結合を指定してから、インポートする行と列を選択することもできます。これによりハードウェアの効率的な使用が可能になりますが、SQLを学び、各テーブルの詳細に精通し、データベースに送信するSQLコードを作成してデバッグする必要があるため、必ずしも容易ではありません。
しかし、JMPはこれらすべてを簡単に実行するのに役立ちます。
データベースはアクセスを助けるために編成されています。各テーブルには通常、テーブルの各行を一意に識別するための主キーがあります。このテーブルには「外部キー」もあります。これは、他のテーブルの主キーと一致するように作成された列です。これは、そのテーブルを他のテーブルに関連付けます。その場合、典型的な結合は「外部結合」であり、あるテーブルの外部キーを別のテーブルの主キーと照合します。外部キーは一意ではない可能性がありますが、主キーはその表に対して一意であるため、これは1対多(外部)結合です。
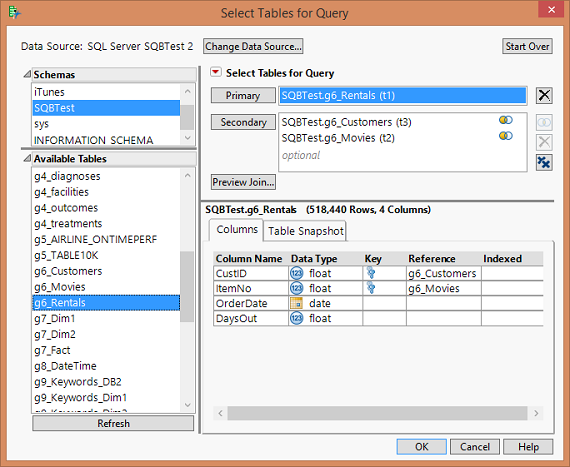
JMPでは、このプロセスを容易にするために新しいQuery Builderダイアログが編成されています。最初に、行が分析単位を構成する1次表を指定します。この主テーブルには通常、外部キーとして指定された列があります。二次テーブルを指定するだけで、突然、結合が明白かつ自動的になります。
次に、保持する変数と行を選択する必要があります。Query Builderでは変数を選択するのは簡単です。各変数の元となるテーブルとデータ型を示すリストからそれらを選択します。行を選択するにはフィルタを指定する必要がありますが、これも簡単です。Query Builderは、カテゴリカル変数のすべてのカテゴリと連続変数の範囲を取得してから、必要なカテゴリと範囲だけを選択できるようにコントロールを表示します。
しかし、Query Builderはさらにいくつかのステップを踏むので、さらに良くなります。ダイアログウィンドウで任意のテーブルまたは将来の結合出力をプレビューできます。結果のSQLコードを調べることもできます。また、クエリをファイルに保存して、データを取得するために再度使用することもできます。クエリを保存するときに、いくつかのフィルタ条件を設定してプロンプトを表示するように指定して、次回クエリを実行するときに指定したカテゴリまたは範囲を変更してデータをフィルタすることができます。
あなたはについて読むことができますこのブログ記事のクエリービルダー施設の主任開発者であるEric Hillから。
私たちはビッグデータの時代に生きており、このデータの大部分はデータベースに格納されています。このデータを分析に取り入れやすくすることで、「ビッグデータ」を「ビッグ統計」に変えることができます。
注意: これはの一部です大きな統計 John Sallによる一連のブログ投稿。彼のすべてを読むビッグ統計の投稿 。
