 Molti JMP gli utenti ottengono i loro dati dai database.
Alcune versioni fa, abbiamo introdotto una finestra di dialogo di importazione della procedura guidata interattiva per semplificare l'importazione da file di testo. In una versione successiva, abbiamo creato una funzione che consente di importare tabelle di pagine Web in tabelle di dati JMP. In JMP 11, abbiamo introdotto una procedura guidata interattiva per semplificare l'importazione di dati da fogli di lavoro Excel, che coprono tali funzionalità come passare da una scheda all'altra e raggruppare gruppi di colonne. Ma c'era un aspetto che dovevamo ancora migliorare: semplificare l'importazione dei dati dai database, fino ad ora.
Quindi quali sono i problemi da risolvere? I dati dai database di solito indicano un'abbondanza di dati da molte tabelle diverse. Per ottenere i dati che desideri, devi unirti e filtrarli, qualcosa che richiede troppa conoscenza dei dati e troppa esperienza con il linguaggio SQL.
La cosa sorprendente di come un database memorizza i dati è quanto è regolarizzata, in modo che gli stessi dati non vengano duplicati su più tabelle. Ci sono tre enormi vantaggi a questo:
1. Poiché i dati non sono duplicati, c'è meno spazio di archiviazione sprecato.
2. L'aggiornamento di un campo è una questione di aggiornamento di un posto anziché di molti.
3. I dati sono naturalmente più coerenti.
I database sono organizzati per l'archiviazione efficiente e le transazioni efficienti, ma non di solito per un accesso efficiente all'analisi.
Spesso i dati che devi analizzare sono sparsi su più tabelle. Devi unirti a loro per ottenere ciò di cui hai bisogno, il che può portare a un lavoro significativo.
Potresti semplicemente importare tutti i dati da ciascuna tabella e poi unirli a JMP, ma ci sono due ragioni per cui questo non è il metodo migliore. In primo luogo, di solito non hai bisogno di tutti i dati di ogni tabella, quindi perdi tempo e spazio quando importi più del necessario. In secondo luogo, è un onere specificare come unire le tabelle insieme.
In alternativa, è possibile utilizzare SQL per specificare un join e quindi selezionare le righe e le colonne da importare. Mentre questo rende più efficiente l'uso dell'hardware, non è sempre facile dal momento che devi imparare SQL, familiarizzare con i dettagli di ogni tabella, e scrivere e debuggare il codice SQL da inviare al database.
Ma JMP può aiutarti a fare tutte queste cose con facilità.
I database sono organizzati per aiutare con l'accesso. Ogni tabella di solito ha una chiave primaria per identificare in modo univoco ogni riga della tabella. La tabella ha anche "chiavi esterne", che sono colonne create per far corrispondere le chiavi primarie in altre tabelle - questo riporta la tabella ad altre tabelle. Il join tipico è quindi un "outer join", che corrisponde alla chiave esterna in una tabella alla chiave primaria in un'altra tabella. Si tratta di un join (esterno) one-to-many, poiché una chiave esterna potrebbe non essere univoca, ma una chiave primaria è univoca per la sua tabella.
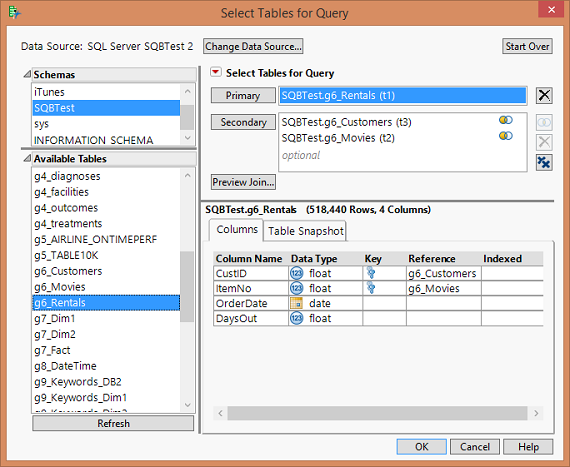
In JMP, la nuova finestra di dialogo Query Builder è organizzata per semplificare questo processo. Innanzitutto, si specifica la tabella primaria, quella le cui righe costituiscono l'unità di analisi. Di solito questa tabella primaria ha colonne designate come chiavi esterne. Basta specificare alcune tabelle secondarie e, improvvisamente, l'unione diventa ovvia e automatica.
Successivamente, è necessario selezionare le variabili e le righe da conservare. La selezione delle variabili è semplice in Query Builder: selezionale da un elenco che mostra la tabella da cui proviene ciascuna variabile, insieme al tipo di dati. Selezionare le righe implica specificare i filtri, ma anche questo è facile. Query Builder recupera tutte le categorie per le variabili categoriali e gli intervalli per le variabili continue, quindi presenta i controlli in modo da poter selezionare solo le categorie e gli intervalli desiderati.
Ma diventa ancora meglio, dal momento che Query Builder va più avanti. È possibile visualizzare l'anteprima di qualsiasi tabella o output di join potenziali nella finestra di dialogo. È inoltre possibile esaminare il codice SQL risultante, inoltre è possibile salvare la query in un file in modo da poterlo utilizzare nuovamente per ottenere i dati. Quando si salva la query, è possibile specificare che alcune delle condizioni di filtro siano impostate su richiesta, in modo che al successivo avvio della query sia possibile modificare le categorie o gli intervalli specificati per filtrare i dati.
Puoi leggere Generatore di query in questo post del blog da Eric Hill, lo sviluppatore principale della struttura.
Viviamo nell'era dei big data e la maggior parte di questi dati è archiviata in database. Facilitare l'inserimento di questi dati in un'analisi aiuta a trasformare i "big data" in "grandi statistiche".
Nota: Questo fa parte di a Grandi statistiche serie di post sul blog di John Sall. Leggi tutti i suoi Messaggi di statistiche grandi .
