 Beaucoup JMP les utilisateurs obtiennent leurs données des bases de données.
Il y a quelques versions, nous avons introduit une boîte de dialogue d'importation avec un assistant interactif pour faciliter l'importation depuis des fichiers texte. Dans une version ultérieure, nous avons créé une fonctionnalité qui vous permet d'importer des tables de pages Web dans des tables de données JMP. Dans JMP 11, nous avons introduit un assistant interactif visant à simplifier l'importation de données à partir de feuilles de calcul Excel, couvrant des fonctionnalités telles que la navigation dans les onglets et l'empilement de groupes de colonnes. Mais il y avait un domaine que nous devions encore améliorer: faciliter l'importation de données à partir de bases de données - jusqu'à maintenant.
Alors, quels sont les problèmes à résoudre? Les données des bases de données signifient généralement une abondance de données provenant de nombreuses tables différentes. Pour obtenir les données que vous souhaitez, vous devez rejoindre et filtrer, ce qui nécessite trop de connaissances des données et une trop grande expertise du langage SQL.
La chose étonnante dans la manière dont une base de données stocke les données est sa régularisation, de sorte que les mêmes données ne soient pas dupliquées sur plusieurs tables. Il y a trois avantages énormes à cela:
1. Comme les données ne sont pas dupliquées, il y a moins d'espace de stockage gaspillé.
2 La mise à jour d'un champ consiste à mettre à jour un lieu au lieu de plusieurs.
3 Les données sont naturellement plus cohérentes.
Les bases de données sont organisées pour un stockage efficace et des transactions efficaces, mais généralement pas pour un accès efficace aux analyses.
Les données que vous devez analyser sont souvent dispersées sur plusieurs tables. Vous devez les rejoindre pour obtenir ce dont vous avez besoin, ce qui peut générer un travail considérable.
Vous pouvez simplement importer toutes les données de chaque table, puis les joindre dans JMP, mais il y a deux raisons pour lesquelles ce n'est pas la meilleure méthode. Tout d'abord, vous n'avez généralement pas besoin de toutes les données de chaque table. Vous perdez donc du temps et de l'espace lorsque vous importez plus que nécessaire. Deuxièmement, il est difficile de spécifier comment joindre les tables.
Vous pouvez également utiliser SQL pour spécifier une jointure, puis sélectionner les lignes et les colonnes à importer. Bien que cela rend l'utilisation du matériel plus efficace, ce n'est pas toujours facile, car vous devez apprendre le SQL, vous familiariser avec les détails de chaque table et écrire et déboguer le code SQL à envoyer à la base de données.
Mais JMP peut vous aider à faire tout cela facilement.
Les bases de données sont organisées pour faciliter l'accès. Chaque table a généralement une clé primaire pour identifier de manière unique chaque ligne de la table. La table a également des «clés étrangères», qui sont des colonnes créées pour correspondre aux clés primaires dans d'autres tables - cela relie cette table à d'autres tables. La jointure typique est alors une «jointure externe», qui associe la clé étrangère d'une table à la clé primaire d'une autre table. Il s'agit d'une jointure un-à-plusieurs (externe), car une clé étrangère peut ne pas être unique, mais une clé primaire est unique dans sa table.
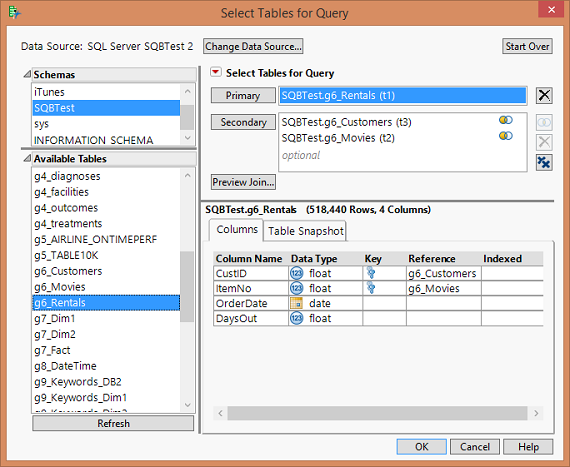
Dans JMP, la nouvelle boîte de dialogue Générateur de requêtes est organisée pour faciliter ce processus. Tout d’abord, vous spécifiez la table primaire, celle dont les lignes constituent l’unité d’analyse. Les colonnes de cette table primaire sont généralement désignées comme clés étrangères. Spécifiez simplement quelques tables secondaires et, tout à coup, la jointure devient évidente et automatique.
Ensuite, vous devez sélectionner les variables et les lignes à conserver. Il est facile de sélectionner les variables dans Query Builder. Sélectionnez-les dans une liste affichant la table d'où provient chaque variable, ainsi que le type de données. La sélection de lignes implique la spécification de filtres, mais cela est également facile. Query Builder récupère toutes les catégories de variables catégorielles et les plages de variables continues, puis présente des contrôles vous permettant de sélectionner uniquement les catégories et les plages souhaitées.
Mais cela s’améliore encore, puisque Query Builder va encore plus loin. Vous pouvez prévisualiser n'importe quelle table ou sortie de jointure potentielle directement dans la fenêtre de dialogue. Vous pouvez également examiner le code SQL résultant et enregistrer la requête dans un fichier afin de pouvoir l'utiliser à nouveau pour obtenir les données. Lorsque vous enregistrez la requête, vous pouvez spécifier que certaines des conditions de filtrage doivent être définies pour vous y inciter, de sorte que vous puissiez modifier les catégories ou les plages que vous spécifiez pour filtrer les données.
Vous pouvez lire sur Générateur de requêtes dans cet article de blog d’Eric Hill, principal développeur de l’installation.
Nous vivons à l'ère du Big Data, et la plupart de ces données sont stockées dans des bases de données. Faciliter l'intégration de ces données dans une analyse permet de transformer les «grandes données» en «grandes statistiques».
Remarque: Cela fait partie d'un Big Statistics série d'articles de blog de John Sall. Lire tout son Big statistiques posts .
