A un recente Costruire modelli migliori seminario, qualcuno mi ha chiesto: "Se hai un fattore che ha una relazione curva con una risposta, è possibile utilizzare un modello di albero decisionale per modellare tale relazione?" Per dimostrare che questo è effettivamente possibile, ho creato un semplice set di dati simulato con 200 righe, in base al modello
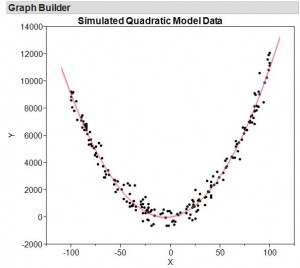
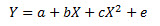 dove un , B , c sono costanti, e e è una variabile casuale distribuita normalmente. Un grafico dei dati, insieme al modello di regressione quadratica adattato, è mostrato in Figura 1.
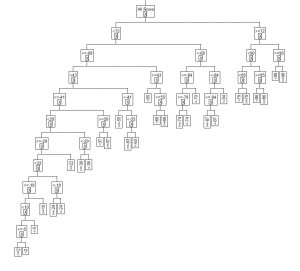
Quindi che aspetto ha un modello di albero decisionale quando è montato su questi dati? Per scoprirlo, ho usato il Partizione piattaforma (Analizza> Modellazione> Partizione) per adattare un albero decisionale semplice. Una vista compatta del modello dell'albero decisionale è in Figura 2.
Esaminando una trama del modello adattato (Figura 3), vediamo che la forma del modello quadratico generale viene catturata dal modello dell'albero decisionale. All'interno dell'intervallo dei dati X (-100 <100), questo modello fa previsioni molto simili al modello quadratico. In effetti, entrambi i modelli hanno gli stessi errori di predizione media e R 2 per entrambi i modelli è 0.98. Questo è bello perché gli alberi decisionali non fanno alcuna ipotesi sulla forma della relazione tra la Y e la X.
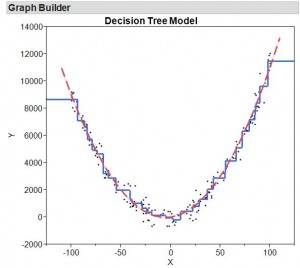
È importante sapere che il modello di albero decisionale si adattava in questo caso al modello più grande / più complesso possibile, con l'unica restrizione che ogni nodo terminale dell'albero doveva disporre di un minimo di cinque punti dati. Il rumore in questi dati è relativamente piccolo rispetto alla variabilità complessiva di questi dati, il che spiega il motivo per cui sia i modelli quadratici che i modelli di partizione possono avere una buona adattabilità.
Ma cosa succede se abbiamo dati molto più rumorosi? Considerare un secondo set di dati simulato dallo stesso modello quadratico, ma in cui la deviazione standard dell'errore casuale è 10 volte maggiore. È possibile visualizzare il modello quadratico adattato e il modello dell'albero decisionale completo sovrapposti ai dati in Figura 4.
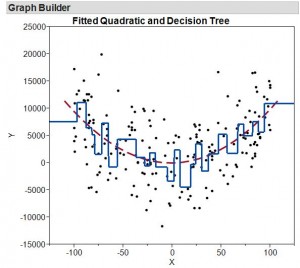
In questo caso, l'albero decisionale non sembra più catturare bene la natura quadratica dei dati. Questo perché il modello di partizione è sovradattamento. Troppo l'errore casuale presente nei dati viene assegnato al modello, il che risulta in un modello troppo complesso.
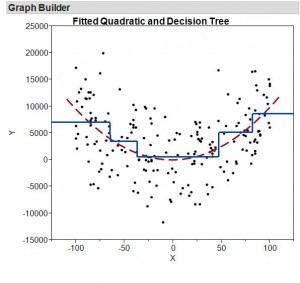
Per costruire un modello di albero decisionale migliore che catturerà la natura essenziale dei dati senza sovradattamento, useremo un blocco casuale del 20% dei dati come set di validazione per aiutare a scegliere automaticamente la dimensione del modello di albero decisionale. Questa è una funzionalità integrata JMP Pro , la versione analitica avanzata di JMP. Il modello risultante è stato scelto in base al set di validazione e ha solo cinque nodi terminali. La sovrapposizione di questo modello di albero decisionale più semplice (Figura 5) mostra che l'albero delle decisioni sta ora acquisendo la natura quadratica complessiva dei dati. Quindi, la risposta alla domanda originale è ancora "sì" e JMP Pro ti aiuta a farlo in modo rapido e automatico.
Eric Cai ha scritto:
Ciao Sam,
Grazie per questo post molto chiaro e informativo. Potresti spiegare per quale motivo hai usato la convalida di holdout invece della convalida incrociata? La convalida di holdout non è incline alla variazione da cui i dati sono stati mantenuti come set di validazione? La convalida incrociata può superare questa variazione e questo è il metodo di convalida che uso di solito. Sarei lieto di conoscere i vantaggi della convalida di holdout.
Grazie per il tuo tempo.
Eric
